开学季选课系统高并发请求的缓冲设计,核心思路就是三个字:排队、分流、暂存。 把瞬间涌进来的请求先挡住,放进一个安全的缓冲区,再慢慢消化,数据库就不会直接面对几百人同时抢同一门课的暴力场景。
为什么选课系统需要缓冲层
开学选课,等于全校学生在同一秒挤同一个门,教务系统如果直接让每个请求去查数据库、写选课记录,数据库连接池很快就见底了,业内专家指出,大部分高性能系统都不是硬扛高并发,而是用缓冲把尖峰削平,缓冲层本质是给系统穿上防弹衣,让数据库从被围攻变成按节奏工作。
缓冲层解决三个问题:第一,保护数据库资源;第二,保证请求不丢失;第三,让用户获得明确反馈,没有缓冲的选课系统,轻则页面转圈,重则服务器宕机,上一届的选课惨案就是这么来的。
选课系统高并发请求的缓冲设计核心组件有哪些
缓冲不是单一技术,而是组合拳,业界公认的缓冲组件主要有以下几种,各自扮演不同角色。
- 消息队列:真正的“排队区”,请求先写入队列,消费者异步下单。
- Redis:缓存热课数据,同时用
setnx做选课幂等,避免重复选课。 - 限流器:控制入口流量,比如令牌桶算法,每秒只放行固定数量请求。
- 数据库连接池:合理设置连接数,避免被打穿。
- 本地内存:在应用层用队列暂存请求,适合单机部署的简单场景。
这些组件可以混搭,小规模学校用Redis加本地队列就能扛住几千人;大规模学校需要引入消息队列,把写入压力拉到最低。
消息队列缓冲和Redis缓存缓冲的对比
很多人会把消息队列和Redis缓存搞混,其实它们解决的是不同层级的问题,消息队列管的是请求的异步化,Redis管的是热数据的快速读取,对比看更清楚:
- 消息队列:擅长处理写请求,我要选这门课”,数据先排队,消费者慢慢写库,一旦队列堆积,用户看到的是“排队中”。
- Redis缓存:擅长处理读请求,这门课还剩多少名额”,把选课结果、课表信息放Redis,数据库读压力大幅降低。
- 实际选课系统里,两者是搭档:先用Redis挡住读流量,再用消息队列消化写流量。
如果只加Redis不加队列,数据库写压力还是很大;只加队列不加Redis,查询会变慢,所以开学季缓冲设计,通常两步都要走。
基于消息队列的选课请求缓冲实操步骤
以最典型的选课动作为例,完整缓冲流程可以拆成六个步骤,每一步都有对应的技术操作。
- 客户端请求先打到网关,网关层做限流,超过阈值的请求直接返回“当前选课人数过多”。
- 通过限流的请求,立即写入消息队列,消息内容包含学生ID、课程ID、操作类型,用Kafka还是RabbitMQ都行,选型看团队熟悉度。
- 消费者服务从队列中拉取消息,先查Redis中的幂等键,如果Key已存在,说明该学生已经提交过这门课的操作,直接丢弃。
- 幂等检查通过,再更新Redis中的课程余量,使用Lua脚本保证原子性。
- 异步写入数据库选课记录,同时更新订单状态。
- 通知服务通过WebSocket或短信告知用户选课结果,前端页面显示“选课成功”或“候选名额已满”。
这个流程里,队列是关键,队列的消费速度要略快于生产速度,避免堆积过多;也要留出弹性容量,应对多波次选课。
队列参数怎么调
几个可验证的参数值得关注,消息队列的批量拉取大小可以设置在100到500条之间,消费者线程数根据数据库瓶颈来定,如果数据库最大连接数是50,消费者线程就控制在40以内,队列积压量超过一万条时,开启第二级消费逻辑,比如把非核心操作降级为延迟处理。
这些参数没有统一标准,但可以通过压测确认,选课季前,用JMeter模拟2000人同时选课,观察队列消费延迟和数据库连接池利用率,把系统调到不崩为止。
用Redis解决选课请求的幂等和超卖
开学季最怕的不是慢,而是出错,多人重复提交选课请求,如果不加缓冲,很容易出现同一门课被选超人数,缓冲设计里,幂等和余量控制靠Redis完成。
幂等键的生成规则是hash(学生ID + 课程ID + 学期),请求进队列前先在Redis里用setnx设置这个键,设置成功才允许入队;设置失败说明已经提交过,直接返回“请勿重复点击”,键的有效期设置30分钟,覆盖选课高峰期的用户重复点击行为。
余量控制采用Redis的decr命令,每成功一个请求,就对课程余量减一,同时用Lua脚本把检查余量和扣减余量合成一个原子操作,避免并发时两个请求同时读到“还剩一个名额”,脚本逻辑大致如下:
- 获取当前余量
- 如果余量小于等于0,返回失败
- 否则执行
decr,返回成功
这个方案在多数高校选课系统中是标配,比直接用数据库行锁做余量更新,性能远高于数据库行锁,能扛住选课高峰的压力。
开学季选课系统缓冲降级方案
高并发请求的缓冲设计再完美,也会遇到压力超预期的情况,这个时候需要降级策略,保证核心业务还能运行。
- 熔断:数据库或Redis响应异常率超过阈值,立刻停止写操作,只保留读缓存,让系统有喘息机会。
- 排队页:当队列积压超过设计上限,网关直接返回静态排队页,不消耗后端资源,用户刷新也不影响。
- 超时重试:消费者调用数据库时设置2秒超时,超时则重试,重试次数不超过3次,避免雪崩。
- 削峰:把非即时性的操作,比如选课后的邮件通知、课程统计,放到低峰期批量处理。
有些高校会把选课分批次,按年级或学院错峰开放,这其实是业务层面的削峰,技术缓冲仍然需要,合理搭配业务分流和技术缓冲,才能应对开学季的极端流量。
开学季选课系统缓冲设计的选型建议
很多开发者会问:我需要全套组件吗?其实取决于学校规模和预算,选型的核心变量是并发量和团队维护成本。
- 并发量在千人左右,单机应用加Redis缓存和本地队列就够用,部署简单,学生选课时把请求写入本地阻塞队列,消费者线程异步处理。
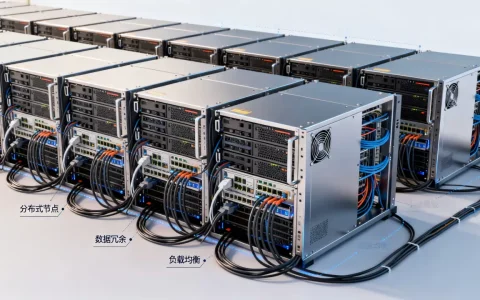
- 并发量在几千到上万人,引入RabbitMQ或Kafka做消息队列,消费者服务单独部署,数据库做好读写分离。
- 并发量达到数万人,则要加分布式限流、多级缓存、分库分表,甚至考虑微服务拆分。
从成本上看,开源组件没有授权费,主要成本在服务器,增加三台普通云服务器就能扛起消息队列和Redis,相比数据库被压垮后紧急扩容,这点投入值得,无论你的学校在哪个城市,缓冲层的部署逻辑都类似,本地机房和云服务器的区别主要在弹性扩缩容的灵活度:云端能快速加节点,本地机房则要求提前备好资源。
开学季选课系统高并发请求缓冲设计常见问题
问:选课系统高并发请求的缓冲设计能不能替代数据库优化?
不能,缓冲只是把压力挡在外面,数据库本身的慢查询、锁竞争问题仍然存在,如果选课业务表没有索引,队列消费再快也会卡在写入阶段,合理的做法是缓冲和数据库优化一起做,为选课表建好联合索引,把大事务拆成小事务。
问:消息队列会不会丢失选课请求?
消息队列自带持久化机制,默认情况下写入队列的消息会落盘,如果担心丢失,可以开启发布确认模式,生产者确认消息到达队列后再响应客户端,消费者处理完消息后手动提交offset,防止处理过程中宕机导致消息丢失。
问:开学季选课系统缓冲设计哪个环节最容易出问题?
最常见的是消费者处理速度跟不上队列生产速度,选课开始时流量瞬间涌入,队列很快积压,消费者产生延迟,排查思路是看队列积压指标和消费者线程池状态,优先增加消费者实例数量,再调整批量拉取参数。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/771828.html