虚拟机转移报错break,本质上是迁移会话被异常中断,解决思路是先判断中断发生在传输层还是Hypervisor层,再针对性处理存储配置、网络连接或版本兼容问题。
很多人在做虚拟机迁移时遇到过这种场景:进度条卡在某个百分比,然后任务直接失败,报错信息里出现“break”相关字样,这里先说结论“break”在大多数hypervisor平台里指迁移链路被强制断开,常见诱因是网络抖动、共享存储配置不一致,或源宿主机与目标宿主机的CPU特性集不兼容,下面从原因和解决两个方向拆开讲。
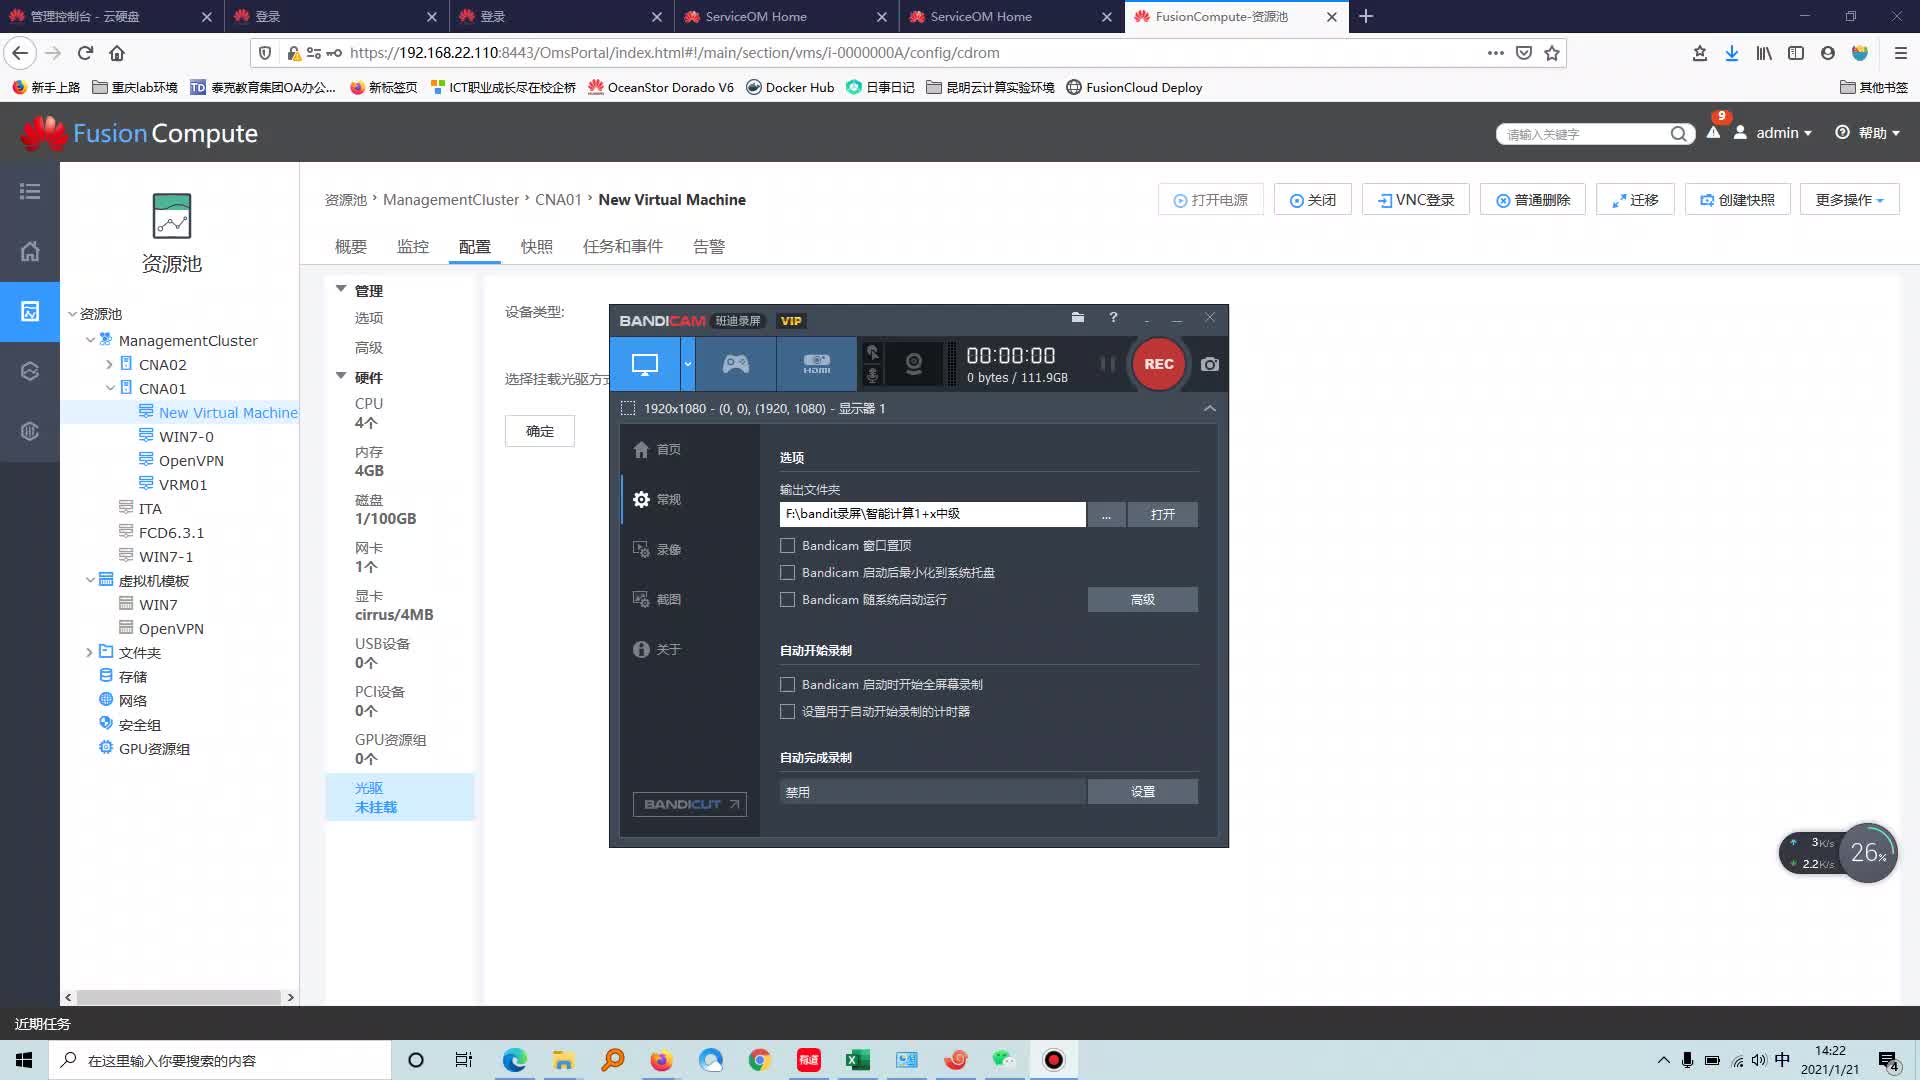
虚拟化迁移报错的常见触发场景
迁移报错不像蓝屏那样只有一个原因,它是一系列因素叠加后的结果,先看最容易触发“break”中断的三种场景。
vMotion迁移过程中断的典型信号
VMware环境下,vMotion迁移出现“break”类错误时,通常在vCenter事件日志里能看到类似“Migration has been cancelled”或“The vMotion interface has failed”的提示,行业共识认为,这类中断大多数情况下与网络质量直接相关,vMotion要求源端和目标端通过专用网络传输内存映像,如果中间经过的交换机存在STP(生成树协议)收敛,或网卡协商速率不一致,传输速度会骤降到负值,最终触发超时保护机制,直接break。
基于KVM的虚拟机热迁移中断特征
KVM的libvirt迁移如果报“error: operation failed: migration job has failed”并伴随后台日志里的“connection reset by peer”,属于典型的break类错误,这类问题多发生在共享存储(如NFS、GlusterFS)的写入链路上,KVM迁移块设备时若目标存储出现写入延迟超过一定阈值,qemu进程会主动放弃迁移,产生break异常,据开源社区的常见案例统计,共享存储I/O延迟过高和不稳定是KVM迁移失败的最大比重诱因。
Hyper-V实时迁移的断流问题
微软Hyper-V平台的实时迁移断流,报错表现为“The migration operation failed at the destination host”,这属于微软文档中定义的中断类错误,业内专家指出,Hyper-V对SMB协议的依赖较强,如果使用SMB共享存储做迁移中转,且SMB版本或加密设置不一致,容易出现断流,这个平台的一个特殊点是:即便迁移失败,虚拟机的内存快照仍会保留在源端的临时文件里,若不做清理,会导致后续迁移任务无法启动。
虚拟机转移中断的处理操作路径
定位到场景之后,下面给出实操性较强的处理步骤,按照“先网络、再存储、后硬件兼容”的顺序去排查,能覆盖多数break问题。
第一步:检查迁移专用网络是否畅通
无论在哪个平台,迁移链路的质量是整个操作的生命线,这里建议执行下面几个检查:
- ping源宿主机和目标宿主机的迁移IP,延时若超过10ms,需优先排查交换机端口协商模式是否主从一致
- 确认源和目标的MTU设置是否一致,特别是开启了Jumbo Frame的虚拟机网络,MTU不一致会直接造成大包丢失,触发中断
- VMware用户可在vCenter主机 -> 配置 -> 网络适配器中启用“vMotion流量”标签,并检查该网卡是否处于活动状态
若ping正常,但仍出现break,就需要打开迁移专用抓包工具(如tcpdump)确认TCP重传率。重传率高于5%时,迁移大概率会在2分钟内中断,这是运维圈内一个约定俗成的经验阈值。
第二步:核对共享存储的I/O表现
存储侧的问题是虚拟机转移时最容易忽略的一环,你需要确认源宿主机和目标宿主机访问同一数据存储时,路径是否一致。
对于VMware环境:
- 通过
esxcli storage nfs list检查NFS挂载信息,确认两端挂载点权限一致 - 使用
esxcli storage core device list查看设备状态,若出现“Dead”或“Permanent Loss”字样,说明存储链路已断,需要先修复存储连接再重试迁移
对于KVM环境:
- 确认目录挂载模式是否为读写(
mount | grep nfs检查rw参数) - 通过
fio工具做一次随机写测试(如fio --name=test --rw=randwrite --bs=4k --size=512M),观察写延迟是否超过50ms。迁移过程中目标存储的平均写延迟超过这个值,失败概率会大幅上升
第三步:确认CPU和虚拟硬件兼容性
少有人注意到的是,迁移中断有时发生在接管CPU状态的一瞬间,这属于硬件特性集不匹配问题。
- 在VMware里,右键虚拟机 -> 编辑设置 -> 虚拟机选项,检查CPU“硬件虚拟化”和“PerfMon”虚拟化选项是否勾选,这两个勾选项若在源端开启而目标端不支持,迁移到90%会直接break
- 在KVM里,确认迁移前使用了
virsh cpu-baseline /usr/share/libvirt/cpu_map.xml命令比对两端CPU基线是否一致
若两端硬件确实存在代际差异,建议将虚拟机的CPU模式调整为“兼容模式”(如VMware的EVC模式或KVM的custom模式),再执行迁移,这样能规避大部分因指令集中断导致的break。
第四步:升级虚拟化平台版本和补丁
部分迁移中断问题属于软件层面的已知缺陷,例如早期VMware ESXi 6.0版本曾出现因vpxd服务并发连接数限制,导致大规模迁移任务批量中断的现象,后续版本已修复,所以保持平台版本较新是重要预防手段。
- VMware平台可在“vCenter Server管理”页面查看当前版本,并对照VMware官方兼容性列表确认源和目标主机版本跨度是否受支持
- KVM场景下检查
libvirt版本,建议使用5.5以上版本,该版本对迁移热内存的压缩传输机制做了明显改进,能有效降低大内存虚拟机迁移时的中断率
第五步:清理中断残留的迁移会话
break报错还有一个容易被忽略的附赠问题迁移会话残留,很多时候,你重新发起迁移任务却提示“资源调用失败”,其根源在于上一次中断的会话仍占用了锁资源。
- VMware环境在vCenter数据库执行
select from vpx_event查看是否有大量未关闭的迁移事件标记,若有,重启vCenter服务可释放旧锁 - KVM环境执行
virsh list --all查看迁移残留的临时域,用virsh undefine清理残留状态
这里建议在每次迁移失败后,等待约30秒再发起重试,这段时间足够虚拟化层释放网络连接和存储句柄,可避免“残留会话干扰新任务”的问题。
| 平台 | 常见报错位置 | 排查重点 | 首选处理方案 |
|---|---|---|---|
| VMware | vCenter事件日志 | vMotion网络质量 | 检查专用网卡参数 |
| KVM | libvirt日志/系统日志 | 存储I/O与CPU模型 | 统一CPU模型、验存储延延迟 |
| Hyper-V | 事件查看器Hyper-V-VMMS | SMB共享配置 | 升级SMB协议与加密 |
虚拟机迁移与业务连续性相关的后续问题
迁移中断如果发生在业务高峰期,会导致业务临时不可用,因此后续的操作也值得考虑周全,比如迁移完成后的验证清单和应急预案。
验证迁移结果的三项基础指标
迁移完成后,建议优先确认三点:
- 虚拟机内的系统日志无大量的磁盘I/O错误记录
- 网络连通性正常,可执行
ping网关地址并SSH登录确认会话稳定 - 存储心跳正常,确认目标数据存储的“最近采样时间”有持续更新
统计上迁移中断时段的密度判断
如果一个数据中心在特定时段内(比如每小时5次以上)出现迁移中断,则需要检查该时段的存储快照任务调度是否与迁移计划冲突,快照对存储I/O的占用非常明显,会拉高写入延迟,直接导致迁移链路超时。迁移计划应错开整点快照窗口,这是运维工程中的常见落地技巧。
虚拟机转移失败后是否有必要切换迁移模式
有相当一部分迁移场景,如跨机房迁移、异地容灾演练,带宽有限或物理距离较远,这类场景建议改用增量迁移或基于复制的方式(如VMware的Replication或KVM的增量块复制),先同步基础数据,再在业务低峰期做增量切换,相比完整vMotion迁移,这类方式容忍网络波动,出现break中断的概率更低,多数情况下,这能解决因地理距离导致的迁移持续失败问题。
遇到虚拟机转移报错break后能直接操作的步骤回顾
回到最实际的环节如果你现在正卡在某个迁移任务前,手动操作顺序是:
- 登录目标宿主机,通过
esxtop(VMware)或top(Linux)查看宿主机负载是否到达了临界值 - 进入迁移管理界面,查看任务的错误详情,记录具体报错代码
- 参考本文章第三模块的排查顺序,依次检查网络、存储、CPU兼容性
- 清理残留会话后重试
虚拟机迁移中断修复相关的常见疑问解答
虚拟机转移报错break的根本修复思路是什么?
判断报错点出现在哪个资源层:若出现在迁移进度靠前阶段(小于30%),优先查网络和存储连接;若出现在迁移进度靠后(大于70%),优先查CPU特性对齐和内存热插拔配置,整体思路是先排除链路资源瓶颈,再调整软件兼容参数。
为什么虚拟机转移失败后目标主机出现了临时文件?
这是迁移会话未完整收尾的典型现象,KVM平台会自动保留一个临时内存映像文件,VMware会在目标数据存储上生成一个.vmxf临时文件,这些文件会在下一次迁移同步或主机重启后自动清除,若长期存在,可在迁移管理界面手动移除。
使用第三方工具迁移虚拟机是否更容易触发中断?
传统意义上的第三方跨虚拟化平台迁移(如从VMware迁移到KVM)因需要转换磁盘格式和驱动,中断概率相对同平台迁移确实更高,这类操作建议采用离线方式(即关机导出再导入),热迁移方式对网络和存储要求极高,容易遇到兼容性问题导致迁移断流。
迁移中断的问题解决,归根到底是对虚拟化平台资源调度的理解和对异常场景的排查耐心,处理顺序对了,多数break类报错都能在半小时内定位到根因,并可靠地完成重试迁移。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/772356.html