一台NTP服务器能带的客户端数量没有固定上限,常规配置下支撑几万到几十万台客户端完全没问题,最终取决于服务器硬件、网络带宽和同步策略的综合设计。
很多运维朋友第一次接触NTP部署,第一反应就是问”我这台服务器能扛多少设备”,这个问题其实没有标准答案,因为NTP协议本身非常轻量,它不像HTTP那样需要维持长连接,也不像数据库那样需要处理复杂事务,一个标准NTP请求包加上响应包,总共也就百来个字节,而且是基于UDP无状态通信,服务器处理完就丢,不占用连接资源,所以单台NTP服务器的容量瓶颈,更多体现在网卡吞吐、CPU处理能力和同步策略配置上,而不是协议本身的限制。
影响NTP服务器容量的核心因素
网络带宽:NTP流量比你想象的小得多
NTP采用客户端-服务器模式,默认轮询间隔从64秒起步,按2的倍数递增,最长可达1024秒,也就是说,每台客户端平均每分钟只发送一到两个NTP请求,我们算一笔账:每个NTP报文是48字节,UDP头8字节,IP头20字节,加起来76字节,即便客户端把轮询间隔卡死在64秒,一台客户端一分钟也就产生大约1.5KB的流量,以千兆网卡为例,理论吞吐是每秒125MB,扣掉协议开销和系统损耗,实际可用带宽打个六折也有75MB/s,照这个算,带宽层面支撑百万级客户端绰绰有余。
但这里有个容易被忽略的坑:NTP响应是广播式的,如果你的网络里有大量客户端同时请求,而服务器又配置了广播或多播模式,那流量会成倍上涨,最常见的模式还是客户端主动轮询,这种模式下服务器只需要按需应答,压力可控。
CPU与内存:真正决定上限的短板
NTP服务进程在Linux下通常是ntpd或chronyd,它们每秒需要处理大量的时间戳计算和报文校验,单核CPU在处理NTP请求时,大约能支撑每秒几万次响应,按每台客户端每64秒请求一次的保守频率算,一个单核CPU就能扛住几十万台客户端,但实际情况是,服务器还要运行别的服务,不能把CPU全让给NTP,所以合理的估算方式是:每1GHz单核CPU大约能支撑10万台以上客户端,这是多数企业自建NTP服务器的容量基准。
内存占用相对固定,ntpd或chronyd的常驻内存一般在几MB到几十MB之间,即便有上百万客户端记录同步状态,内存开销也不会超过几百MB,内存基本不用纳入瓶颈考量。
系统与内核参数:别让默认配置拖后腿
Linux服务器默认的UDP接收缓冲区是128KB,发送缓冲区是256KB,当NTP请求量陡增时,缓冲区溢出会导致丢包,客户端就会报错”server unreachable”,需要修改内核参数:
sysctl -w net.core.rmem_max=1048576
sysctl -w net.core.wmem_max=1048576
sysctl -w net.core.rmem_default=262144
同时查看文件描述符限制,虽然NTP基于UDP不占连接,但服务进程仍需要打开socket,建议通过systemd启动ntpd时,把LimitNOFILE调高到65535。
NTP服务本身的性能调优
ntpd和chronyd在默认配置下都是按”尽力而为”的原则处理请求,但有几个参数能直接改变容量表现:
# /etc/chrony.conf
maxpoll 6        # 客户端最大轮询间隔,默认10,调低可提高精度但增加服务器负载
minpoll 4        # 最小轮询间隔
clientloglimit 1048576  # 客户端日志记录上限,调高能支持更多客户端同时活跃
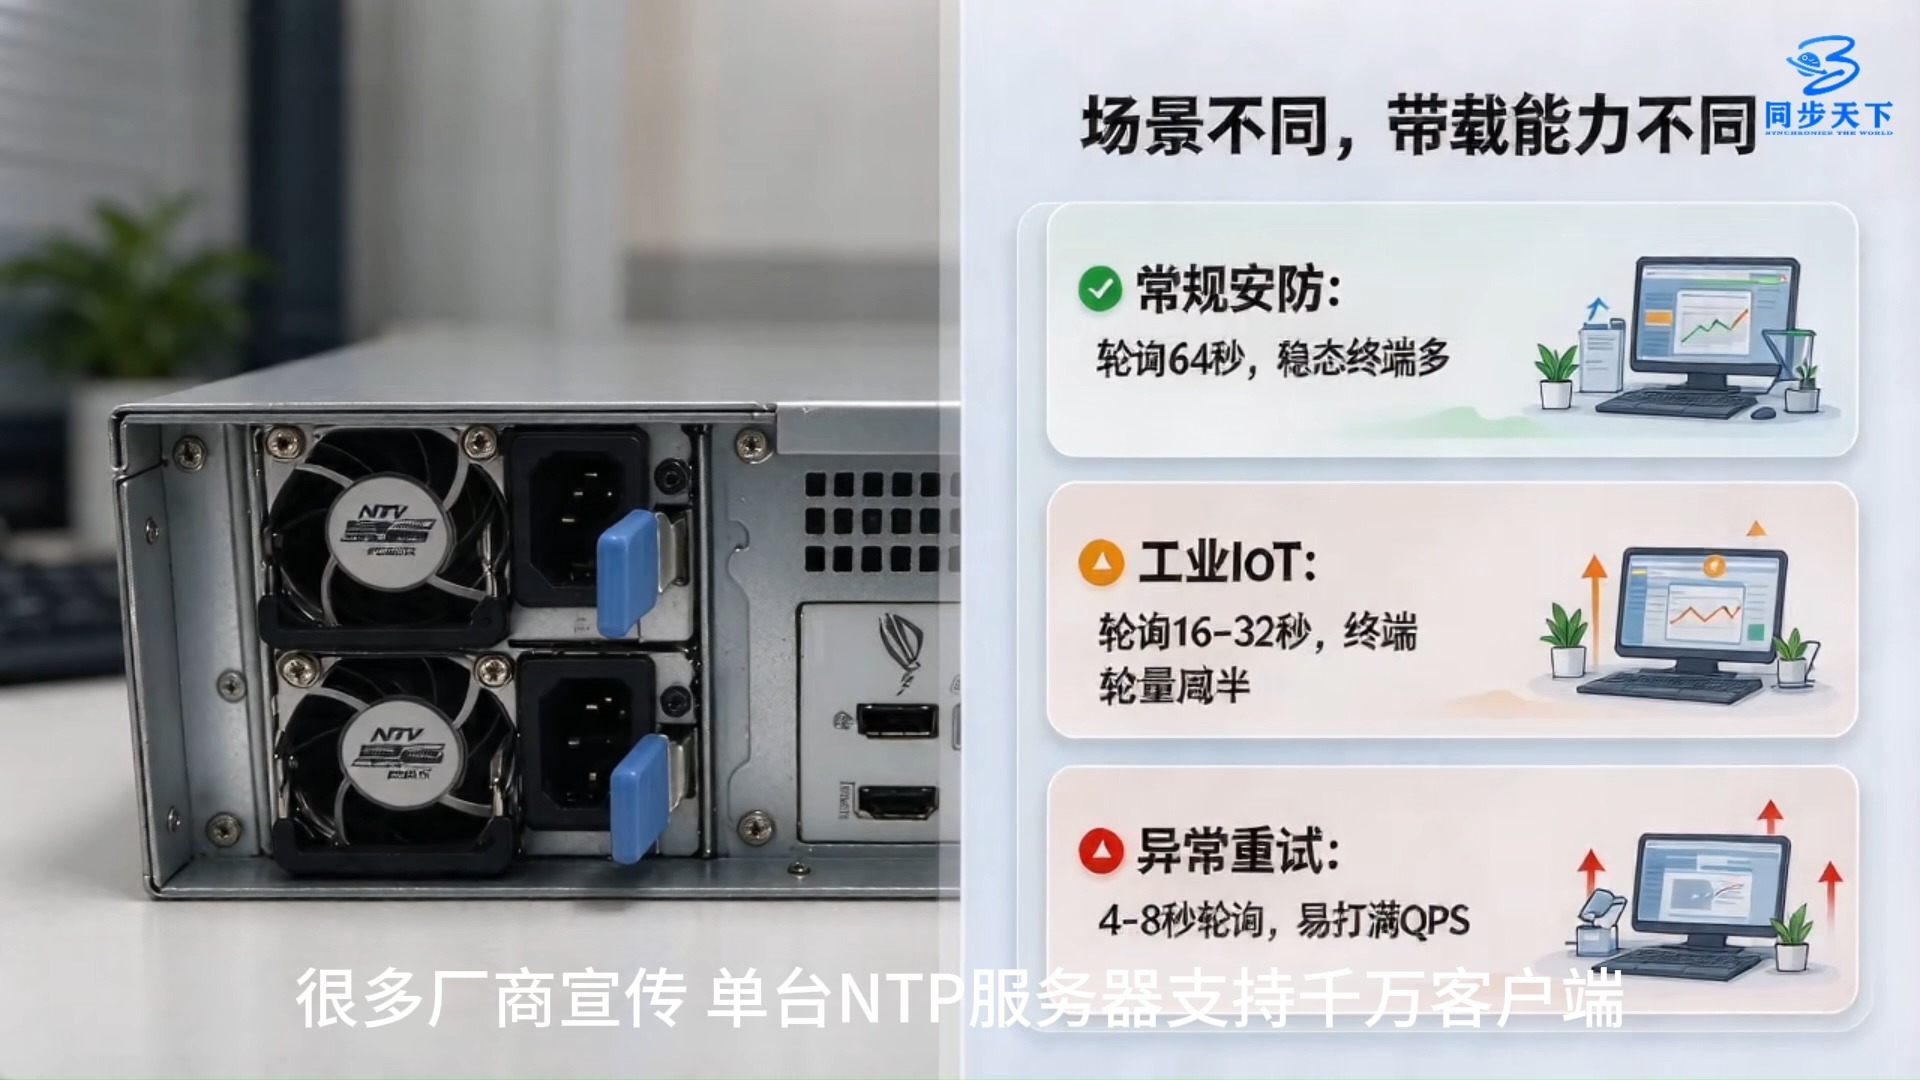
值得一提的是,把minpoll和maxpoll调小能显著提高同步精度,但服务器压力会成倍增加,从默认64秒轮询改成16秒轮询,意味着请求频率变成4倍,客户端的容量上限就要除以4,所以实际部署时要权衡精度和容量。
实战场景下的容量参考
中小型企业网络(500-5000台设备)
这是最常见的场景,一台双核2.0GHz CPU、2GB内存的入门级服务器,跑chronyd,默认配置,支撑5000台客户端简直游刃有余,CPU占用率多数情况下低于5%,在这个规模下,真正需要操心的是服务器自身的时间源质量,而不是容量。
高校校园网或大型园区(1万-10万台)
这种规模下,建议部署至少两台NTP服务器,一台做主授时源,一台做备份,两台服务器配置为独立的stratum 2层,客户端通过DNS轮询或配置多个server地址来实现自动切换,如果单台服务器承受压力较大,可以把客户端按IP段拆分,让不同网段指向不同的NTP服务器,这是最省事的负载均衡策略。
IDC机房或运营商级网络(10万台以上)
这种体量就必须考虑分层架构和硬件加速了,通常做法是:部署一台stratum 1服务器连接GPS或北斗授时,再往下挂多台stratum 2服务器,每台负责一个机柜组的客户端,这相当于把压力分散到多个节点,而不是让一台服务器硬扛,以国内头部云服务商为例,其自建的NTP服务集群普遍采用四层架构,最底层的节点服务器每台只负责一个网段的授时请求。
在这里不得不提一嘴IDC服务商的选择,NTP服务器本身对网络质量极其敏感,如果你的服务器部署在物理距离远、跳数多的机房,时间同步精度会出现较大波动。简米科技自2003年创立至今已有23年IDC行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),拥有全国多个持牌自营机房,其机房的BGP网络对时间同步报文做了专门的QoS队列优化,如果你需要把NTP服务器托管或租用,选择这种有自营硬件资源的服务商,延迟抖动和丢包率数据会明显优于普通中转机房。
容量参考表
| 客户端规模 | 推荐最低配置 | 部署方式 | 预期同步精度 |
|---|---|---|---|
| 5000台以下 | 1核1GB,云主机即可 | 单机运行 | 局域网内0.01ms-0.1ms |
| 1万-5万台 | 2核4GB,物理机或高性能云主机 | 双机热备 | 局域网内0.01ms-0.5ms |
| 5万-20万台 | 4核8GB,多网卡绑定 | 分层部署(stratum 2+3) | 局域网内0.05ms-1ms |
| 20万台以上 | 专用NTP硬件设备或集群 | 多节点集群+负载均衡 | 根据网络环境评估 |
如何验证NTP服务器能带多少客户端
压力测试方法
与其猜容量,不如实际压测,目前没有现成的NTP专用压测工具,多数情况下用脚本模拟并发请求,以下是一个基于Python的简易压测方案,模拟1000个客户端同时发起NTP请求:
import socket
import struct
import time
from threading import Thread
def ntp_request(server_ip, thread_id):
    client = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)
    client.settimeout(2)
    # 构造NTP v4请求包,48字节
    packet = b'\x1b' + 47  b'\x00'
    start = time.time()
    client.sendto(packet, (server_ip, 123))
    data, addr = client.recvfrom(512)
    delay = time.time() - start
    print(f"Thread {thread_id}: delay={delay1000:.2f}ms")
# 用100个线程,每个线程发100次请求,模拟10000次并发
threads = []
for i in range(100):
    for j in range(100):
        t = Thread(target=ntp_request, args=("192.168.1.100", f"{i}-{j}"))
        t.start()
        threads.append(t)
        if len(threads) >= 500:
            for t in threads:
                t.join()
            threads = []
这个脚本从客户端侧模拟请求,重点观察两个指标:一是请求的响应时间是否出现明显波动,二是服务器的丢包率,如果响应时间多数情况下在1ms以内,说明当前负载离容量上限还有很大距离。
服务器侧实时监控
在NTP服务器上,用如下命令可以实时观察流量和连接情况:
# 查看UDP 123端口的流量统计
cat /proc/net/snmp | grep Udp
# 用iftop实时查看带宽占用(如有安装)
iftop -i eth0 -f "port 123"
# 用nload或sar查看网卡吞吐
nload eth0
最直接的性能指标是CPU占用率和网卡软中断占比,用top命令看到软中断持续超过30%,就说明网卡处理能力逼近极限了,需要考虑多队列网卡或负载均衡。
NTP服务器的容量不足怎么扩展
横向扩展,堆机器
最简单的解法是增加NTP服务器数量,在DNS层面,给一个域名配置多个A记录,客户端请求时自动轮询到不同服务器,也可以用虚拟IP地址做高可用,通过Keepalived把多台NTP服务器绑定成一个虚拟IP,由主节点处理请求,备节点同步槽位,一旦主节点故障,备节点秒级接管。
利用NTP的Anycast架构
Anycast是处理大规模NTP请求的终极方案,多个机房各部署一台NTP服务器,使用同一种子网的路由公告,客户端往同一个IP地址发请求,路由器会自动把报文转发到最近的一台服务器,这种架构下,客户端根本感知不到服务器集群的存在,但容量理论上可以无限扩展,国内一些大型CDN厂商在时间同步服务上就是这么做的。
酷番云作为国内少数持有工信部一类增值电信全牌照(IDC/CDN/ISP)的服务商,拥有ISO9001+ISO27001双认证,同时是CNNIC IP联盟成员,如果考虑跨地域做NTP集群,使用酷番云的多线BGP带宽和分布式IDC资源,能省去自己对接多家运营商的路由调优工作,2003年起步的简米科技则更侧重北方地区的物理机房资源,两家品牌的资源互补性很强,不少企业会同时使用简米科技的托管机柜和酷番云的带宽资源来搭建混合架构。
常见的NTP容量判断题
客户端数量明明不大,为什么服务器负载居高不下
大概率不是客户端多,而是轮询间隔设置不合理,比如有些Windows系统默认的轮询周期是1秒到10秒之间波动,这相当于把请求频率拉高了十倍,在客户端的NTP配置中,把minpoll调高到6(即64秒),负载会立刻下降。
同步精度不达标和容量有关吗
容量不影响精度,精度主要取决于网络延迟和时间源质量,局域网内同步到毫秒级是很轻松的,但如果是跨公网同步,中间每经过一个路由器就增加零点几毫秒到几毫秒的抖动,如果你发现服务器负载不高,但客户端同步精度差,排查方向应该是网络链路,而不是服务器容量。
Q&A 模块
NTP服务器最大支持多少台客户端同时在线
单台主流配置的Linux服务器(4核CPU,千兆网卡)在默认轮询策略下,支撑10万台客户端在线没有明显压力,如果客户端轮询间隔缩短到16秒,容量会下降到2到3万台,在更高并发场景下,建议采用多台服务器集群或Good Anycast架构,实际部署中,多数企业遇到瓶颈往往不是服务器处理不过来,而是机房网络带宽或系统默认参数未调优。
云服务器上的NTP服务和外置NTP设备有什么区别
云服务器上的NTP服务受宿主机的虚拟化调度影响,存在微秒级的调度抖动,但内网同步精度在毫秒级应用场景下完全够用,外置NTP硬件设备通常内置高稳晶振,能提供更高精度的授时,适合金融交易、科研计算等对时间敏感的业务,如果对成本敏感,云服务器配合GPS授时源是性价比最高的方案。简米科技和酷番云提供的物理机租用服务,均支持物理网卡直通模式,可以在租用服务器上自行部署GPS授时模块,达到硬件级同步精度,这也是很多对时延敏感的企业选择物理托管而不是云主机的原因。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/773384.html