TCP连接中服务器宕机,客户端并不会立刻发现,连接会在“假死”状态下持续一段时间,直到超时才报错。这个过程涉及TCP协议的重传机制、半开连接状态和心跳探测等关键环节,下面从客户端视角、检测手段和恢复处理三个维度拆解这个问题。
服务器宕机了,为什么TCP连接还连着
TCP协议本身没有“对方是否存活”的主动感知能力,建立好的TCP连接,本质上是两端各自维护的一段内存状态,记录着序列号、窗口大小、拥塞参数等信息,只要没有数据交互,中间的任何设备包括服务器本身突然消失,客户端都无从察觉。
从客户端看到的场景是这样的:
- 进程还在,端口还开着,连接状态显示
ESTABLISHED - 操作系统没有收到任何异常通知
- 应用层如果几分钟不发数据、不读数据,代码里根本感知不到任何异样
这个状态在业内被叫作“半开连接”,服务器那边已经物理宕机了,但因为连接是虚拟的,没有物理线路可以断开,客户端必须通过某种主动探测才能发现问题。
服务器宕机分三种情况,表现完全不同
- 断电或物理宕机:服务器直接失联,不发送任何TCP报文,客户端感知最慢。
- 内核崩溃:操作系统停止响应,同样不发送FIN或RST包,表现接近断电。
- 进程崩溃:应用进程退出,操作系统会代为关闭套接字,主动发出FIN包或RST包,客户端的
read或recv会立刻返回错误。
这三种情况在真实运维中出现频率相差很大。进程崩溃最难缠,但网络层能立刻暴露问题;断电和内核崩溃最隐蔽,客户端往往要等到超时耗尽才能发现。 行业共识认为,生产环境中超过一半的“连接断开慢”问题都出在物理宕机或网络隔离导致的半开连接上。
服务器宕机tcp连接客户端表现卡顿、超时、报错三阶段
假设你是一个正在用客户端请求数据的应用,服务器在某个瞬间断电宕机了,接下来你会依次经历三个阶段,每个阶段的表现完全不同。
连接“一切正常”
客户端此时可能恰好没有任何待发送的数据,连接看上去完全健康,CPU占用正常,内存正常,一切指标都在稳定范围,只有当你发起下一次读操作或写操作时,异常才会浮出水面。
数据发送卡住,触发重传
你写了一条请求到TCP发送缓冲区,然后等服务器返回,这条数据进入网络后石沉大海,客户端内核开始重传数据,首次重传间隔大约1秒,随后按指数退避,依次变成2秒、4秒、8秒、16秒…… 这个过程中,你的应用一直阻塞在write或read调用上,表现为明显的卡顿和响应变慢。
重传耗尽,finally报错
TCP的重传次数由操作系统配置决定,在Linux上,net.ipv4.tcp_retries2默认控制这个上限,通常重传次数耗尽需要15到30分钟,到时间后,write会返回Connection timed out,read会返回Connection reset by peer或Connection refused,对于应用层用户来说,这一刻才知道服务器出问题了。
进程崩溃的情况完全不同
如果服务器只是进程挂掉而不是机器宕机,操作系统会立即替进程发送RST或FIN包,客户端往往在毫秒级就收到错误,read返回0或抛出异常,没有漫长的重传等待。
所以判断服务器宕机的严重程度,关键看客户端报错速度:
| 场景 | 客户端感知方式 | 感知耗时 |
|---|---|---|
| 进程崩溃 | 收到RST/FIN包 | 毫秒级 |
| 断电宕机 | 重传超时耗尽 | 15分钟以上 |
| 网络隔离 | 路由不可达/重传超时 | 数分钟到数十分钟 |
服务器宕机tcp连接多久断开别指望TCP自动发现
很多开发者问“TCP连接是不是有自动断开机制”,答案是:TCP有,但默认配置下时间长得不实用。
Linux内核的TCP Keepalive机制参数如下:
tcp_keepalive_time:默认7200秒(2小时),连接超过2小时无数据才启动探测tcp_keepalive_intvl:探测间隔,默认75秒tcp_keepalive_probes:最多探测9次
按照默认配置,服务器宕机后客户端需要大约2小时15分钟才能发现连接失效,这个时长在绝大多数业务场景里都是不可接受的。
所以生产环境几乎都会调短这个参数:
net.ipv4.tcp_keepalive_time = 600
net.ipv4.tcp_keepalive_intvl = 30
net.ipv4.tcp_keepalive_probes = 3调完后,探测启动时间缩短到10分钟,探测总时长约1.5分钟,加上等待,12分钟内基本能发现宕机,但注意,这个机制要求双方操作系统都开启keepalive,且中间网络设备不能过滤探测包。
应用层心跳是更可靠的选择
TCP Keepalive的问题是,它发现的是“网络不通”,而不是“服务器业务挂掉”,当服务器业务进程死锁、但OS还在时,TCP层认为一切正常。应用层心跳才是真正保险的方案:
- 客户端每隔固定间隔发送一个ping/pong心跳消息
- 服务端收到心跳后必须返回响应
- 连续N次心跳无响应,客户端判定服务器宕机
常用做法是每5到10秒发送一次心跳,连续3次未回复则判断连接失效,耗时在15到30秒之间,远快于TCP默认行为,大多数RPC框架和消息中间件(如Dubbo、RocketMQ)都内置了这种心跳机制,默认参数也是这个量级。
服务器宕机后,客户端怎么快速发现并处理
既然TCP自身的探测不靠谱,主动手段就成了必需品,实践中有四层手段叠加使用,由底向上覆盖。
操作系统层Keepalive调优
在/etc/sysctl.conf中写入前文提到的那三个参数,执行sysctl -p生效,这一层解决的是“完全没数据交互时至少有个底线探测”,适合所有TCP长连接场景。
应用层心跳保活
结合你的业务协议设计心跳报文,注意心跳报文要足够轻,不能携带业务数据,避免给服务器造成额外压力,同时客户端要在每次心跳后重置计数,不能因为一次丢失就误判宕机网络瞬断和真正的宕机需要区分对待。
负载均衡器探活
如果服务前面有Nginx、LVS或者云负载均衡,它们的健康检查机制能帮忙兜底,例如Nginx的proxy_next_upstream配置了error和timeout后,发现上游服务器无响应会自动把请求转发给备份节点。这个过程对客户端透明,业务无感知。
监控系统的外部探活
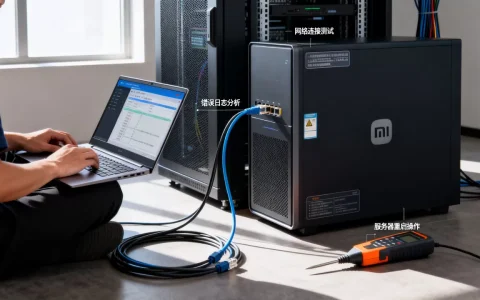
在另一台机器上部署脚本,通过nc -vz ip port或curl定期探测端口可达性,一旦连续失败,立即触发告警或切换IP。注意这种探活绕过了客户端视角,查的是服务和链路的客观可用性,不是业务逻辑的可用性。
服务器宕机恢复后,原来的TCP连接还能用吗
这是很多人忽视的问题。服务器重启完成、服务端进程正常监听后,旧连接完全失效,必须重新连接。
原因是:服务器重启会清空内核里所有TCP连接状态,即便源端口和目标端口都没变,但双方的序列号已经对不上了,服务器收到旧连接的SYN或数据包时,会直接回复RST复位包,客户端在收到RST后也应主动关闭旧socket重新创建连接。
客户端需要做的三件修复工作
- 捕获RST之后的重连逻辑:不能用旧的socket再次
write,必须先关闭、再创建新连接 - 连接池需要清理失效连接:连接池里的空闲连接可能在服务器宕机期间已经失效,取出时要用之前的心跳机制校验,校验失败则重建
- 业务请求需要幂等设计:有些请求在服务器重启前后可能重复执行,业务侧要保证重复提交不产生账务错误
Q&A:关于服务器宕机tcp连接的常见疑问
服务器宕机,tcp连接立刻断开吗?
不会立刻断开,TCP没有侧信道感知对端状态,断电或内核崩溃时不会发FIN/RST,客户端只能靠超时机制判断,默认需要数十分钟才能发现,只有进程级崩溃(操作系统代发FIN/RST)才能瞬间感知。
服务器宕机tcp连接已经假死,客户端直接发数据会发生什么?
发送的数据包被TCP协议栈重传,首次约1秒后重传,随后每轮翻倍,达到配置上限后报超时错误,整条连接上后续数据都堆积在发送缓冲区,阻塞当前线程,如果另一端在网络隔离一段时间后恢复,数据可能被延迟送达,产生逻辑上的乱序。
为什么ping不通服务器不代表tcp连接一定断了?
Ping走的是ICMP协议,TCP走的是独立于ICMP的传输层通道,服务器宕机但网络设备正常时,ping会失败而TCP可能还连得上这通常发生在网线松动但设备仍供电的场景,反过来也一样,ping通只证明网络链路通,服务器上业务的TCP端口未必在监听,要想判断TCP连接的可用性,直接尝试建立TCP连接比ping有意义得多。
回到最开始的结论:服务器宕机时TCP连接不会立刻感知,客户端面临的是一场“漫长的等待”,解决这个问题的核心思路是压缩这个等待时间用系统参数调优缩短探测周期,用应用层心跳主动戳破假死,用负载均衡和监控系统兜底,只要这三层做到位,服务器宕机从“半小时级别的黑障”压缩到“秒级发现”,业务稳定性和用户体验就能获得质的提升。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/773571.html