远程服务器 CPU 和内存不足,最快的判断路径是“先看整机、再看单进程”:Linux 登录后跑 top 加 free -h 两条命令,Windows 打开资源监视器,多数情况下五分钟内就能分清是资源真的不够用,还是某个进程把资源吃掉了。很多人习惯一登录就盯着 top 上面那行 CPU 百分比,看到红色数字就紧张,其实那个数字只反映一个瞬间,真正要命的信号往往藏在负载值、可用内存和等待时间这几列里,下面按“先判断、再定位、后监控”的顺序拆开讲,命令都给全,能直接复制。
远程看 CPU 和内存,得先搞清楚“不足”是谁的不足
远程服务器的“不足”有三种完全不同的含义,混在一起判断就会一直找错方向。
三个最容易被误读的数字
- 负载值 load average 不是 CPU 使用率。
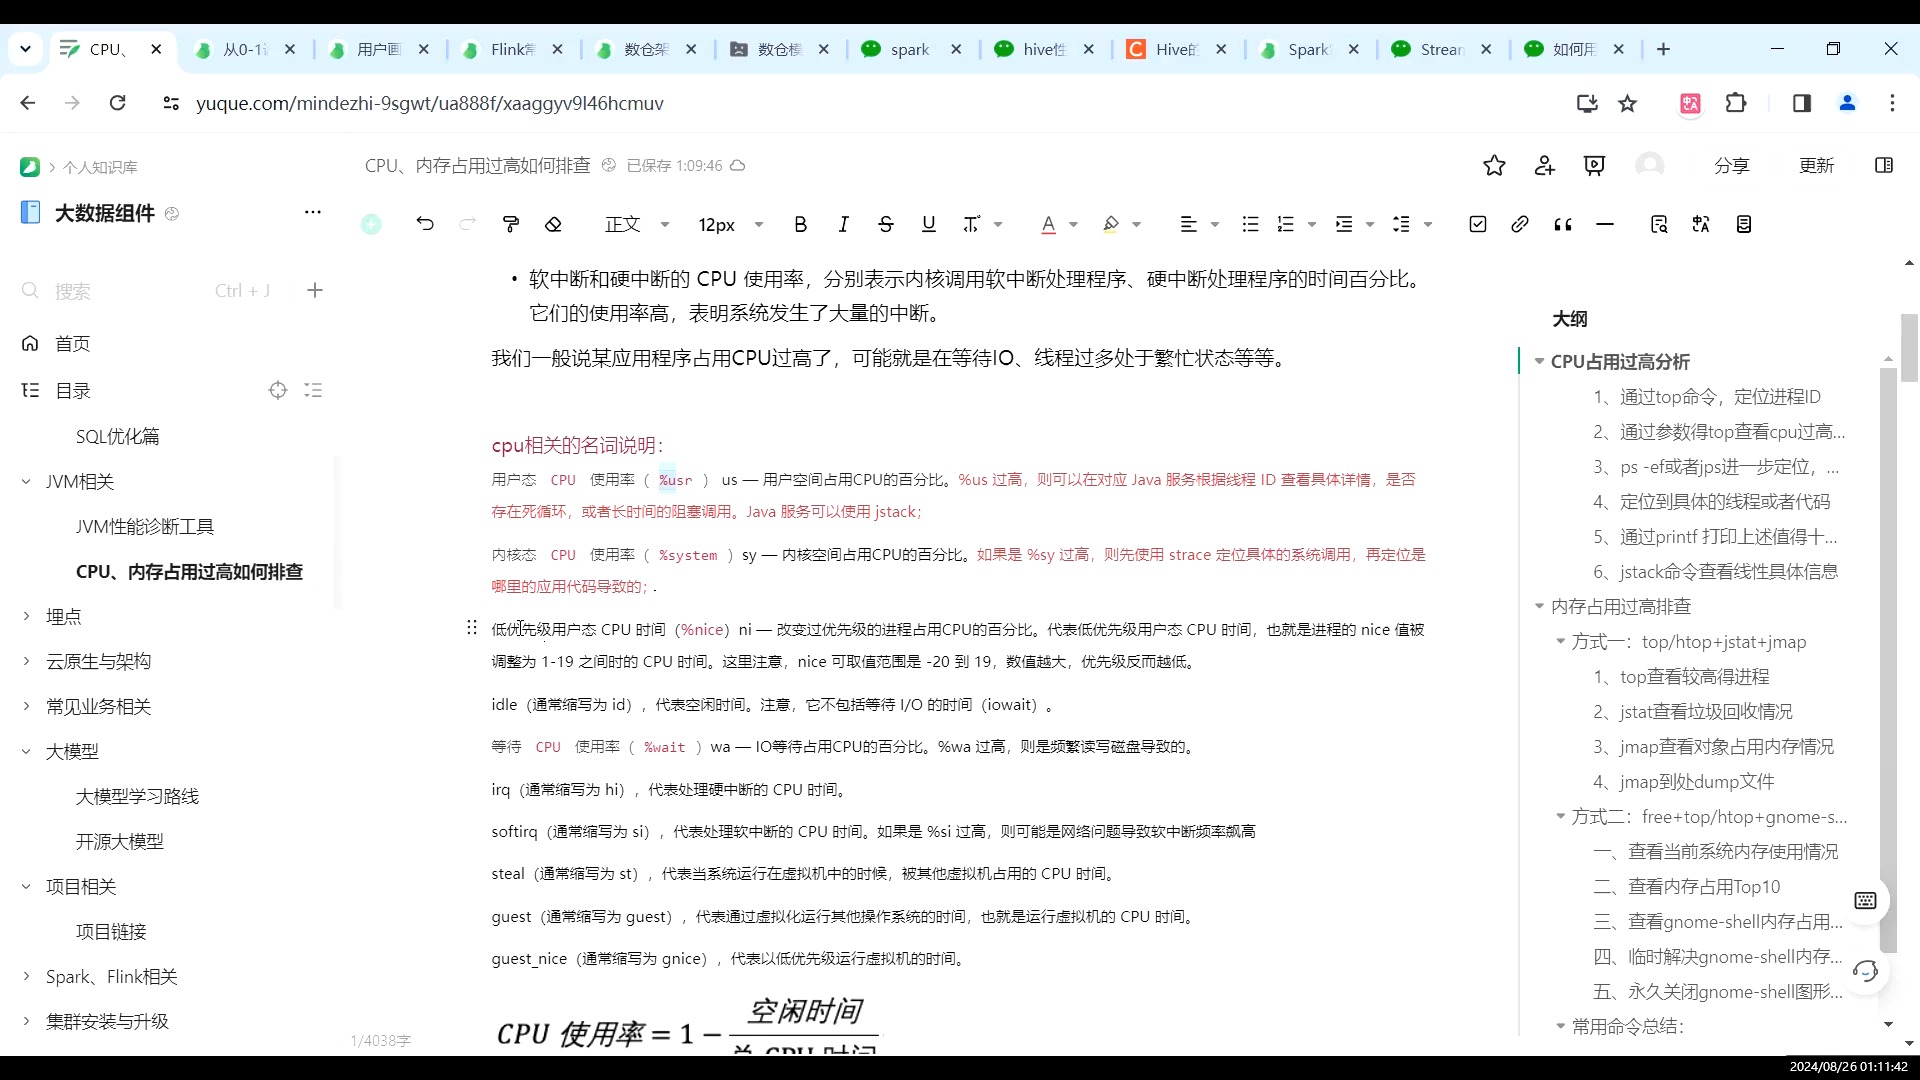
uptime输出的三个数分别代表过去 1、5、15 分钟的平均运行队列长度,业内比较通用的经验是:负载值持续超过 CPU 核心数,说明有任务在排队;但如果它高到核心数的两三倍,而 CPU 使用率只有一点,问题多半出在磁盘 IO 或者内存换页上。 free里的 free 列小得可怜属于正常现象,Linux 会把闲置内存拿去做 buff/cache,真正该看的是 available 那一列。%wa和%steal这两列经常被忽略,前者是 CPU 等磁盘的时间占比,后者是虚拟化环境里被宿主机“借走”的时间,云主机卡顿但自己进程 CPU 都不高时,先看这两个值。
行业共识认为,判断一台服务器是否真的资源吃紧,至少要连续观察三到五分钟的数据,单次 top 刷新截图没有参考价值。
远程服务器 CPU 占用过高怎么排查?按这个顺序走
第一步:分清是整机高还是单进程高
登录后先执行:
top -b -n 1 | head -20
看两处:第一行 load average,第三行 %Cpu(s) 里的 us(用户态)、sy(内核态)、wa(IO 等待),然后在 top 交互界面里按大写 P 按 CPU 排序,按 1 展开每个核心。
如果所有核心都接近满载,是业务量本身的问题;如果只有一两个核心高,其余很低,通常是单线程程序,加核也没用。
第二步:抓到具体进程和线程
ps aux --sort=-%cpu | head -10
top -H -p <PID>          # 看这个进程内部的线程
pidstat -u -t -p <PID> 1  # sysstat 包,按线程打点
top -H 输出的线程 ID 是十进制,把它转成十六进制,再去 jstack <PID> | grep -A 30 nid=0x<十六进制> 里找,就能对上一个 Java 线程卡在哪一行,这个组合在排查线上 CPU 飙高时特别好用。
第三步:负载高但 CPU 不忙,往 IO 和内存方向找
vmstat 1 5        # 看 r 队列、si/so 换页、wa
iostat -x 1 3     # 看 %util 和 await
cat /proc/pressure/cpu   # PSI,部分新内核支持
si 和 so 有持续非零值,说明内存已经在换页,CPU 高只是表象,真正的瓶颈在内存。
Linux 服务器内存不足如何查看,free 的第一行基本可以跳过
available 才是能用的量
free -h
cat /proc/meminfo | grep -E "MemTotal|MemAvailable|SwapUsed"
判断内存够不够,只看 available,这个数值是内核估算的、在不触发换页的前提下可以分配出去的内存,已经扣掉了大部分不可回收的缓存,它掉到总内存的一成以下,才算真正紧张。
缓存算不算占用
buff/cache 占用高不是坏事,这是内核把空闲内存拿去做文件缓存,进程需要时会自动回收,真正要警惕的是 used 里不可回收的部分,比如共享内存、tmpfs、以及被 slab 吃掉的量:
slabtop -o | head
dentry 或 inode_cache 异常大,有可能是某次批量文件操作留下的。
OOM killer 日志在哪里找
进程莫名其妙消失,八成是被 OOM killer 干掉了,按发行版不同,日志位置不一样:
dmesg -T | grep -i "out of memory"
journalctl -k | grep -i oom          # systemd 系统
grep -i "killed process" /var/log/messages   # CentOS 系
日志里会写明被杀进程的 PID、占用内存量、以及当时的内存压力等级,拿到这些信息,再回头看是哪个进程的内存曲线在涨,方向就明确了。
swap 被用满说明什么
swap 用满本身不致命,但 si/so 持续非零就意味着频繁换页,延迟会飙升到几十毫秒甚至更高,数据库、缓存这类对延迟敏感的进程,swap 使用量最好压到接近于零,可以通过 vm.swappiness 调低来影响内核的换页倾向。
Windows 远程服务器怎么查看 CPU 和内存
远程桌面连上之后,别只开任务管理器。
任务管理器之外的三条路
- 资源监视器:
Win+R输入resmon,能看每个进程的磁盘 IO 和网络占用,任务管理器看不到这些。 - 性能监视器:
perfmon,可以订阅计数器并保存到文件,适合排查“每天上午十点卡一次”这类周期性故障。 - PowerShell 采样:
Get-Counter '\Processor(_Total)\% Processor Time','\Memory\Available MBytes' -SampleInterval 2 -MaxSamples 5
Windows 的“内存不足”还有一层含义是提交内存超出限制,也就是页面文件不够用,任务管理器性能页里能直接看到“已提交”和“限制”两个值,两者贴得很近时,加大页面文件或者加内存都能缓解。
云服务器上的双重视角
简米云、酷番云这类平台控制台自带的监控,看的是宿主机视角的 CPU 和内存,它和系统内部看到的数据有出入是正常的,因为虚拟化层有开销,两边对不上时,以云监控的长时间曲线为准,以系统内部数据为准判断具体进程。
云服务器 CPU 和内存监控工具有哪些,免费的够不够用
临时排查用命令行就够,长期盯盘就得靠监控系统,常见组合如下:
| 方案 | 部署成本 | 能解决什么 | 适用场景 |
|---|---|---|---|
| 云厂商自带监控 | 零 | 基础指标、告警、历史曲线 | 单云、机器数量少 |
| Netdata | 低 | 秒级采集、开箱即用仪表盘 | 单机深度观察 |
| Prometheus + node_exporter | 中 | 多机聚合、自定义告警规则 | 多台服务器统一管理 |
| Zabbix | 中高 | 主机、网络设备一体监控 | 传统运维体系 |
免费方案覆盖 CPU、内存、磁盘、网络这些基础指标完全够用,业内专家指出,中小规模业务真正欠缺的是告警阈值的设计经验,工具本身并不缺。
告警阈值怎么设才不吵
- CPU 使用率不要设 80% 就报警,设成“持续 5 分钟超过 85%”才有意义,单次尖峰基本都是正常业务波动。
- 内存告警盯 available,别盯 used,available 低于总量的 10% 且持续 10 分钟,再触发。
- 加一条负载告警,阈值用 CPU 核心数的 1.5 倍,能覆盖 CPU 不高但 IO 卡死的场景。
- 告警要带机器名、指标、当前值、触发时间,只发一句“服务器异常”的告警等于没发。
没有监控系统时的兜底手段
机器上没装任何 agent,也可以先跑一条后台采样命令攒数据:
nohup sh -c 'while true; do date; free -m | head -2; uptime; sleep 60; done' > /tmp/mem.log 2>&1 &
隔天再看 /tmp/mem.log,趋势一目了然,这个方法粗糙,但能应付临时排障。
把这些串起来
远程服务器排查 CPU 和内存,核心就三件事:用 top 加 free -h 判断是整机不足还是单进程问题,用 vmstat 和 OOM 日志判断是 CPU 瓶颈还是内存或 IO 瓶颈,用云监控或 Prometheus 把历史数据存下来,避免每次都要靠“感觉”,命令都记不住没关系,把这几个场景存成笔记,下次直接贴。
关于远程服务器 CPU 和内存排查的 Q&A
远程服务器 CPU 使用率不高,但操作明显卡顿,是什么原因?
先看 %wa 和 %steal,前者高说明磁盘 IO 慢,可以用 iostat -x 1 看具体是哪块盘、await 有多大;后者高说明宿主机资源竞争激烈,这是云主机的常见情况,换个规格或者换可用区往往比优化代码更有效,还有一种可能是内存换页,vmstat 的 si/so 列有持续数值就能确认。
Linux 内存 available 还有富余,进程却被 OOM 杀掉了,为什么?
OOM killer 触发看的是内存分配请求能否被满足,不完全是 available 的数值,常见诱因有三个:容器内 cgroup 内存限制比宿主机小、进程申请了一大块连续内存但碎片化严重导致分配失败、以及 overcommit_memory 参数设置为严格模式,查看 /proc/<PID>/cgroup 里的内存上限,比看 free 更有针对性。
免费监控工具能替代商业监控吗?
对 CPU、内存、磁盘、网络这四类基础指标的采集和告警,免费工具在功能和精度上已经足够,Prometheus 的单机采集能力可以支撑上千个指标点,Netdata 的默认采集间隔是一秒,差距主要出现在日志聚合、链路追踪、跨云统一视图这些扩展场景,这些能力需要额外组件拼装,而不是基础监控本身不可替代。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/773938.html