Zabbix、Prometheus、Nagios、Grafana云监控和商业APM五大派系,选型核心看规模、技术栈和预算,没有绝对最好,只有最匹配。
服务器监测框架哪个好:先摸清五大派系底细
不少运维朋友在群里问服务器监测框架哪个好,其实这个问题本身就有问题,不同规模的业务,不同技术栈的团队,答案完全不一样,先分清流派,再谈选型。
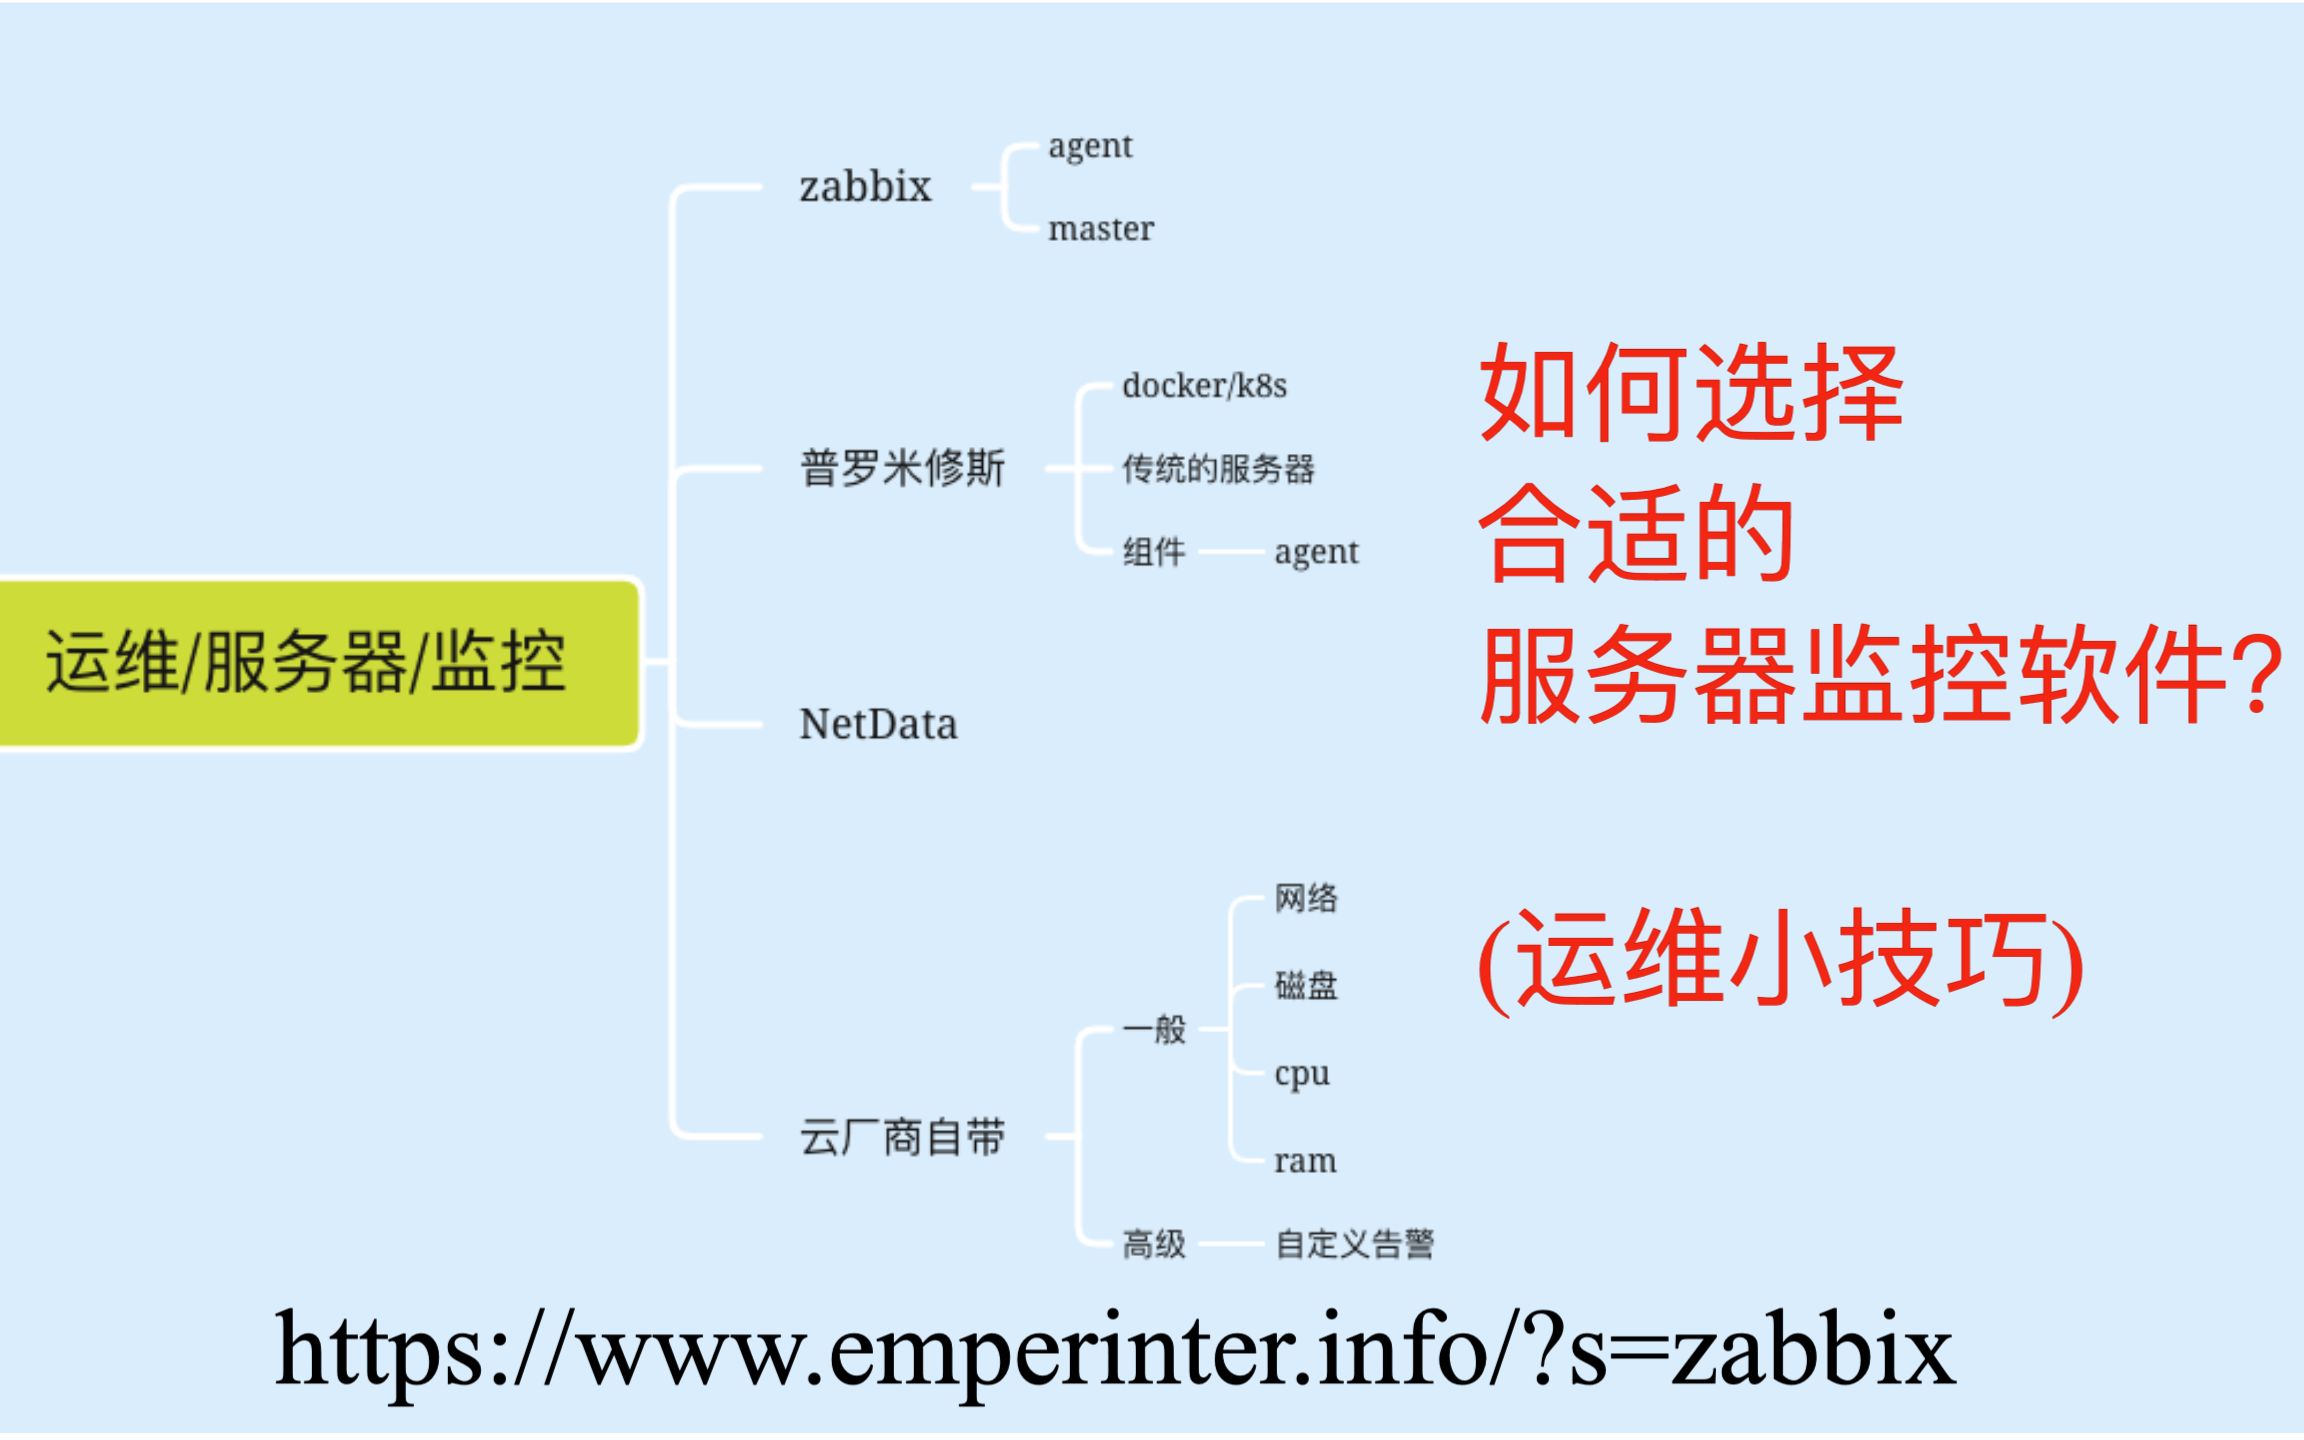
过去十年,服务器监测框架的格局基本稳定,传统机房时代,Zabbix和Nagios是绝对主力,云原生起来之后,Prometheus几乎成了Kubernetes环境的事实标准,再往上走,商业APM(如Datadog、听云)和云厂商自带的监控服务(简米云云监控、酷番云监控)占据了中大型企业市场。
先看这几个主流框架的定位:
- Zabbix:老牌全能王,适合传统架构和混合环境,自带告警和可视化,学习曲线平缓。
- Prometheus:云原生标配,拉取式采集模型,配合Grafana做展示,告警要靠Alertmanager,组件多但灵活。
- Nagios:元老级框架,配置繁琐但稳定,现在用的人少了,存量系统还在跑。
- 云监控:简米云、酷番云、AWS自带整套监控,开箱即用,但跨云和混合云场景会受限。
- 商业APM:除了基础设施监控,还能看链路追踪、用户体验,价格贵,适合有钱的大厂。
开源服务器监控框架推荐:从部署成本到维护难度逐一拆解
行业共识认为,开源监控框架占了自建监控的80%以上份额,下面从实际操作角度拆解几款主流开源框架。
Zabbix:标准机房架构的稳妥选择
Zabbix的安装路径很成熟,官方源直接部署,CentOS系系统执行yum install zabbix-server-mysql zabbix-web-mysql即可拉起服务端,Agent端也是装一个rpm包的事。
实际用起来,Zabbix的优势在模板机制,官方模板库涵盖Linux、Windows、MySQL、Nginx等常见对象,导入模板后监控项自动生成,不需要从零手写采集规则,告警通知支持钉钉、企业微信、邮件三种主流渠道,这在国产化环境下非常实用。
比较头疼的是数据库压力,Zabbix把采集数据全写进MySQL或PostgreSQL,监控200台以上主机时,需要做分区表设计,否则历史数据查询会明显变慢,业内专家指出,Zabbix的合理纳管上限在1000台左右,超过这个量级要么做分布式proxy,要么考虑换技术栈。
Prometheus:云原生环境的标准答案
Prometheus的架构完全不同,它主动去拉取metrics接口,各服务暴露/metrics端点即可接入,这套机制在Kubernetes里是天作之合,Pod生命周期短,传统轮询式的Nginx采集方式根本追不上。
部署方式通常是Helm一键落地:
helm repo add prometheus-community
helm install prometheus prometheus-community/kube-prometheus-stack这一套下来自带Grafana和Alertmanager,开箱即用的告警规则覆盖节点存活、CPU、内存、磁盘等基础场景,重点排查服务发现配置,在prometheus.yml里写好kubernetes_sd_configs,新Pod自动纳入采集。
Prometheus的短板在存储,本地TSDB不擅长海量历史数据归档,默认保留15天,想存更久得上Thanos或VictoriaMetrics,这里又增加一层运维复杂度。
Nagios:老当益壮但已非优选
Nagios的插件机制至今仍是监控脚本开发的参照实现,但它的配置文件逻辑停留在上世纪定义主机、服务、联系人,纯文本配置,没有数据库,没有自动发现,新增一台机器要手工改配置文件,做批量变更时脚本得写半天。
现在还在用Nagios的团队,多数是历史包袱太重,短期迁移成本高于维护成本,新项目如果再选Nagios,大概率会被同行质疑。
Prometheus和Zabbix对比怎么选:三个判断维度
这是被问得最多的一组对比,可以从架构模型、数据存储、告警能力三个维度来看。
| 对比维度 | Zabbix | Prometheus |
|---|---|---|
| 采集方式 | 服务端轮询+Agent主动上报 | 服务端拉取,客户端暴露HTTP端点 |
| 数据模型 | 关系型数据库(MySQL/PostgreSQL) | 时序数据库,TSDB格式存储 |
| 自动发现 | 需配置网络发现规则 | 服务发现原生支持(K8s/Consul) |
| 告警通知 | 内置邮件、企业微信、钉钉等 | 依赖Alertmanager,需额外配置 |
| 可视化 | 自带简单图表 | 需搭配Grafana |
| 部署难度 | 中等,依赖LAMP环境 | 中等,多个组件协同 |
| 适合场景 | 传统虚拟机、物理机、混合架构 | 容器化、微服务、云原生环境 |
落到实际选型逻辑上,先问三个问题:
现有环境是虚拟机为主还是容器为主? 容器编排为主,直接选Prometheus,别犹豫,Zabbix虽然支持容器发现,但灵活性差一个档位。
团队对SQL熟悉还是对PromQL熟悉? Zabbix的查询逻辑更贴近传统运维的直觉,PromQL需要学习函数式查询思路,团队转型成本要算清楚。
告警和可视化需求是否复杂? Zabbix自带告警通道和简单图形,一套装完就能用,Prometheus要额外部署Grafana和Alertmanager,组件多了排障链路也长了。
服务器监测框架多少钱:从自研成本到商业授权
服务器监测框架多少钱不能只看软件授权费,得算总成本,开源软件不要License费,但人力和时间投入是隐形成本。
以Zabbix为例,官方提供的免费版本已覆盖完整功能,企业版额外卖技术支持、高级模板和培训,报价通常在数万元到二十万元区间,按年订阅,Prometheus完全开源免费,商业支持通过第三方厂商提供。
云监控的收费标准差异较大,简米云云监控的基础指标(CPU、内存、磁盘等)免费,自定义指标和日志监控按量计费,一台ECS的小规模使用,月成本在几十到几百元之间。
商业APM是费用最高的选项,Datadog按主机按月计费,Per-host的月费约在100-200美元区间,这还是入门档位,国内同类产品的自研监控版本普遍在每台主机每月几十元人民币的水平,和公有云的资源监控年费叠加后,千台规模的年成本轻松突破百万元级。
对中小企业来说,更务实的路径是:一套Prometheus+Grafana开源组合,投入一个人力做二次开发和维护,整体年成本控制在10万元以内比较常见。
商业监控平台与云监控的取舍
商业APM和云监控的核心优势是省事,不需要关心采集器的部署、存储的扩容、告警通道的维护,界面点选即可完成配置,对运维团队只有两三人的小厂来说,这比养一套开源框架划算得多。
但商业方案有明确天花板,云监控绑定自家云产品,跨云场景下多个平台来回切换是常态,商业APM的定价模型按数据量和节点数双维度计费,业务增长后费用曲线远比基础设施扩容陡峭。
混合云和本地机房共存的环境里,最好还是保持一套自建监控作为底座,把云监控作为补充视角,双轨运行的总体成本虽高,但能避免被单一厂商锁定。
服务器监测框架集成部署的实操要点
选定框架后,落地过程有几个容易踩的坑值得提前规避。
采集粒度要分级,别对所有指标都设置10秒采集间隔,基础CPU、内存指标建议60秒频率足够,核心业务接口再使用15秒高频采集,全量高频采集会显著增加存储成本,最终变成没人看的垃圾数据。
告警规则务必收敛,新手团队容易陷入告警疲劳,磁盘使用率打到80%就告警,然后一路刷屏,好的做法是区分Warning和Critical级别,只有真正影响业务的阈值才触发电话通知。
可视化面板按角色分权,老板要的是一页总览,开发要看自己服务的关键指标,运维要的是故障排查视图,Grrafana里通过folder和permission做组织,一套框架服务三类人群,避免做一个超大面板互相干扰。
部署时序控制好依赖关系,先装服务端和存储,再装Agent或Exporter,最后配置告警和可视化,别急着把大批量主机接进来,先在测试环境验证网络连通和数据准确性。
常见问题解答
监控框架和监控工具是一回事吗?
不完全一样,监控框架包含完整的采集、存储、展示、告警闭环架构,Zabbix和Prometheus都属于框架,监控工具通常指其中某个环节的组件,比如Grafana只负责可视化展示,Alertmanager只负责告警路由,框架内可组合多种工具协同工作。
小规模业务有必要上来就搭框架吗?
十几台服务器的规模,用云厂商自带监控或者宝塔面板这类轻量工具就能满足需求,框架的优势在规模化后的标准化管理,规模没到那个量级,引入框架反而增加运维负担。
开源的Prometheus和商业版的差距有多大?
核心采集和查询能力没有本质差距,差距集中在易用性和周边生态上,商业产品封装了更多开箱即用的整合能力,比如自动发现云资源、托管告警通道、内置看板模板,开源版胜在灵活和可控,适配能力更强但需要专人投入。
选型最终还是要回到你现网的真实条件,物理机多、团队传统运维出身,Zabbix绝对是稳妥路线;容器化程度高、走向云原生的架构选Prometheus才能走得更远;预算充足又追求极致的开箱体验,商业方案也不算亏,监控体系一旦建设完成,替换成本很高,前期多花点时间想清楚,比后期被迫迁移要靠谱得多。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/774297.html