想要让云服务器有显卡,答案不是往机箱里插卡,而是直接租用或创建一台带有GPU的云服务器实例,或者通过云服务商提供的GPU虚拟化能力获得显卡算力。
云服务器怎么加显卡:先搞清楚你面对的“显卡”长什么样
云服务器本质是物理服务器上划分出的虚拟资源,物理显卡(GPU)通过虚拟化技术被切成若干块,按需分配给不同用户使用,你看到的是“一张虚拟显卡”,但底层是实实在在的物理GPU在跑活。
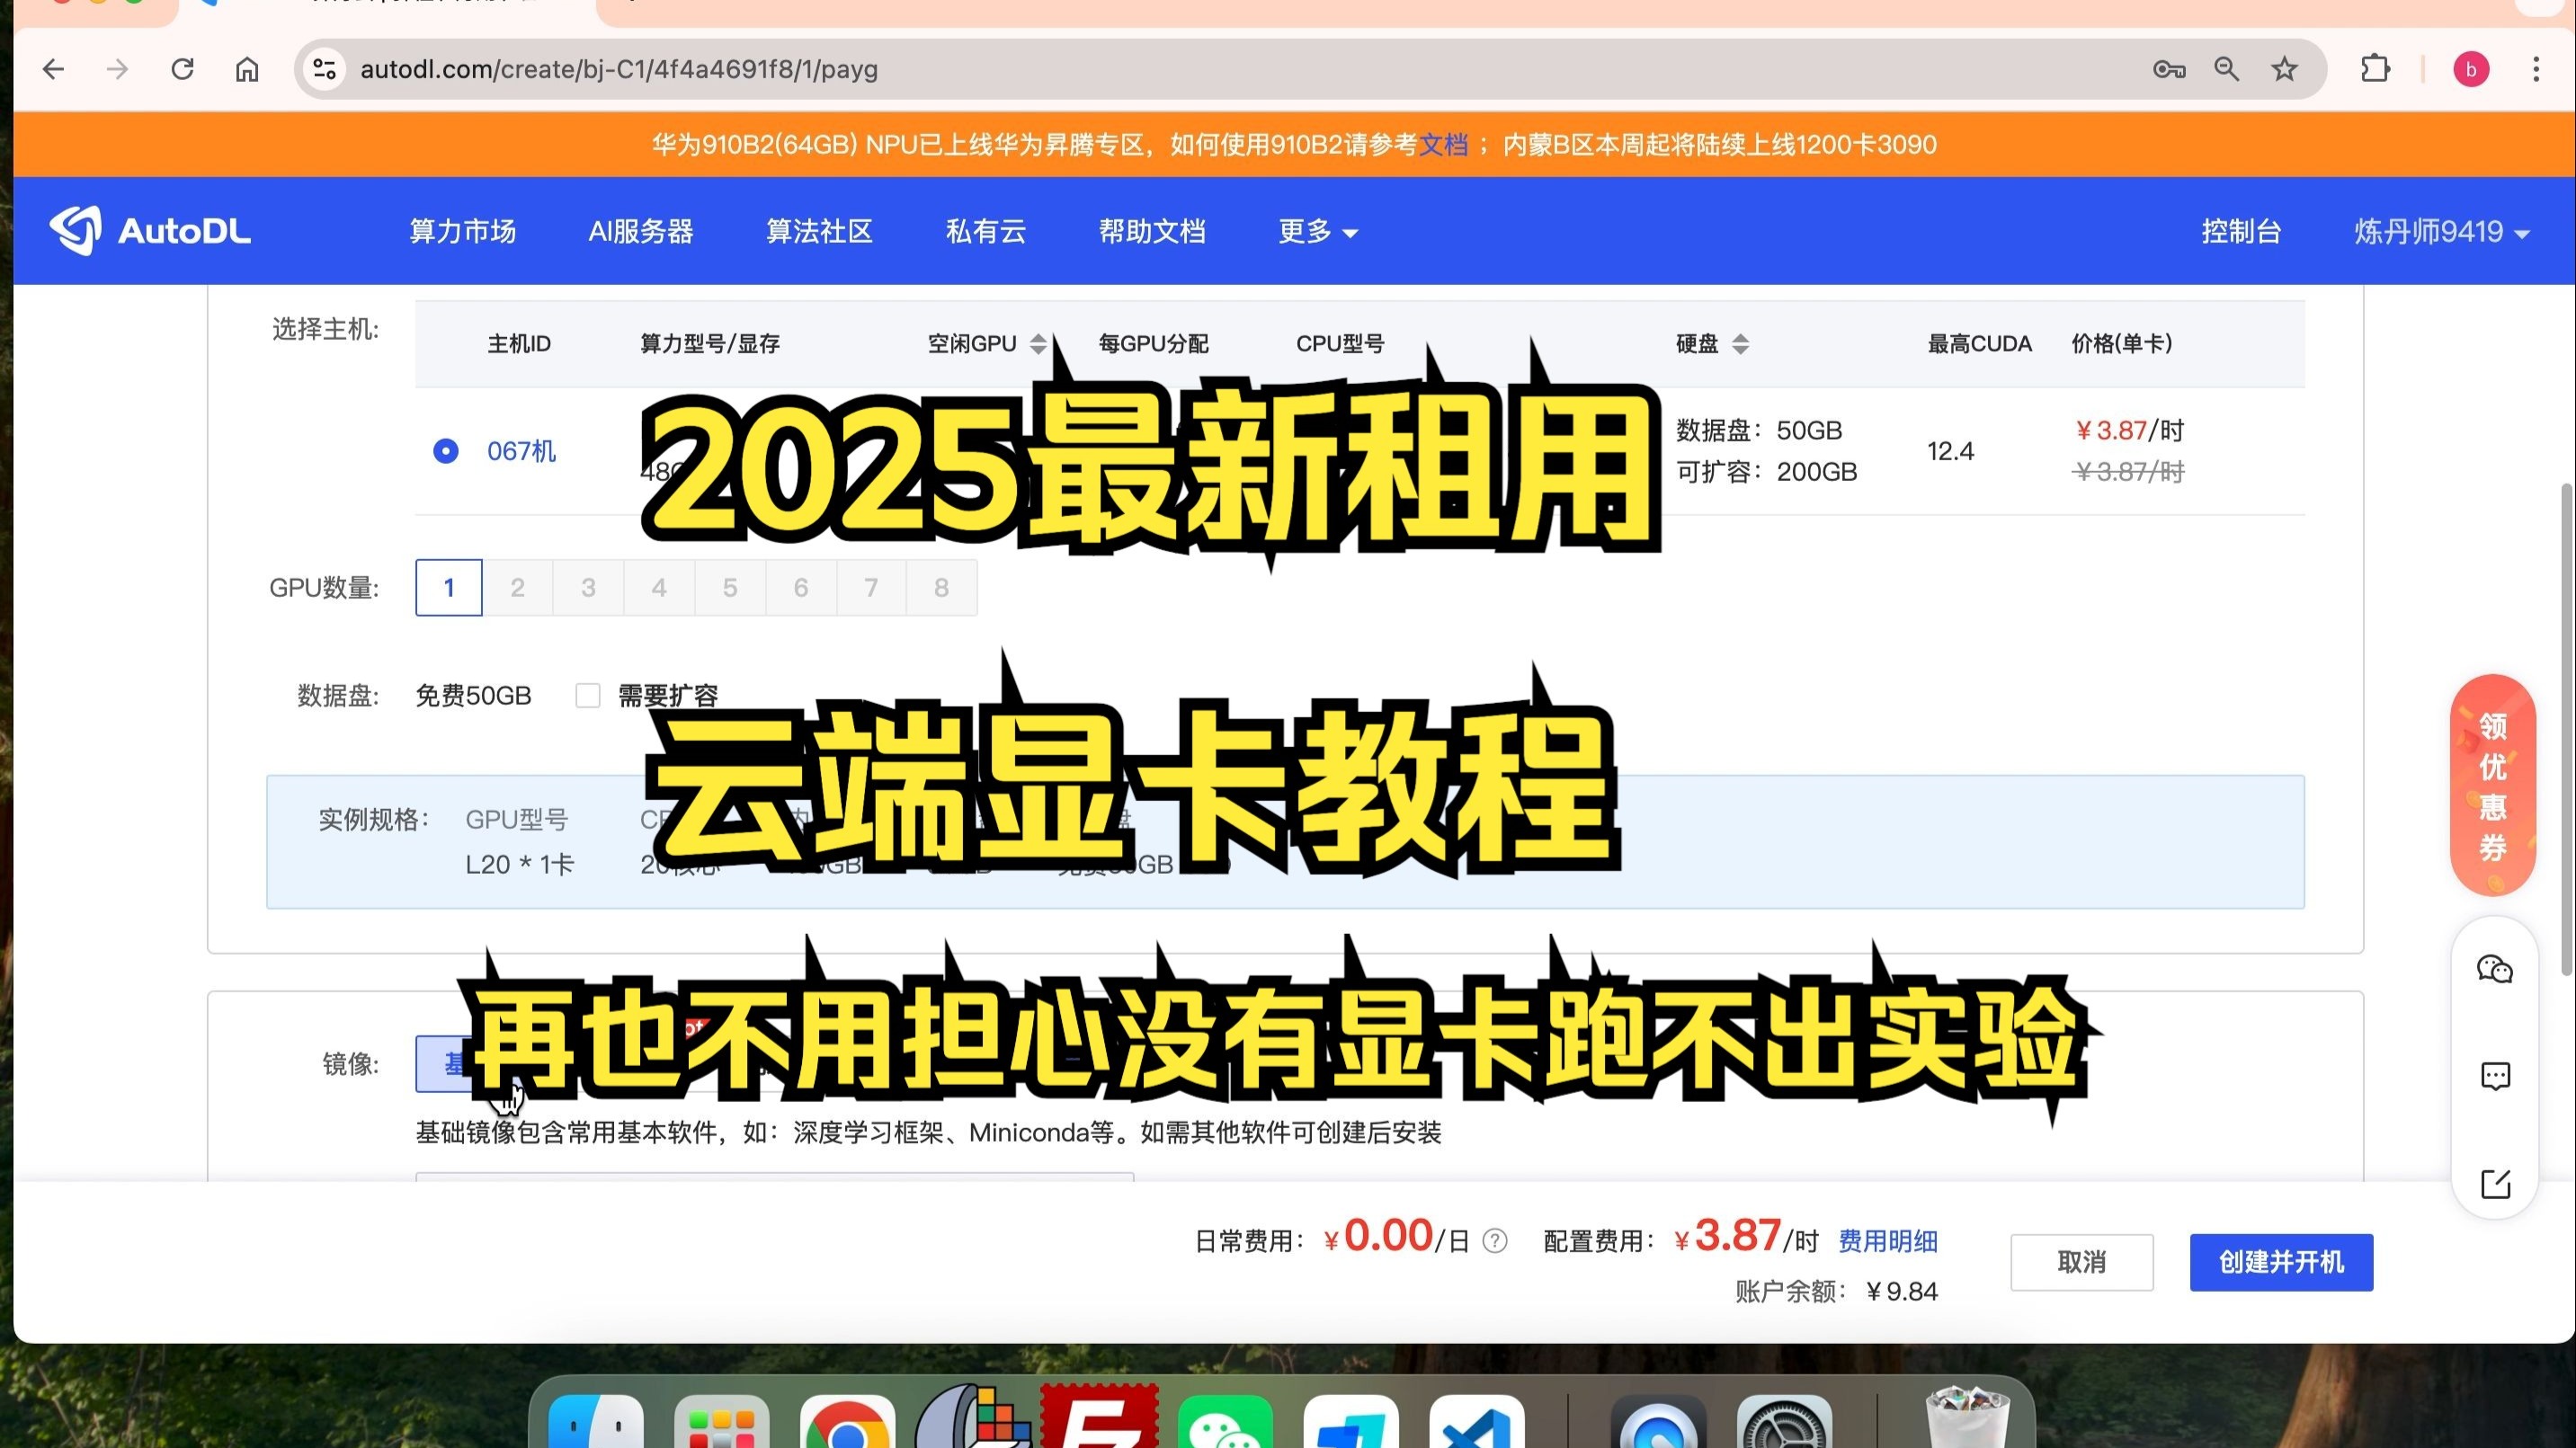
三种让云服务器获得显卡的实操路径
想要让自己的云服务器“有显卡”,具体有三条路可走,按落地难度排序:
- 直接购买GPU云服务器实例,登录主流云服务商控制台,点击“创建实例”,在实例规格里筛选“GPU计算型”“GPU推理型”或“GPU渲染型”,选择你需要的显卡型号,比如NVIDIA T4、A10、A100、RTX系列,系统镜像选择预装GPU驱动和CUDA库的公共镜像,创建完成后登录服务器,跑通一条
nvidia-smi命令,即可看到显卡状态。 - 在已有云服务器上挂载GPU能力,部分服务商支持“弹性GPU”或“GPU直通”功能,把物理GPU以独立资源方式绑定到普通云服务器上,适合那些已经跑着业务、不想重新搭建环境的用户,操作路径通常位于“实例管理”的“资源变更”或“更多操作”菜单中,绑定后需要重启实例才能生效。
- 自建私有云时,通过硬件虚拟化技术把物理GPU切分给虚拟机,这需要宿主机安装支持SR-IOV(单根输入输出虚拟化)的GPU卡,在虚拟化平台中开启“GPU直通”或“vGPU”模式,再分配给你创建的云主机,这条路径常见于企业内网或高校实验室,维护成本较高。
为什么你不能像物理机那样“装一张显卡”
物理机加显卡,拆开机箱、卡槽对准、拧螺丝、装驱动,十几分钟完成,但云服务器的计算、存储、网络资源全部虚拟化,你没有任何物理硬件操作权限,即使你使用的是裸金属云服务器,硬件规格在购买时也已锁定,不支持后期自行插拔更换。“让云服务器有显卡”的正确思路永远是:在购买或变更配置时,把GPU算力选进去。
云服务器显卡怎么选:别被“显存大”带偏
很多用户只看显存大小,觉得显存越大越好,这并不准确,显卡选型要结合业务类型、并发规模、框架兼容性综合判断。
关键参数:显存、CUDA核心数、Tensor Core和显存带宽
- 显存容量决定你能把多大的模型或数据一次性放进GPU内存,训练大模型通常需要大显存,推理任务则可以放宽。
- CUDA核心数影响并行计算吞吐量,核心越多,图形和通用计算速度越快。
- Tensor Core是NVIDIA专门为张量计算设计的加速单元,深度学习矩阵运算依赖它。
- 显存带宽决定了数据搬运速度,训练任务中这一指标往往比显存容量更能决定整体性能。
- 还要关注卡间互联技术,比如NVLink,多卡训练时,卡间通信效率直接影响加速比。
按场景选型:训练、推理、渲染与游戏
不同场景适合的显卡型号差异很大,下表把常见方向的核心选择标准列了出来:
| 场景 | 推荐显卡类型 | 重点关注参数 | 备注 |
|---|---|---|---|
| 大模型训练 | NVIDIA A100、H800 | 显存容量、卡间互联带宽 | 多卡并行时NVLink作用非常明显 |
| 推理服务 | T4、L4、A10 | 功耗、性价比、并发吞吐 | T4是入门推理很稳妥的选择 |
| AI渲染/影视 | RTX A6000、L40S | CUDA核心数、光追单元 | 需要图形驱动和OpenGL支持 |
| 云游戏/轻量图形 | RTX T4、A10通过vGPU切分 | 帧率、延迟、并发路数 | 注意服务商是否允许vGPU切片 |
一个很实用的口诀:先跑通再选最贵
你不确定自己需要多大算力,先买最低配的GPU实例,跑一个最小训练集或并发压测,观察显存占用率、GPU利用率、PCIe总线占用情况,如果显存占满但利用率不高,说明型号选大了;如果利用率100%且显存不够,需要换更大显存,行业共识认为,向下变配的成本远低于过度购买后闲置的成本。
云服务器有独显吗?虚拟显卡和物理独显的真相
“独显”意味着独立显卡拥有自己的显存和运算芯片,与CPU共享的核显完全不同,云服务器支持GPU之后,你看到的其实是一张经过虚拟化层映射的“独显设备”,从驱动和任务角度来看,它和本地独立显卡非常相似,比如能够识别CUDA核心数量、显存大小,它有两种底层形态:
- GPU直通(PCIe Passthrough):把整张物理显卡直接分配给一台云服务器,没有资源分割,这种模式下,性能最接近物理独显,适合要求低延迟的高性能计算。
- GPU虚拟化(vGPU):把一张物理显卡按显存或时间片切成多份,分给多台云服务器,每台云服务器看到的是“部分独显”,性能会受到调度和争抢影响。
业内专家指出,vGPU在降低成本的同时会带来约10%到20%的额外开销,这使得大多数用户的感知是“能用,但跑满理论性能不太现实”,这几年GPU虚拟化技术进步非常快,实际损耗因服务商实现方式而异,如果你对绝对性能敏感,购买时务必确认是直通还是切片。
GPU云服务器价格为什么差异这么大:计费方式与隐藏成本
同一个品牌、相近配置的GPU云服务器,在不同地域可能差出几倍,往往不是因为显卡本身更贵,而是你选择的计费模式和附加组件在起作用。
常见的三种计费模式
- 按量付费:按秒或小时结算,适合临时测试和弹性任务,优点是可以随时释放,缺点是单价通常最高。
- 包年包月:一次性支付一个月或一年的费用,单价低不少,适合持续跑训练任务或长期在线服务。
- 竞价实例:服务商利用空闲资源以低折扣出售,价格波动很大,可能在运行中被回收,适合无状态、可中断的短任务。
除了显卡,这些成本也容易让账单暴增
- 公网带宽:GPU实例通常配置较高,按固定带宽计费比按流量计费更容易控制预算。
- 数据盘容量:训练数据集动辄几十GB,建议用高效云盘或SSD,但存储费用会随容量线性增加。
- 镜像和快照:预装深度学习框架的镜像可能收费,快照自动备份也会产生费用。
- 地域节点选择:一线城市机房的电力、租赁成本更高,价格自然贵,偏西部的可用区往往有折扣,且延迟差别不大。
以国内主流云厂商的入门级GPU实例为例,按量付费的价格通常从每小时几毛到几元不等,但凡是搭载高端显卡的实例,比如A100,每小时单价短期内可能达到几十元,但这属于特殊场景,如果你要长期使用,拍脑袋的捷径是:预算紧张选竞价,基础业务选包月,测试选按时。
拿到带GPU的云服务器后,三步验证它真的在工作
配置选好、订单支付后,你需要亲手验证这台云服务器是否真的“有显卡”。
第一步:检查驱动和GPU可见性
SSH登录实例终端,运行:
nvidia-smi
如果输出一段表格,列出显卡型号、显存总量、驱动版本和实时功耗,说明GPU已经正常暴露给系统,如果提示command not found,需要先安装NVIDIA驱动,安装方式有两种:第一次购买时选择“预装GPU驱动”的镜像;或者手动安装与虚拟化平台匹配的驱动,注意,云服务器上不要安装普通工作站版驱动,应使用云厂商提供的定制版本。
第二步:跑一次基准测试验证实际算力
用NVIDIA CUDA工具包自带的deviceQuery脚本,或者在Python环境运行一段简单的PyTorch矩阵乘法,比较CPU和GPU的耗时差异,如果结果明显GPU更快,说明虚拟化链路通畅,想直观监控运行过程,使用watch -n 1 nvidia-smi实时观察GPU利用率、显存占用和温度。
第三步:处理常见异常
- 显示“无GPU卡”,但你已经购买成功:检查实例规格和所在可用区是否支持GPU,必要时重启实例。
- 驱动安装后
nvidia-smi报错“No devices were found”:多半是虚拟化模式不匹配,去服务商帮助中心找对应驱动。 - 训练时显存不够用:确认买的是vGPU还是直通实例,vGPU的可用显存可能被限制。
Q&A:云服务器怎么加显卡的常见疑问
云服务器能不能自己插一块物理显卡?
不能,云服务器没有物理插槽,也不提供硬件操作的入口,显卡资源只能由云服务商在后台分配,如果你需要更强GPU算力,唯一办法是通过控制台升配或者迁移到更高规格的GPU实例。
云服务器显示“显卡”和本地电脑的独立显卡一样吗?
从功能角度接近,你能看到显存、驱动、CUDA核心数,也能跑CUDA程序,从底层角度,多数云GPU实例是通过vGPU或GPU直通提供的,vGPU会带来少量性能损耗,GPU直通则基本接近物理独显,但相比本地显卡,你无法直接连接显示器,一切图形输出都走虚拟串口或网络协议。
为什么同品牌GPU云服务器在不同地域价格差这么多?
地域成本由机房电价、带宽运营商、当地供需关系共同决定,热门地域算力资源供不应求,价格水涨船高;而一些西部中部城市为吸引企业上云,会以更低折扣售卖GPU算力,行业共识认为,选址时优先考虑业务部署距离与合规要求,其次再看地域优惠,不要单纯因为低价而折腾迁移。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/774507.html