集群扩容时的数据再平衡会短时占用网络带宽,但它是可预期、可限速、可错峰的迁移流量,不是必须让业务陪跑的“带宽洪水”。 节点加进去之后,系统要把部分分片和副本挪到新节点,迁移流量会和业务流量抢同一张网卡、同一台交换机,甚至同一条专线,处理顺序别搞反:先限速,再错峰,最后才考虑加带宽。
先弄明白:再平衡为什么偏偏抢带宽
新节点上线,集群不会立刻“满血”,它要先把数据分片、副本、快照搬过去,再补齐校验和重试流量,你看到的不是一条温柔的小水流,而是一阵一阵的迁移脉冲。
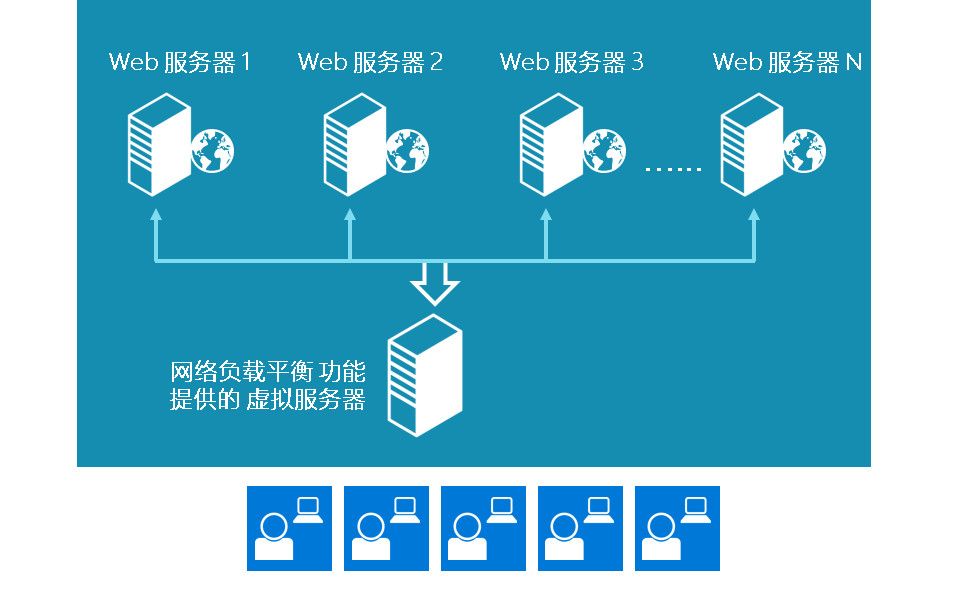
迁移的不只是数据,还有副本和校验
- 分片迁移:把部分数据从旧节点搬到新节点。
- 副本补齐:新节点追平落后副本,读写的尾部流量会增加。
- 校验与重试:迁移失败重传、校验和比对,会让实际流量高于“净数据量”。
- 元数据同步:分片路由、节点心跳、调度信息也会占一点,但不是大头。
行业共识认为,再平衡流量通常是短时脉冲,不是长期匀速,真正麻烦的是它撞上业务高峰、备份窗口或批量任务。
短时峰值常出现在扩容后的头几个小时
一个常见场景:晚上扩容,监控显示内网出口带宽短时打满,第二天早上业务接口P99升高,排查半天发现不是代码问题,而是再平衡还在跑,夜间扩容不等于没影响,备份、报表、日志归档都可能和迁移抢带宽。
集群扩容数据再平衡会影响业务吗?关键看三条链路
内网迁移链路是否和业务出口共用
如果迁移流量和业务流量走同一张网卡、同一台交换机,影响最直接,能隔离就隔离:独立网卡、VLAN、QoS限速、单独的内网平面,云上则看清是同可用区内网、跨可用区还是跨地域,计费链路和带宽上限都不一样。
副本修复与迁移并发叠加
节点故障后的副本修复还没结束,你又触发扩容迁移,两股流量会叠加,操作上先看集群健康状态,再决定是否暂停自动再平衡,或把迁移并发压到低位。
磁盘IO和网络会互相拖累
网络限速了,不代表磁盘没事,迁移写入会推高磁盘队列,iostat -x 1里await、%util异常时,业务读写也会抖,网络和磁盘要一起看,别只盯带宽。
| 策略 | 带宽峰值 | 业务影响 | 扩容时长 | 适合场景 |
|---|---|---|---|---|
| 全速再平衡 | 高 | 较大 | 短 | 测试环境、带宽冗余充足且业务低峰 |
| 固定限速 | 中 | 可控 | 拉长 | 生产环境常规扩容 |
| 错峰+限速+分批 | 低 | 小 | 最长 | 核心业务、专线带宽紧张、跨机房扩容 |
集群扩容时数据再平衡占用多少带宽?用限速和窗口把峰值压下去
先算窗口,再定限速
别上来就问“占多少带宽”,先问“我有多长窗口”,用待迁移数据量除以可用迁移窗口,得到平均带宽,再给校验、重试和副本补齐留余量,窗口越短,峰值越高,业务越容易抖。
操作顺序可以这样排:
- 统计待迁移分片或副本总量,别拍脑袋。
- 选业务低峰窗口,避开备份、批处理和发布。
- 用组件自带的并发和限速参数压峰值。
- 扩容完成后恢复默认配置,别让限速长期挂着。
常用组件的限速参数与操作路径
| 组件 | 关键参数或命令 | 作用 | 操作提示 |
|---|---|---|---|
| Ceph | osd_max_backfills、osd_recovery_max_active、osd_recovery_sleep |
控制回填和恢复并发 | 先小后大,配合ceph -s观察 |
| Kafka | kafka-reassign-partitions.sh --throttle |
限制分区迁移带宽 | 迁移完成后去掉限速 |
| Elasticsearch | cluster_concurrent_rebalance、indices.recovery.max_bytes_per_sec |
控制分片再平衡并发和恢复速率 | 用_cat/recovery看迁移进度 |
# Ceph 示例:先降并发,再观察
ceph config set global osd_max_backfills 1
ceph config set global osd_recovery_max_active 1
ceph config set osd osd_recovery_sleep_hdd 0.1
ceph -s
# Kafka 示例:迁移时限速,数值按实际窗口估算
kafka-reassign-partitions.sh --bootstrap-server broker:9092 \
  --reassignment-json-file reassign.json \
  --throttle 104857600 \
  --execute
# Elasticsearch 示例:压低再平衡并发和恢复速率
PUT _cluster/settings
{
  "persistent": {
    "cluster.routing.allocation.cluster_concurrent_rebalance": 2,
    "indices.recovery.max_bytes_per_sec": "50mb"
  }
}
监控要看“迁移流量”而不是总流量
总流量平稳不代表没问题,看迁移队列、恢复速率、重试次数和业务P99,常用命令包括sar -n DEV 1、iftop -i eth0、ceph osd pool stats、GET _cat/recovery?v。迁移流量和业务延迟一起看,才能判断限速是否到位。
集群扩容带宽不够怎么办?先限速再错峰,最后才加带宽
错峰和分批扩容
一次性加太多节点,调度器会同时触发大量迁移,分批加节点,每批完成后观察一段时间,再进下一批,把迁移窗口放在业务低峰,避开集中备份和报表任务,往往比直接升带宽更划算。
跨机房场景的取舍
跨机房扩容时,专线带宽通常更紧张,优先让副本在本地机房补齐,再做异步复制;不要一上来就跨机房全量迁移,需要走专线时,先确认QoS和限速策略,避免迁移把业务专线挤满。
云服务器集群扩容价格里,别漏算再平衡带宽成本
云服务器集群扩容价格不只看实例单价,迁移流量走同可用区内网、跨可用区还是跨地域,费用差别很大,带宽包、按流量计费、跨区流量费都要提前确认。扩容预算里给迁移窗口留带宽余量,比事后临时升配更可控。
北京集群扩容数据再平衡方案:同城双机房怎么排窗口
北京同城双机房扩容,常见难点是专线资源紧张、业务高峰集中,方案可以这样排:先确认专线余量并设置QoS,再把迁移窗口放在凌晨低峰,分批迁移非核心业务,最后用限速参数压住峰值,据工信部公开信息,近年来算力基础设施规模持续扩大,集群扩容和跨节点迁移越来越常见,提前规划迁移窗口比临时救火更稳。
Q&A:集群扩容数据再平衡与带宽占用,运维最常问什么
集群扩容数据再平衡一般会持续多久?
取决于迁移总量、并发上限、限速值和磁盘性能,限速越低,扩容窗口越长,看迁移队列是否持续下降,比只看总流量更可靠。
限速后扩容变慢,会不会影响上线计划?
会拉长窗口,但生产环境优先保业务稳定,可以把大迁移拆成多个低峰窗口,分批扩容,业内专家指出,生产环境更怕业务抖动,而不是扩容多跑几个小时。
集群扩容数据再平衡期间要不要直接加带宽?
多数情况下先限速和错峰就够,只有专线长期打满、迁移窗口无法满足上线计划时,才考虑临时升带宽包或加专线,临时加带宽能缩短窗口,但成本会上升,扩容结束后记得回退配置。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/775307.html