验证者节点CPU软中断过高的优化方向,是先量化NET_RX/NET_TX在单核上的分布,再按“减少包量、均衡中断、绑定队列、隔离CPU”的顺序调优,最后才评估换机型或换CPU。 软中断不是参数越调越稳,验证者节点更怕某一核被网络包处理长期占满,导致attestation处理出现抖动。
验证者节点CPU软中断过高怎么排查:先让数据说话
软中断高不等于CPU算力不够,它常见于P2P连接多、gossip突发、网卡队列少、单核处理包、监控抓包频繁等场景,先把“包多”“单核顶满”“进程争核”分开看。
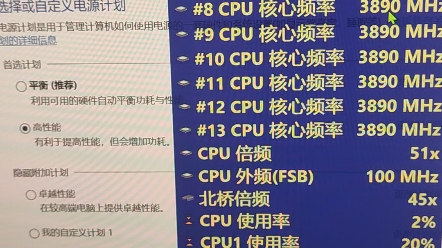
看软中断总量与单核分布
以常见Linux加systemd部署为例,先采基线:
cat /proc/softirqs,重点看NET_RX、NET_TX两列增长。mpstat -P ALL 1 30,看%soft和%sys是否集中在一两个核。sar -n DEV 1,看收发包速率和丢包。cat /proc/interrupts | grep -E 'eth|ens|enp|virtio',看网卡硬中断是否也挤在同一核。top -H或pidstat -t -p <验证者进程PID> 1,观察ksoftirqd与验证者进程是否争抢同一核。
先看单核%soft是否持续顶满,再决定加队列还是换机型。 如果总量不高但某一核长期偏高,优先查中断亲和性和RPS/XPS;如果总量随连接数上升,优先看队列数和包量。
分清网卡中断、软中断与验证者进程争核
硬中断负责通知网卡有包,软中断负责后续协议栈处理,多队列网卡会把不同队列分到不同CPU,队列太少时,包容易集中到单核,用ethtool -l eth0查看当前队列和最大队列,用ethtool -S eth0看队列丢包与错误计数。
验证者进程本身有定时任务和P2P消息处理,若与ksoftirqd同核,体感就是出块窗口附近CPU抖动,此时把验证者进程和软中断处理核适度隔离,比盲目调大所有网络参数更有效。
常见误判:磁盘IO、日志和监控抓包
软中断高有时只是表象,用iostat -x 1、vmstat 1看wa和si;若磁盘等待高,先查日志轮转和数据库写入,用tcpdump长时间抓包也会推高包处理开销,排障结束后及时停止,监控采集频率过高、容器网络多层转发,也会让NET_RX显得异常。
云服务器跑验证者节点软中断高怎么办:先调虚拟网卡队列
云主机常见virtio-net或增强型网卡,中断路径比物理机长,操作上先确认实例是否支持多队列,再小步调整。
虚拟网卡队列与中断亲和性
ethtool -l eth0查看combined队列。8核以上实例建议至少4个收发队列,16核以上再考虑8队列,前提是实例和网卡支持。ethtool -L eth0 combined 4调整队列,调整后复查/proc/interrupts是否分散。- 查看
/sys/class/net/eth0/queues/rx-/rps_cpus,必要时启用RPS做软件分流;虚拟化环境下RPS要结合vCPU拓扑,不宜全核撒开。 - 用
irqbalance自动均衡,或对关键队列手动写/proc/irq/<编号>/smp_affinity_list。 - 验证者进程用systemd的
CPUAffinity=或cgroup cpuset绑定到独立核,避开主要软中断核。
云上还有一个现实问题:部分网络处理在宿主机侧完成,租户可见的软中断只是其中一段,若队列已分散、单核仍高,先查实例规格的网络增强能力和vCPU steal,再考虑升配。
物理机与云主机验证者节点软中断对比:别只看核数
| 维度 | 物理机 | 云主机 |
|---|---|---|
| 中断路径 | 网卡到CPU路径短,可控性强 | 虚拟网卡和宿主机侧参与,路径更长 |
| 队列调优 | RSS、RPS、RFS、XPS可细调 | 受实例规格和网卡能力限制 |
| CPU隔离 | 可做isolcpus、nohz_full、rcu_nocbs | 受vCPU调度影响,隔离效果弱一些 |
| 成本形态 | 一次性硬件投入高,带宽和电力另算 | 按月计费灵活,网络增强型通常更贵 |
| 适用场景 | 长期高连接、追求稳定尾延迟 | 快速部署、弹性扩容、中小规模验证者 |
行业共识认为,验证者节点对持续在线和尾延迟更敏感,不只看峰值算力,物理机适合把队列、亲和性、CPU隔离做细;云主机则要优先选网络增强型和高主频实例,并确认多队列可用。
北京验证者节点CPU软中断调优:地域不是玄学,链路和实例规格更关键
北京地域部署验证者节点时,软中断调优参数与其他地域没有本质差异,差异主要在公网链路、跨可用区延迟和实例网络能力,若节点与RPC、beacon节点跨地域通信,重传和乱序会增加包处理压力。
- 用
ss -s、nstat -az | grep -E 'Retrans|Drop'看重传和丢包。 - 尽量让验证者、执行层和共识层节点同地域、低延迟互通,减少跨地域gossip放大。
- 检查MTU和分片,避免隧道或容器网络造成额外拆包。
- 北京地域选实例时,优先确认网络增强、多队列和带宽计费模式,别只看vCPU数量。
地域调优的核心不是改一个“北京专属参数”,而是缩短链路、减少重传、让网卡队列与vCPU拓扑匹配。
减少包量比加核更划算:验证者节点软中断优化成本
先做软件层调优,成本最低;换高主频CPU或网络增强实例,成本立刻上升,业内专家指出,验证者节点的网络瓶颈多数可以通过队列、亲和性和连接管理缓解,不必一开始就堆核。
| 调优项 | 主要收益 | 成本与代价 |
|---|---|---|
| 队列数与中断亲和性 | 把NET_RX分散到多核 | 需要停机窗口,云上受规格限制 |
| RPS/RFS/XPS | 改善单核软中断集中 | 参数不当会引入额外开销 |
| CPU隔离与cpuset | 降低验证者进程与ksoftirqd争核 | 需要规划核数,隔离过多浪费算力 |
| 限制抓包和高频监控 | 直接减少包处理量 | 影响排障粒度 |
| 升配或换高主频实例 | 提升单核包处理余量 | 月费上升,未必解决队列不足 |
协议栈参数要小步改,可查看sysctl net.core.netdev_max_backlog、net.core.netdev_budget、net.core.netdev_budget_usecs当前值,再结合丢包和%soft做回归。先做队列与亲和性,再谈换CPU,这是成本更可控的路径。
一套可落地的调优顺序
- 采集基线:
mpstat -P ALL 1 30、cat /proc/softirqs、ethtool -S eth0、nstat -az。 - 判断瓶颈:是单核顶满、全局包量过大,还是磁盘和日志干扰。
- 调队列:
ethtool -l确认能力,ethtool -L小步增加combined队列。 - 分散中断:检查
/proc/interrupts,用irqbalance或手动亲和性。 - 隔离CPU:把验证者进程绑到独立核,避开主要NET_RX核。
- 控制包量:停止长时间抓包,降低不必要监控频率,减少跨地域通信。
- 回归验证:观察
%soft、重传、attestation延迟和日志告警是否同步改善。
验证者节点软中断优化不是一次调参比赛,而是把网络包处理从单核压力变成可预期的多核分担,先量化,再调队列和亲和性,最后才评估硬件,稳定性和成本通常更平衡。
验证者节点CPU软中断过高优化Q&A
验证者节点软中断高,换高主频CPU有用吗?
有用,但要看瓶颈,若单核%soft顶满且队列已分散,高主频能提升单核包处理余量;若队列不足或中断全挤一核,换CPU收益有限,先查/proc/interrupts和ethtool -l。
云服务器跑验证者节点软中断高怎么办,调了队列还是高先查什么?
先查实例是否真支持多队列、vCPU steal是否偏高、验证者进程是否与软中断核重叠,再看重传、MTU和监控抓包,云上部分包处理在宿主机侧,租户侧参数无法完全覆盖。
验证者节点CPU软中断优化后,怎么判断效果?
看三个信号:mpstat里%soft是否从单核集中变为多核分担;nstat里重传和丢包是否下降;验证者日志中的attestation延迟和漏签告警是否减少,三项同时改善,才算调优到位。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/777169.html