大多数情况下,异常请求很难靠单个系统日志定位,真正有效的做法是把接入层、网关层、应用层、中间件层的日志串联成一条完整链路,从traceId反推入口,再逐层比对耗时与状态码的异常拐点。这套方法论我在多个项目里反复验证过,今天把它拆成一套可复制的排查流程。
全链路日志排查步骤:从接入层一路挖到应用层
很多团队排查异常请求时,习惯先翻应用日志,看到报错就复制异常堆栈去搜代码,这个做法效率极低,因为你看到的错误只是最终表现,不是根因,正确的顺序应该反过来,从流量入口一层层往下剥离。
第一步:确认异常请求的入口与特征
先回答三个问题:这个请求从哪个域名进来?走的HTTP还是HTTPS?源IP和User-Agent长什么样?这些信息全在接入层日志里,通常是Nginx或SLB的access.log。
实操中我常用的命令是:
grep "接口路径" access.log | awk '{print $1, $4, $7, $9, $10, $11}'
- 第一列是客户端IP
- 第四列是请求时间,精确到秒
- 第七列是响应耗时
- 第九列是状态码
- 第十、十一列是响应字节数和Referer
如果用这条命令捞出来的请求,响应时间明显高于P99(比如平时P99是200ms,突然变成3秒),那就说明异常不是偶发,而是有规律可循的,此时把IP和User-Agent单独提取出来,看看是否存在同一IP高频访问、UA异常缩写、或者Referer为空的情况,相当一部分爬虫和恶意扫描请求,UA字段会暴露特征。
第二步:用nginx日志分析异常请求的四个关键字段
nginx日志分析异常请求时,不用看全部字段,盯住四个就够。
状态码分布是第一个信号,如果502、504集中在某个上游服务,问题大概率在后端;如果499大量出现,说明客户端提前断开,常见于超时场景。响应时间是第二个信号,重点看upstream_response_time和request_time的差值,两者差距大,意味着耗时卡在Nginx和后端之间的网络传输上;差距小,耗时全在后端业务逻辑里。请求体大小是第三个信号,异常大的POST包通常涉及批量数据提交或恶意注入。IP地理分布是第四个信号,出现非常见地域的IP访问内部接口,基本可以判定为异常。
这四个字段用一条命令就能全量打印:
awk '{print $1, $6, $7, $9, $10, $upstream_response_time}' access.log | sort | uniq -c | sort -rn | head -20
到这里,异常请求的来源IP、路径、状态码、耗时特征就全部浮出水面了。
接口异常日志查询技巧:按traceId串起完整调用链
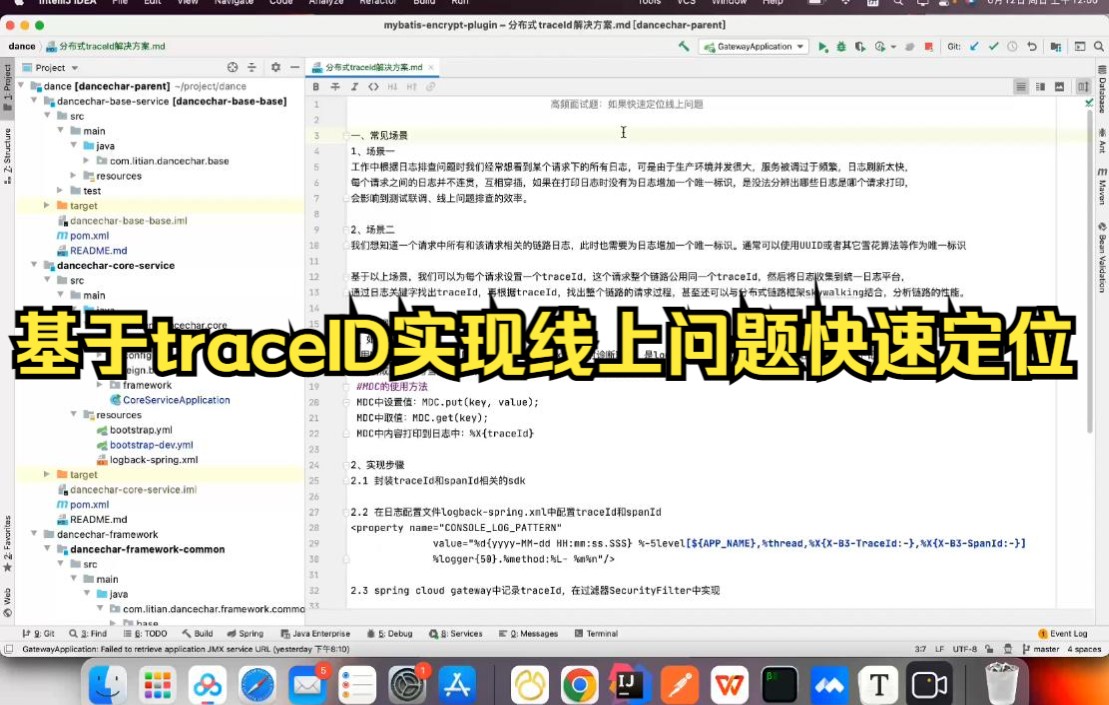
入口层定位到具体IP和路径后,下一步是进入服务端日志,如果项目已经接入全链路追踪系统,这一步会非常简单;如果还没接,就需要靠日志里的traceId硬串。
按traceId过滤日志的两种方式
直接查日志文件
在应用日志路径下执行:
grep "traceId=xxx" app.log | tail -100
这条命令会把该请求在应用内打出的所有日志全部捞出来,按时间先后排列,基本能还原处理过程。
通过日志平台检索
如果日志已经接入ELK或Loki,直接在Kibana里按traceId过滤,再把时间范围放宽到异常前后五分钟,这里有个容易被忽略的细节:要同时检索入口网关日志和下游服务日志,因为traceId在跨服务传递时,可能出现部分服务没打出来、或者被截断的情况,只查一个服务容易漏掉真实卡点。
接口异常日志查询的五个常见误区
- 只看ERROR级别,忽略了WARN级别的超时和重试信息
- 只查异常时间点的日志,没有对比同接口正常时段的日志基线
- 查了服务A的日志,没查服务B调服务C那段调用链
- 忘了查慢SQL日志和Redis慢日志,这两块往往才是元凶
- 日志时间没统一时区,排查跨服调用时对不上时间线
行业共识认为,超过一半的线上接口异常,根因不在业务代码里,而是在服务间调用的耗时和资源竞争上,所以日志查询一定要从单机思维切换到全链路思维。
日志分析工具对比:哪些方案适合不同体量的团队
针对日志分析工具对比,很多团队卡在选型上,其实不用追求最贵的,适合团队规模就好。
三套常见实施路径
轻量型方案:ELK + 自研脚本
适用于日志量日均百GB以内、团队人数少于二十人的场景,Elasticsearch存储,Logstash采集,Kibana展示,查询时写KQL或Lucene语法,配合Python脚本做基础聚合分析,成本低,上手快,但聚合能力有限,做到百分位耗时统计比较吃力。
中量型方案:SkyWalking或Pinpoint
这两款都是开源APM,自带链路追踪和拓扑图展示,部署后能自动感知服务间调用关系,不需要业务侧大改代码,追踪精度比ELK的日志级检索高一个层次,能直接看到每个服务处理该请求的耗时占比,适用于微服务数量在几十个以内的团队。
重量型方案:自建或采购商业化APM
大型互联网公司常见做法,基于Jaeger或Zipkin二次开发,配合全量采样和存储降本策略,能支撑日均TB级日志量,优点在于数据完整性高、可定制性强,缺点是运维成本大,需要专门的SRE团队维护。
一张表看清三者适用边界:
| 方案 | 部署成本 | 追踪深度 | 适合体量 | 短板 |
|---|---|---|---|---|
| ELK | 低 | 日志级 | 小型团队 | 无法自动串联服务调用链 |
| SkyWalking/Pinpoint | 中 | 服务调用级 | 中型团队 | 自定义指标能力有限 |
| 自研APM | 高 | 方法级 | 大型团队 | 需要专职团队长期维护 |
如果团队预算有限,不需要立刻上APM,先把ELK的日志检索和Nginx日志分析跑通,能解决大部分问题。
api网关日志分析:异常请求的集中观测点
网关是所有流量的必经之地,在网关层做api网关日志分析,能事半功倍,相比应用层日志,网关日志的格式统一、字段完整、采样比例高,做全局聚合分析时准确率更高。
网关日志里最值得关注的三个信号
同一账号或IP的高频访问
网关日志里把clientId和IP两个字段联合统计,如果出现单个IP在短时间内对三个以上不同接口发起访问,且每次间隔都小于一秒,基本可以判定为自动化脚本。
参数结构异常
正常的业务请求,参数键值对的数量和长度相对稳定,如果同一个接口的请求参数长度从几十字节突然变成几千字节,或者数组元素数量暴涨,大概率是扫描或注入尝试,结合返回值判断,如果后端返回了大量堆栈信息,说明参数校验没有做干净。
响应码与业务逻辑矛盾
典型的例子是登录接口返回200但响应体里没有token,或者订单查询接口返回200但数据量突然变成上万条,这类请求在网关日志里表现正常,但结合应用日志一查,往往能从SQL日志里看到全表扫描。
对网关日志的分析频次,建议每天定时跑一次全量聚合,把TOP20异常IP、TOP20慢接口、TOP20错误码清单输出到值班群,坚持两周,你会对这棵“流量树”的长势心里有数,正常业务场景里,各时段流量曲线相对平滑,异常请求通常会在午夜或凌晨形成突兀的波峰。
一次典型的攻击请求还原
实际案例中,有一次凌晨两点某查询接口响应时间从80ms飙到5秒,从nginx日志分析异常请求发现,来源IP集中在某个网段,UA是空字符串,请求路径带了一长串十六进制字符串,顺着traceId进应用日志,发现请求把数据库内存表的数据全量遍历了一遍,定位到根因后,在网关层加了一条IP段拦截规则,接口响应立刻恢复正常,这类问题靠应用日志也能查,但排查耗时至少两小时;有链路日志打底,二十分钟就能收工。
全链路追踪系统怎么选:结合成本与团队能力
网上关于全链路追踪系统怎么选的文章很多,核心就三个维度:协议标准、存储开销、团队学习成本。
协议标准尽量靠拢OpenTelemetry,这是社区的主流方向,选老牌Jaeger的话,生态成熟度最高,坑最少,存储开销要重点关注采样策略,全量采样在小流量下没问题,大流量下存储成本翻倍增长,需要配置比例采样或尾部采样,团队学习成本上,如果团队主要用Python和Go,Pinpoint基于Java字节码增强,用起来就不太顺手,不如选SkyWalking或Zipkin。
有一种情况可以暂时不上链路追踪:服务总数少于十个,且都是单机部署,此时靠日志里的请求ID串连各个服务,效率也不差,一旦服务数量超过二十个,靠人工串日志就是灾难,必须上系统。
常见问题定位速查表
| 现象 | 优先排查位置 | 关键日志字段 |
|---|---|---|
| 请求全部超时 | Nginx upstream耗时 | upstream_response_time |
| 偶发超时 | Redis慢日志 | 命令执行耗时 |
| 401/403波动 | 网关鉴权日志 | 鉴权插件耗时 |
| 数据写入丢失 | 应用日志中的重试标记 | retry_count |
六类场景里,前四类占了线上异常请求的绝对大头,定位思路一致:先用网关日志锁定入口和时段,再用traceId进入调用链,最后看下游资源消耗。
日志链路本身不产生业务价值,但它在关键时刻能帮你省下几小时的排查时间,当线上报警响起时,拥有清晰全链路日志的团队,和没有这套能力的团队,面对同等故障的心态和处置速度完全不同,把链路日志搭好,本质上就是给运维和开发买了一份看不见的保险,每一次快速定位异常,都是这份保险在兑现。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/784097.html