先用限流把入口流量整形到系统容量内,再用熔断隔离下游依赖故障,最后用降级兜住用户体验;三者按“入口限流应用限流依赖熔断业务降级”的顺序分层生效,并通过规则联动和压测演练闭环。
很多团队一上来就问“限流和熔断降级先做哪个”,其实答案不复杂:限流保自己,熔断保依赖,降级保体验,下面按配合顺序拆开讲。
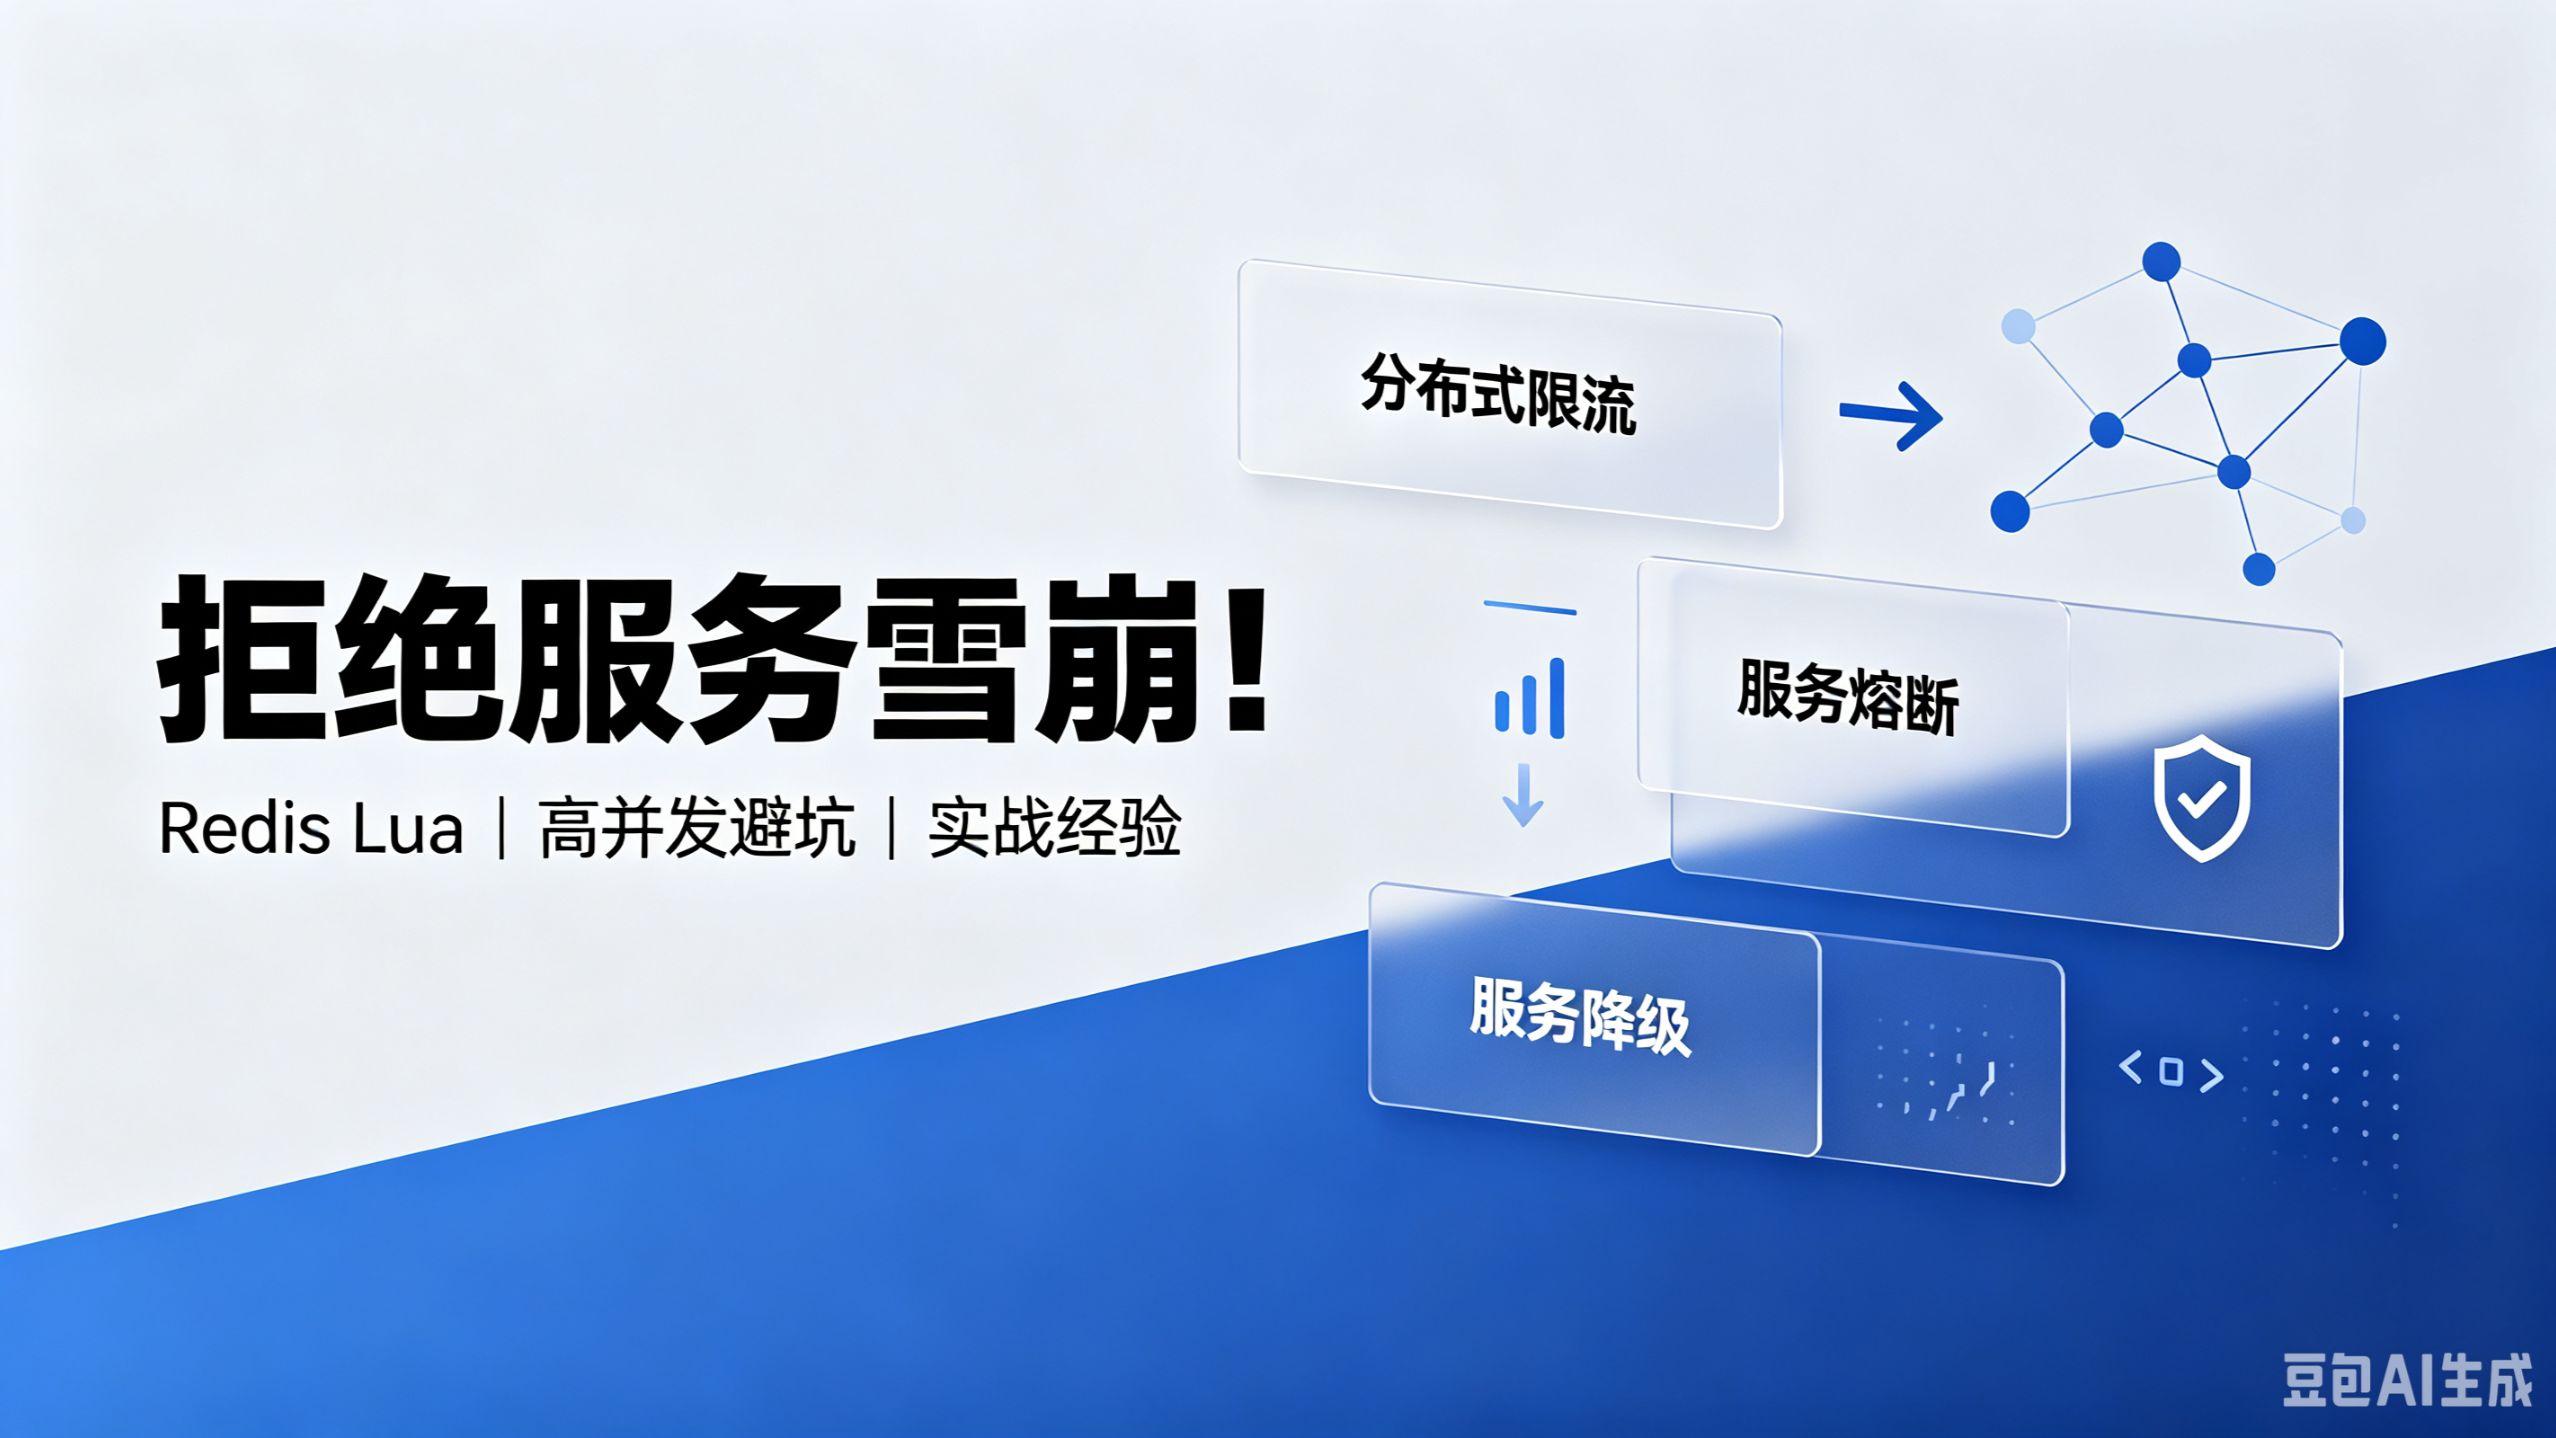
业务侧限流和熔断降级有什么区别与联系
限流和熔断经常被放在一起说,但两者保护的对象不同,限流管的是“进来多少”,熔断管的是“下游还行不行”,混淆两者,最容易出现“入口没崩、下游先挂”或者“熔断乱开、正常请求被误杀”。
| 维度 | 业务侧限流 | 熔断降级 |
|---|---|---|
| 保护对象 | 自身系统容量、线程池、数据库连接 | 下游依赖、调用链、自身线程资源 |
| 触发信号 | 入口QPS、并发数、队列长度 | 下游RT、异常率、慢调用比例 |
| 动作 | 排队、拒绝、削峰、令牌桶放行 | 快速失败、半开探测、返回兜底 |
| 恢复方式 | 流量下降后自动恢复 | 时间窗口结束后半开试探 |
| 关键指标 | 通过率、拒绝率、排队时长 | 熔断状态、失败率、恢复时间 |
限流和熔断降级先做哪个
先做入口限流,再做依赖熔断,原因很直白:入口流量不控,系统会被瞬间打满,后面熔断再灵敏也救不回来,顺序上可以按这个路径落地:
- 在网关层配置粗粒度限流,挡住明显超量的请求。
- 在应用内对核心接口做细粒度限流,控制线程池和信号量。
- 对下游依赖配置熔断器,隔离慢调用和异常。
- 对非核心功能配置降级开关,优先保住交易和登录链路。
高并发场景下限流熔断怎么配合才不误伤
高并发场景下,限流和熔断的统计窗口要分开,限流通常看秒级QPS和并发,熔断通常看10秒到30秒的慢调用比例和异常率。不要把限流触发直接联动成熔断,否则入口一削峰,下游熔断器可能被误触发,恢复时又反复震荡,更稳的做法是:限流规则管入口,熔断规则管依赖,降级规则管业务优先级,三者各自独立配置、统一演练。
业务侧限流与熔断降级的协同工作机制
第一层:网关入口限流,先挡住超量请求
网关层适合做第一道闸门,以Nginx为例,可以在测试环境先验证:
limit_req_zone $binary_remote_addr zone=api_limit:10m rate=200r/s;
server {
    location /api/order {
        limit_req zone=api_limit burst=100 nodelay;
        proxy_pass http://order_service;
    }
}
操作路径上,先压测得到单机容量,再把网关限流阈值设为容量留有余地的值,北京电商大促限流熔断配置时,常见做法是网关只做粗粒度限流,应用内再做细粒度限流,避免一个规则管所有接口。
第二层:应用内业务限流,保护核心接口
应用内限流要落到接口级,Sentinel控制台的操作路径是:应用列表 → 规则管理 → 流控规则 → 新增,资源名填接口路径,阈值类型选QPS或并发线程数,流控模式按场景选直接、关联或链路,核心交易接口用线程数隔离,查询接口用QPS限流,非核心接口可以直接降级关闭。
第三层:依赖熔断,隔离下游故障
熔断器通常有closed、open、half-open三个状态,下游RT升高或异常率上升时进入open,快速失败;时间窗口结束后进入half-open,放少量请求试探;试探成功再恢复closed,Resilience4j的配置示例:
resilience4j.circuitbreaker.instances.orderService:
  slidingWindowSize: 100
  failureRateThreshold: 50
  waitDurationInOpenState: 30s
  permittedNumberOfCallsInHalfOpenState: 10
业内专家指出,限流和熔断不是二选一,而是前后两道闸门,熔断阈值要结合历史RT和错误率来定,不能拍脑袋。
第四层:降级兜底,保住用户体验
降级是最后一道防线,核心交易链路可以返回排队页或稍后重试提示,查询接口返回缓存数据,非核心功能直接关闭入口,降级开关要放在配置中心,支持按接口、按用户分群、按地域灰度,降级动作要和熔断状态解耦,避免熔断一开就把所有业务都降掉。
业务侧限流和熔断降级如何联动配置与演练
规则联动:限流触发后是否要熔断
多数情况下,不建议限流触发后立刻熔断下游,限流是主动削峰,熔断是被动隔离,两者触发原因不同,联动配置可以这样做:
- 限流规则观察入口QPS、并发数和拒绝率。
- 熔断规则观察下游RT、异常率和慢调用比例。
- 降级规则观察业务成功率和核心链路可用性。
- 通过配置中心统一推送规则,保留版本号和回滚开关。
行业共识认为,熔断阈值不能拍脑袋,要基于历史RT和错误率,规则上线前先在测试环境跑一遍。
状态同步:从单机到集群
单机限流和集群限流要分开看,单机限流配置简单,但集群整体容量容易偏;集群限流需要统一令牌桶或网关全局限流,熔断状态也要考虑集群同步,避免一台机器熔断、另一台还在打下游,实操上可以把规则持久化到配置中心,应用启动时拉取,运行时监听变更。
演练闭环:用压测验证配合效果
演练步骤可以按这个顺序走:
- 在测试环境用
wrk -t4 -c200 -d60s http://api.example.com/order压入口流量,观察限流拒绝率和排队时长。 - 用
tc qdisc add dev eth0 root netem delay 500ms模拟下游延迟,观察熔断器是否进入open。 - 检查降级开关是否按预期返回缓存或排队页。
- 恢复下游延迟,观察half-open试探和closed恢复过程。
- 记录限流阈值、熔断窗口、降级策略的联动效果,再回到生产灰度。
限流熔断组件选型与成本大概多少
限流熔断降级策略配置成本大概多少,取决于选开源还是商业方案,开源组件没有License费用,成本主要在规则维护、压测演练和值班人力;商业网关按实例和功能收费,具体以报价为准,常见组合是Nginx做入口限流、Sentinel做应用内流控和熔断、Resilience4j做代码级熔断、配置中心做规则下发,选型时重点看规则能力、集群支持、控制台易用性和团队熟悉度,不要只看价格。
最后把配合关系落成一句话:先限流保自身,再熔断保依赖,最后降级保体验;规则分开配置、指标分开观察、演练合在一起做。
业务侧限流和熔断降级如何配合的Q&A
限流和熔断降级先做哪个?
先做入口限流,再做应用内限流,最后做依赖熔断和业务降级,入口不限流,系统容量会被瞬间打满,熔断只能被动救火。
高并发场景下限流熔断怎么配合才不误伤?
限流看秒级QPS和并发,熔断看10秒到30秒的RT和异常率,统计窗口分开;限流触发不直接联动熔断,熔断恢复走half-open试探,降级按业务优先级独立配置。
限流熔断降级策略配置成本大概多少?
开源组件没有License费用,主要成本在规则维护、压测演练和值班人力;商业方案按实例和功能收费,具体以厂商报价为准,成本评估要把规则变更频率和故障演练投入算进去。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/784730.html