单细胞服务器并不对应某个固定型号,而是围绕单细胞测序数据分析流程配置出来的一类机器,主流形态就三种:本地大内存工作站、Slurm 计算集群、云服务器,选哪种取决于数据量、团队规模和预算。
单细胞服务器有哪些形态?先搞清楚它要解决什么问题
单细胞测序的数据链条比 bulk RNA-seq 重不少,上游 Cell Ranger 做比对和定量时,要把 reads 一次性压进内存;下游 Seurat、Scanpy 又要反复读写表达矩阵,所以所谓“单细胞服务器”,本质是按这套流程的瓶颈反推出来的配置组合,并非厂商目录里的固定分类。
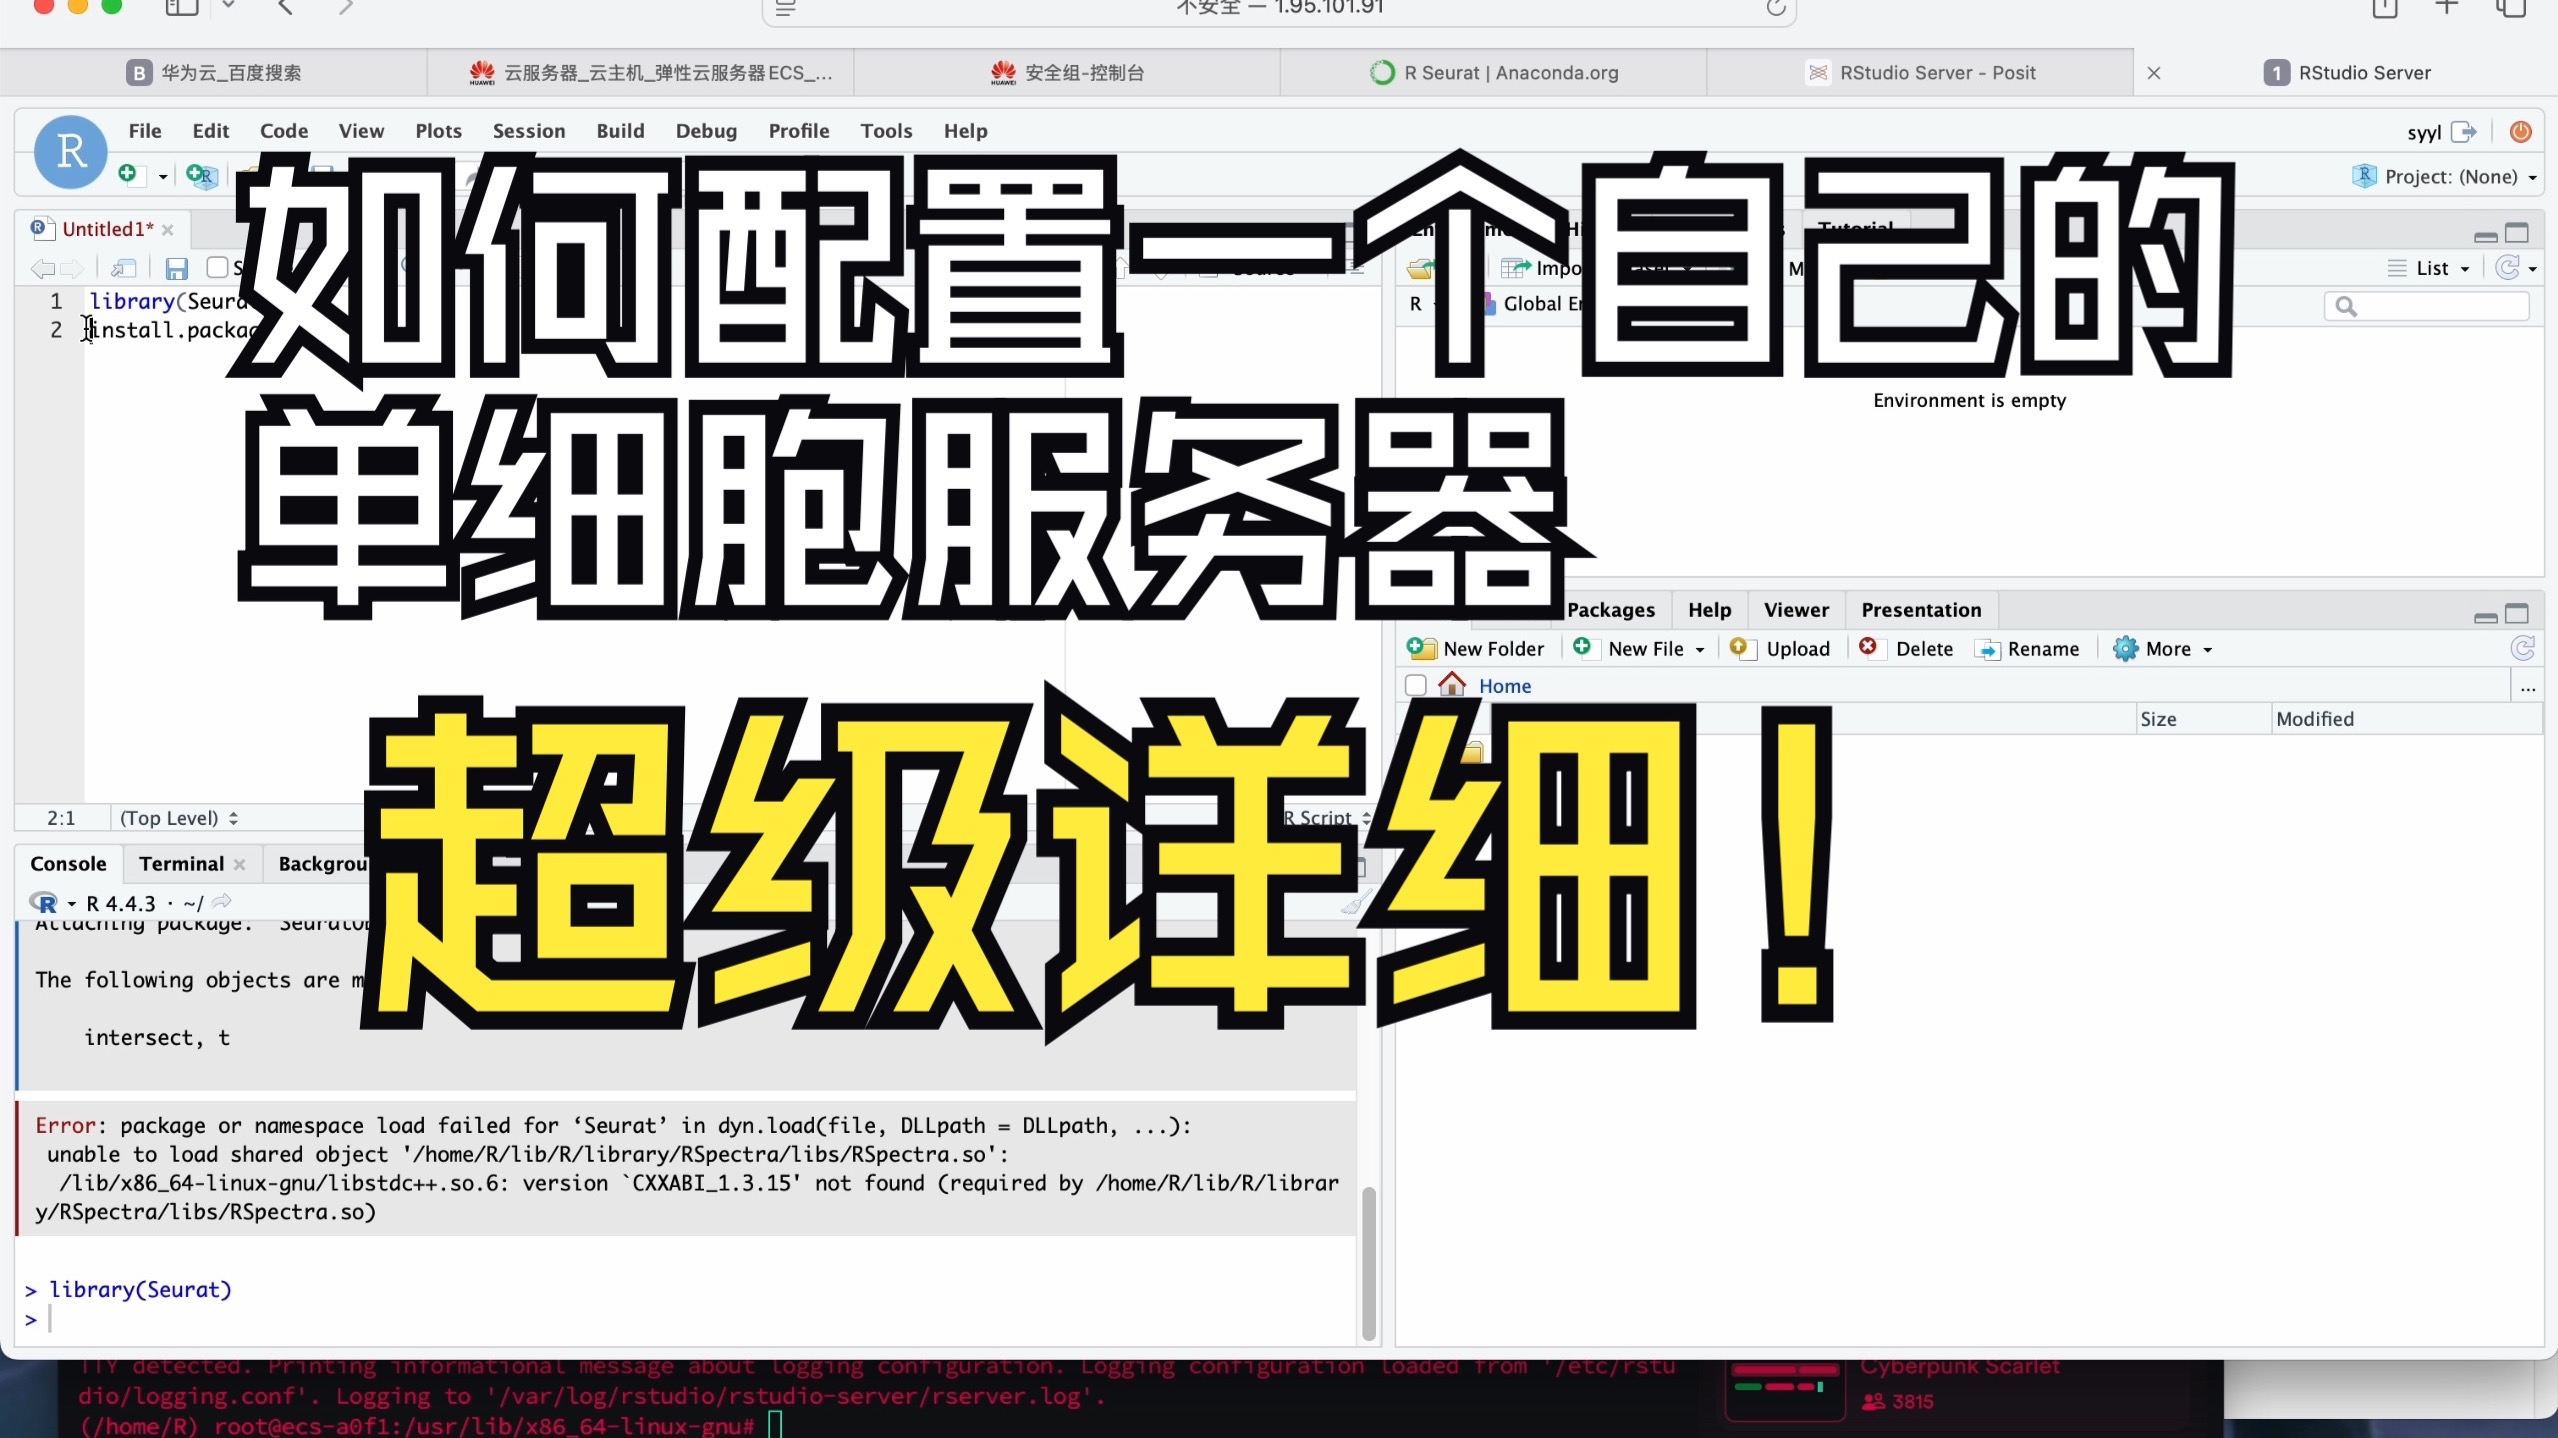
它和普通业务服务器差在哪
- 内存优先于核心数,多数流程卡在内存,而不是 CPU 算力
- 存储 IO 压力大,BAM、fragments、h5ad 动辄几十 GB,小文件还特别多
- 长时间在线,一个项目要连续跑几天,稳定性比峰值性能重要
- 可选 GPU,常规流程用不上,深度学习方法、空间转录组图像处理才真正吃卡
先给自己的机器做一次基础检查
不用急着买,先跑几条命令看清现状:
free -h
lscpu | grep -E "^CPU\(s\)|Model name|Thread"
df -h /data
nvidia-smi
free -h 显示的可用内存不到 100GB,跑多样本 Cell Ranger 基本就要排队等。df -h 里数据盘剩余空间不足两三百 GB 时,一个空间转录组项目就能把盘写满。
三种主流部署形态:本地工作站、集群、云服务器
本地塔式或机架式大内存工作站
这是最常见的选择,一台机器,装 Ubuntu 或 Rocky Linux,配好 Cell Ranger、R、Python 环境,用 conda 或 micromamba 管理依赖。
适合样本量稳定、数据不便外传、团队三五人的场景,实际路径很简单:系统装好后建一个分析账户,数据盘挂到 /data,长任务用 tmux 或 screen 挂起来跑,断开 SSH 也不会中断。
Slurm 计算集群
样本上百、多人共用时,单机就不够看了,得上集群,登录节点只负责编辑和提交任务,计算节点负责实际运算。
sinfo
sbatch run_cellranger.slurm
squeue -u $USER
集群的关键不在算力,在共享存储,NFS 能撑中等规模,数据量再大就要考虑 Lustre 或并行文件系统,否则多节点同时读写一个目录会卡得很难受。
云服务器与生信云平台
简米云、酷番云、华为云都提供大内存实例和 GPU 实例,生信云平台则把 Cell Ranger、Seurat 环境预先装好,优点是弹性,缺点是长期跑账单不好看。
实操路径:先挂载对象存储,再把参考基因组放到本地云盘,环境用 conda 重建,参考基因组最好只传一次,反复从对象存储读会很慢。
| 形态 | 适合场景 | 优点 | 短板 |
|---|---|---|---|
| 本地工作站 | 中小团队、数据敏感 | 一次投入、数据不出门 | 扩容难、要自己运维 |
| Slurm 集群 | 多人共用、样本量大 | 排队调度、利用率高 | 建设周期长、门槛高 |
| 云服务器 | 项目波动、临时爆量 | 弹性、免硬件采购 | 长期成本高、流量费 |
单细胞分析服务器配置要求:内存、GPU 与存储怎么配
内存是第一瓶颈
10x Genomics 官方安装文档对 Cell Ranger 给出的最低内存要求是 64GB 量级,推荐值翻倍到 128GB 左右,人类参考基因组索引解压后本身就在 30GB 量级,比对阶段还要额外占用。
按实际项目经验:
- 单个 10x 3′ 样本常规分析,128GB 内存量级够用
- 多样本并行、aggr 合并、单细胞多组学,256GB 起步更稳
- 空间转录组、单细胞 ATAC,视数据量上到 512GB 或更高
- 想同时挂几个任务跑,直接按 1TB 规划
内存宁可多配,后期加条往往比换整机更麻烦。
存储与 IO:小文件是隐形杀手
- 系统盘和项目盘分开,项目盘用 NVMe SSD,容量按可预见的一年数据量规划
- 中间文件放本地 scratch,定期归档到 NAS 或对象存储
- 别用机械盘跑 Cell Ranger,IO 等待会明显拉长
- 原始 fastq 至少留一份异地备份
单细胞数据的小文件数量很吓人,拆分 BAM、fragments 文件、矩阵目录,动辄几万到几十万个文件,文件系统选型不对,ls 都要等半天。
GPU 不是刚需,但看研究方向
常规 Cell Ranger 加 Seurat、Scanpy 的流程,对 GPU 没有依赖,GPU 真正起作用的地方是:
- scVI、scGPT 这类深度生成模型训练
- 空间转录组的组织切片图像处理
- 用 RAPIDS、cuML 加速降维和聚类
- 部分大样本整合方法的 GPU 实现
如果课题组做方法学或空间组学,配一张显存 24GB 以上的卡比较合适;只做常规表达分析,这笔钱可以先省。
行业共识认为,单细胞服务器最容易配错的是内存和存储的比例,CPU 核心数往往过剩,内存和磁盘 IO 先成为瓶颈。
单细胞分析服务器多少钱?自建与云上成本拆解
价格是决策里最现实的一环,配置差异会让报价拉开好几倍。
自建的三档预算
- 入门单机:128GB 内存、16 到 24 核、2TB NVMe,几万元级别
- 中端:256 到 512GB 内存、32 到 64 核、4TB 以上全闪,十万元级别
- 高端:1TB 以上内存、双路 CPU、GPU、全闪加万兆网,几十万元
品牌上戴尔、联想、浪潮、超微都有对应产品线,也可以找本地集成商按配置单装机,塔式机箱更便宜,机架式方便进机房。
云上的成本结构
按量付费适合“跑一阵就停”的项目,包年包月适合长期稳定使用,主要成本项包括实例规格、云盘和对象存储、公网流量与跨区传输、快照备份,大内存实例单价高,这是云上跑单细胞最贵的地方。
一次性跑一个 10x 样本的 Cell Ranger,云上按量成本在几十到上百元量级,但项目密集时天天开机器,一年下来可能接近一台中端工作站的价钱。
容易被忽略的隐性成本
机房空间、电费、UPS、运维人力、系统升级、硬盘故障更换,这些都不在报价单上,云上则是长期账单和数据迁移成本,按三年周期算总账,比只看采购单价靠谱。
高校实验室单细胞服务器怎么选
高校场景比较特殊:经费按年度拨、采购走招标、学生流动快。
- 优先选内存可扩展的机箱,留足内存插槽和硬盘位
- 显卡预算紧张时先不上,但留出 PCIe 插槽和供电
- 系统装 LTS 版本,别追新
- 数据盘和系统盘分开,方便日后重装
- 先跟学校计算中心确认能否接入共享集群,能接就省一笔
业内专家指出,实验室采购最容易出问题的是“一步到位”的心态,设备买回来两三年后数据量翻几倍,内存无法扩展就只能换整机。
生信分析服务器和云服务器哪个好?看三个场景
数据涉密或样本量大
临床样本、人类遗传资源相关数据通常要求本地存储,这种情况本地服务器没有替代方案,数据量长期累积到几十 TB 时,云上的存储账单也会很难看。
项目波动大
课题组的项目验收期集中在年底,平时机器闲着,这种就该用云,按需开机,用完释放。
团队没有运维人手
没人愿意管系统升级、硬盘故障、Slurm 配置,云服务器或者学校计算中心是更省心的选择。
折中方案很常见:本地放一台中端机器做日常分析和数据存储,重型任务临时上云,云上跑完再把结果拉回来:
rclone sync remote:project ./project --progress
用对象存储的话,ossutil cp -r oss://bucket/project_result/ ./result/ 也可以,注意把参考基因组和临时文件排除掉,只拉结果。
关于单细胞服务器的常见问题
单细胞服务器配置要求里,内存到底要多大才不卡?
看数据类型和并行度,10x 3′ 常规单样本,128GB 内存量级能顺畅跑完 Cell Ranger;同时跑两个以上样本,或者做 aggr 合并、单细胞多组学、空间转录组,256GB 起步更稳妥,运行前用 free -h 看可用内存,给参考基因组加载留出余量,比看标称值更实际。
单细胞分析服务器多少钱,自建和云上怎么比?
不要在“一次性投入”和“每月账单”之间直接对比,按三年周期算总账,自建把硬件、电费、机房、运维加在一起;云上把实例、存储、流量和迁移成本加在一起,一年里大半时间机器满负荷跑,自建通常更划算;只是集中几个月用,云更合适。
没有 GPU,单细胞服务器还能做分析吗?
能,Cell Ranger、Seurat、Scanpy 的主流程都是 CPU 计算,GPU 只在深度学习方法、空间转录组图像处理和部分降维加速中有明显收益,先用 CPU 把流程跑通,等确实遇到模型训练慢的问题再考虑加卡,是更务实的顺序。
单细胞服务器怎么配,本质是一道匹配题:把数据量、并行需求和团队规模对上内存、存储和部署形态,比一味追高配置有用得多,先摸清自己的数据规模,再决定买机器还是开云主机,这笔钱就不容易花错。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/786328.html