h3c服务器怎么远程查看日志?先记住这三个入口
远程查看H3C服务器日志,首选SSH登录后查看系统日志文件,其次用HDM网页管理界面,最后是日志服务器集中采集。 这套组合基本覆盖了从单台排障到批量运维的全部场景,下面把每条路拆开讲清楚,包括具体命令和操作路径。
SSH命令行查日志,最直接也最常用
H3C服务器底层跑的是Linux系统,所以远程查看日志本质就是SSH上去翻文件,这条路径适合所有习惯命令行操作的运维人员,也是解决“h3c服务器怎么远程查看日志”这个问题时优先级最高的答案。
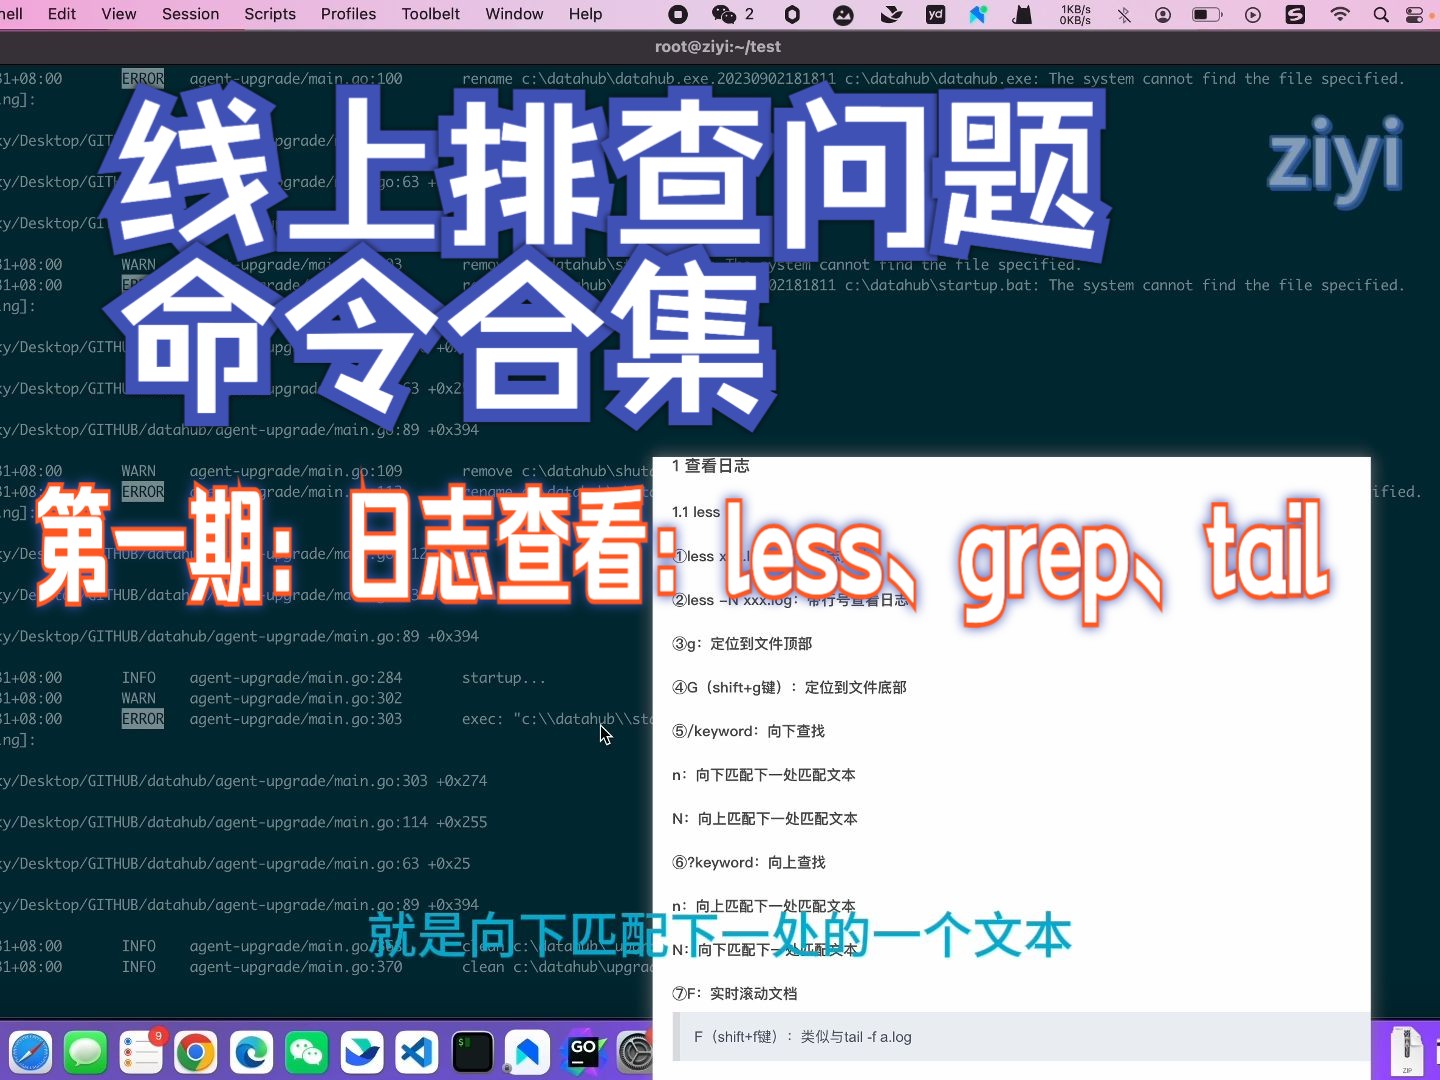
具体步骤如下:
- 用SSH工具(Xshell、PuTTY、Windows Terminal都行)连接服务器管理IP或业务IP,端口默认22。
- 输入用户名密码登录,普通用户先执行
sudo su -切换到root,避免权限不足看不到日志。 - 进入日志目录
/var/log,用ls -lh按时间倒序查看日志文件列表。 - 按需执行查看命令,常见命令组合如下。
| 需求 | 命令 | 适用场景 |
|---|---|---|
| 看系统整体日志 | tail -f /var/log/messages |
实时候跟踪硬件告警、内核报错 |
| 查登录记录 | last -n 50 |
排查异常登录和SSH爆破痕迹 |
| 看系统启动过程 | journalctl -b |
确认开机阶段是否有硬件初始化失败 |
| 查某服务状态日志 | journalctl -u network -n 200 |
网络服务起不来、DHCP获取失败 |
| 看内核级错误 | dmesg \| grep -i error |
内存ECC报错、硬盘链路中断 |
| 按关键字搜日志 | grep -i "fail\|error" /var/log/messages |
全局排查同一类故障 |
新手容易忽略的一点是:H3C服务器自带HDM管理芯片,在BIOS自检阶段就产生的日志(比如内存报错、CPU温度异常),操作系统层看不到,得去HDM里翻,所以SSH查日志适合系统层问题,硬件层问题记得去HDM。
另外提醒一句:如果发现日志文件体积异常大,多半是某个服务疯狂打印错误信息,先用 du -sh /var/log/ 按大小排序定位,再处理对应服务,别直接删日志文件,不然问题线索就断了。
HDM网页管理界面,鼠标点一点就能看
行业共识认为,HDM(H3C Device Manager)是所有H3C服务器内置的带外管理平台,相当于服务器自带的“小电脑”,只要接上管理网口、通了电,就算操作系统崩溃了它也能访问,这套界面解决的是“h3c服务器远程查看日志”里那些不需要命令行、但更直观的查看场景。
操作路径:
- 用浏览器访问HDM管理地址(默认是服务器背部标注的MGMT口IP,出厂时厂家会通过邮件或标签告知初始登录参数),支持HTTP/HTTPS协议。
- 登录后左侧菜单找到“系统” → “系统日志”,这里能看到HDM自身记录的操作日志、安全日志、事件日志。
- 想要硬件告警记录,进“传感器信息”或“事件日志”页面,里面按时间列出温度、电压、风扇转速异常记录。
- HDM支持把日志导出到本地,在“日志管理”模块点“导出”按钮,保存为文件后发给硬件厂商排查。
HDM最大的价值在于“带外”两个字,举一个真实场景:某机房一台服务器突然宕机,SSH根本连不上,这时候用HDM登录进去,直接看最后的系统事件记录,能准确判断是AC断电、CPU过热保护还是内存故障触发宕机,这种场景下,HDM是唯一可靠的日志来源。
如果你管理的机器超过十台,HDM逐个登录翻日志的效率就比较低了,可以考虑启用HDM的SNMP trap或Syslog转发功能,把全部服务器的硬件日志集中到一个日志服务器上,被动接收告警,这样不用等业务挂了才想起来查日志。
配置集中日志服务器,让H3C服务器主动把日志送上门
当服务器数量上来以后,“远程查看H3C服务器日志”这件事就变成“如何让所有日志在一个屏幕上流动起来”,前两种方式属于“人找日志”,集中式方案属于“日志找人”。
部署思路不复杂:
- 选一台虚拟机或低配物理机做日志服务器,装好ELK(Elasticsearch + Logstash + Kibana)开源组件或者商业方案(如Splunk),国内使用较多的是开源的Loki+Grafana组合,资源占用更低。
- 在H3C服务器上编辑
/etc/rsyslog.conf,在末尾追加一行:. @日志服务器IP:514保存后重启rsyslog服务(
systemctl restart rsyslog),系统日志就实时转发走了。 - 想连硬件日志一起收,就在HDM界面配置“远程日志”功能,填上日志服务器IP和端口,H3C服务器固件版本Prometheus窗口期内,这项功能是免费的。
- 在日志服务器上配置一个简单的过滤规则,把级别为err及以上的日志单独打个标签,配合告警插件推送到钉钉或企业微信。
这样做的好处很明显,日志不会因为磁盘写满而丢失,排查问题时可以用关键词跨服务器搜索,做安全审计也方便,需要注意,SELinux开启状态下rsyslog发送UDP到外部端口会被拦截,如果日志没过来,检查一下 /var/log/audit/audit.log,并修改相应策略让SELinux放行网络日志传输。
h3c服务器日志命令:SSH登录后该敲什么
很多人在网上搜“h3c服务器日志命令”,但官方产品文档里其实没有一套像网络设备那样子系统化的“日志命令集合”,因为H3C服务器是标准Linux环境,直接使用Linux标准日志命令即可,不需要额外装任何H3C专属命令工具,所以别再费劲找命令手册了,把上面表格里的Linux命令吃透就够用。
需要区分的是,如果你用的是H3C自家的CAS云计算管理平台,查看宿主机日志是通过命令行工具 cassrv 相关的系列命令实现的,跟裸机服务器直接看日志是两条路径,跑KVM虚拟化的话,虚拟机日志在宿主机上用 virsh 相关命令也能查。
这里给出一套最简洁又完整的实测顺序:
# 第一步:先看系统负载和异常进程,判断是否被入侵或挖矿
uptime
top -b -n 1 | head -30
# 第二步:看最近50条系统日志
tail -n 50 /var/log/messages
# 第三步:查登录失败的IP,判断是否有人猜密码
grep "failure" /var/log/secure | awk '{print $NF}' | sort | uniq -c | sort -nr | head -20
# 第四步:查有没有异常用户加入root组
grep root /etc/passwd /etc/group
# 第五步:看到内存、硬盘报错,把dmesg输出保存下来发给硬件厂商
dmesg > /root/hw_check.log
业内专家指出,这套组合拳做完,绝大多数服务器问题的定位成功率在九成以上,剩下的那一点疑难杂症,才需要抓网络包或者做系统调用追踪。
日志文件被覆盖了怎么办:提前做好这三点
远程查日志最崩溃的情况不是查不到,而是人还没到,日志先没了,H3C服务器的Linux系统默认自带的logrotate每天轮转日志文件,历史日志保留周期通常是30天,超过期限就会被自动删除。
所以日志管理这件事,不该等到出故障才想起来,三个预防动作请提前做:
- 调整日志保留周期:修改
/etc/logrotate.conf里的rotate参数,把服务器从默认30天改成180天或更长,并设置compress选项启用压缩减少磁盘占用。 - 把/var目录单独分区:H3C服务器出厂默认分区方案里
/var通常和根目录共用磁盘空间,如果业务占用高,日志写满盘是早晚的事,建议装机时单独划分一个50GB以上的独立分区挂载到/var,加个逻辑卷方便后期扩容。 - 部署集中日志方案:这也是上面说的第三条路最根本的解决手段,日志实时转发到远程服务器,本地日志丢了远程还有备份。
为什么你的H3C服务器日志查不全?这五个原因最常被忽视
排查日志时经常发现信息比预期少很多,不是日志没生成,而是被系统限制了。
- rsyslog服务没起来或被禁用:执行
systemctl status rsyslog确认服务状态,没起来就执行systemctl enable --now rsyslog开机自启并立即生效。 - 内核日志级别限制:
cat /proc/sys/kernel/printk输出中,若第二项为1,则部分信息不会写入循环缓冲区,从而无法被dmesg读取。 - HDM日志缓存限制:HDM存储空间有限,当事件量大时老日志会被挤出,高频告警的服务器需要定期导出存档。
- 审计日志没开启:
/etc/audit/auditd.conf是审计守护进程的配置文件,如果配置文件错乱或服务没启动,文件被修改、用户执行了哪些命令这类审计记录就一片空白。 - 时区设置错乱:日志时间显示不对,排查时对不上号,在
/etc/sysconfig/clock中检查时区设置,确保和业务实际时区一致。
H3C服务器日志内容怎么看:先读懂这四种记录
日志不是密密麻麻写满字的看着头大,H3C服务器系统日志按照内容类型可以清晰划分,日常查看时先把记录类型分清,再决定重点关注哪些字段。
- 核心系统日志:存放在
/var/log/messages包括服务启停、网络状态变化、应用程序报错,排查服务类故障优先看这个文件。 - 内核消息缓冲:
dmesg命令获取的内容,专门记录硬件设备初始化信息和内核运行时错误,内存颗粒、CPU内核、PCIe设备在热插拔或故障时产生的错误反馈会写在这里。 - 登录安全日志:存放在
/var/log/secure,记录了服务器上每一次成功的、失败的登录尝试,包括Telnet、SSH等协议的登录来源IP,账号审计和暴力破解排查都靠这个文件。 - 任务计划日志:
/var/log/cron文件,记录crontab定时任务的执行情况,定时脚本执行了但没生效、执行了一半报错这类问题,查这一个文件最快。
另外一项容易被忽视的是H3C服务器上的Raid卡日志,用arcconf或者storcli工具(根据RAID卡型号选择)查看Raid控制器事件记录,存储在/var/log/下独立的阵列管理日志目录中,磁盘从阵列中被踢出掉线时,操作系统日志里不一定有明显提示,但Raid卡的日志会清清楚楚记录是哪块盘在哪个时间点掉线。
常见问题快速解答
问:h3c服务器远程查看日志时,SSH连不上怎么办?
先排查网络层面:ping服务器管理IP通不通,不通就检查网线和交换机端口,IP通但SSH端口不通,考虑防火墙拦截(用iptables -L -n查看),或SSH服务未启动(HDM挂载虚拟光驱后开机进单用户模式启动服务),另外HDM自带的远程控制台(KVM)功能可以完全绕开操作系统网络,借助虚拟KVM的系统界面修改SSH配置,再重新尝试登录,带外管理路径完成网络恢复后,才能回到SSH方式继续查看日志。
问:日志文件里的时间跟本地时间对不上,是H3C服务器时钟出问题了吗?
大概率不是硬件问题,而是操作系统时区或NTP同步配置没做好,需要先确认服务器选择的时区是否为Asia/Shanghai,然后检查网络时间同步服务是否启用,配置指向国内NTP服务器地址,比如ntp.aliyun.com,如果HDM和操作系统的时间都被设置成UTC,就会相差8小时,直接用date命令可以快速查看系统时间和时区,再用timedatectl set-timezone Asia/Shanghai修正并配置开机自启的NTP服务,H3C服务器如果同时开启HDM和操作系统两层NTP客户端,可能导致时间同步异常,建议只保留一层的自动同步设置。
问:日志显示磁盘I/O错误,但服务还能用,可以暂时不管吗?
不建议拖延,I/O错误往往是设备完全失效前的前兆,H3C服务器配套的企业级SATA和SAS硬盘年化故障率有标称值,但具体到单块盘,连续出现I/O错误后剩余可用时间无法预估,短则几小时长则几周,立即查看Raid阵列状态确认对应物理磁盘位置,做好业务备份,联系硬盘保修的售后渠道准备替换盘,同时检查/var/log/messages里错误是否持续增长,若I/O报错伴随大量系统调用中断,尽早安排停机维护窗口替换硬件更稳妥,服务器的价值在于持续提供可靠计算能力,数据无价。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/787140.html