服务器维护标准并没有一张统一的官方清单,行业共识认为它是一套围绕可用性、安全性和性能的闭环管理体系,核心标准可以用一句话概括:保障服务器在既定生命周期内持续、稳定、安全地提供业务服务,并将故障影响控制在可接受范围内。
这句话听起来有点宏大,落到实际运维工作中,它其实可以拆解成几个可以量化、可以执行、可以检查的具体模块,这篇内容主要用来回应那些在百度上搜“服务器维护标准有哪些”的同行,以及那些正在为“服务器日常维护内容清单”发愁的运维新人。
服务器硬件维护标准与检查周期
硬件是服务器运行的地基,硬件维护标准的核心是预防性维护,而不是等坏了再修,业内专家指出,硬件故障约70%是有先兆的,比如温度异常、磁盘坏道、电容鼓包,关键在于是否建立了标准化的巡检制度。
服务器硬件维护周期怎么定
硬件巡检频率取决于业务的重要性和环境的恶劣程度,没有一个绝对的数字,但可以参考以下层级来构建自己的标准:
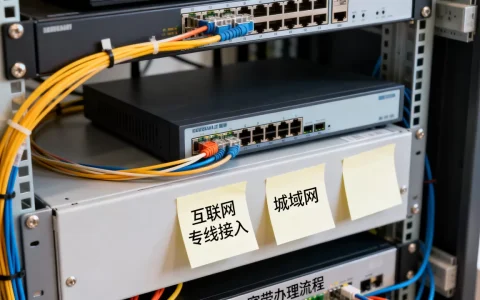
- 日常巡检(每日或每周):重点观察机房温湿度、服务器面板告警灯、硬盘灯状态,这项工作通常由值班人员通过带外管理系统(如Dell iDRAC、HP iLO)就能完成,不需要物理接触服务器。
- 月度维护:检查系统日志中是否有硬件报错(比如ECC内存纠错记录暴增)、磁盘S.M.A.R.T.健康值、电源模块运行状态,需要登录到服务器操作系统或存储管理界面去查看。
- 季度/年度维护:这是重头戏,需要申请维护窗口,内容包含清理机柜防尘网、检查风扇转速是否衰减、更换即将到达寿命的电池(如RAID卡电池、服务器主板电池),以及验证备份数据的可恢复性。
关于硬件的更换标准,行业共识是遵循生命周期管理,比如硬盘,在质保期的最后一年,哪怕没有故障,也应该列入更换计划,内存和CPU虽然不是易耗品,但一旦出现单条内存触发多次纠错,就要直接更换,不能拖到宕机。
硬件维护结果怎么衡量
硬件维护做得好不好,不能只看“没坏”,把标准罗列成以下清单,会更容易执行:
- 机房环境温度控制在18-27℃的合理范围,湿度在40%-60%之间。
- 所有关键硬件(电源、风扇、硬盘、网卡)均处于冗余状态,单点硬件故障不影响业务。
- 固件版本(BIOS、BMC、阵列卡固件)保持统一基线,且为官方稳定版,不追新。
- 备件库中至少有一块同型号硬盘、一个电源模块、一条内存的现货储备。
服务器系统与软件维护标准
系统层面的维护,比硬件更容易出现“人的问题”,很多故障不是系统不行,而是配置改乱了或者补丁没打全,这块的核心标准是标准化变更和版本管理。
系统补丁与漏洞修复基线
系统维护标准里最容易被忽略的是补丁管理,但这也是安全扫描中整改最多的项。
- 高危漏洞:比如远程代码执行类,要求在72小时内完成补丁测试并部署到生产环境。
- 中危漏洞:可以跟随月度维护窗口进行修复。
- 低危漏洞:在季度维护窗口统一处理,但需要登记备案。
需要说明的是,补丁测试必须先在预发布环境跑一遍业务回归,这一条对于数据库服务器尤其重要,不能因为急着堵漏洞,把业务搞挂了。
日志与时钟同步标准
系统日志是排障的第一手资料,它的标准不是“有日志”,而是“日志有用”:
- 开启操作审计日志和安全日志,记录所有登录、提权、配置变更行为。
- 日志保存期限不低于6个月(等保二级要求),核心业务系统建议保存1年以上。
- 所有服务器必须配置统一的NTP时间同步源,避免因时间偏差导致日志无法关联分析,甚至引发证书校验失败。
系统层面日常维护操作路径
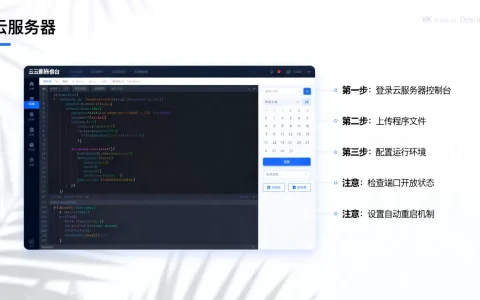
这里整理一份“服务器日常维护内容清单”中系统层面的标准操作流程,每一步都是可执行的:
- 每月第一周,检查磁盘空间使用率,清理/var/log下的历史日志归档文件。
- 每月检查文件系统inode使用率,防止小文件塞满分区。
- 修改默认的SSH端口并限制root远程登录,这是系统维护的底线要求。
- 检查系统关键进程是否存在异常重启记录,比如通过
last和journalctl命令排查。
服务器安全维护标准基线
安全维护标准在2026年已经不是一个可选项,而是服务器的生存底线,安全维护标准的衡量维度,不是“有没有装杀毒软件”,而是“攻击者进来之后,你能多久发现并阻断”。
服务器安全基线配置标准
搭建安全基线,可以参考等保三级的基本要求,但更贴近日常维护的配置有以下几点:
- 账户与口令:清理所有不用的僵尸账户,禁用guest账户,口令复杂度策略要求长度至少12位,包含大小写字母、数字、特殊字符,并且每90天强制更新一次。
- 访问控制:遵循最小权限原则,应用账户只拥有其所在目录的写权限,不给不必要的sudo权限。
- 端口管理:关闭所有非业务必须的端口,平时可以用
ss -lntp命令检查正在监听的端口,凡是看不懂的监听,一律查清来历并关闭。 - 入侵检测:在主机上部署开源HIDS(如Osquery、Wazuh),重点监控关键文件的哈希值是否变更,以及异常的外联IP行为。
安全应急响应的时效标准
安全维护最忌讳“发现了但没有人跟进”,标准化的响应时效通常是这样的:
- 紧急事件(如确认勒索病毒加密、root权限被窃),要求5分钟内断网隔离,15分钟内上报安全负责人。
- 高危事件(如暴力破解、webshell上传),要求30分钟内完成初步抑制和证据留存。
- 中低危事件(如弱口令扫描、异常登录失败),要求24小时内完成核查并闭环。
在百度上搜索“服务器安全维护标准有哪些”的运维朋友,大概率正在应对安全扫描报告,这些时效指标其实比具体的技术细节更重要,因为安全扫描看重的是响应流程。
服务器巡检记录怎么写以及维护窗口规划
巡检记录不是给领导看的流水账,而是为了呈现故障规律,方便做趋势分析,很多人问“服务器巡检记录怎么写”,核心逻辑是记录变化,而非记录状态。
巡检记录表标准要素
一张合格的巡检记录表,至少要有这四类信息:
- 环境信息:机房温度、湿度、设备位置标签。
- 硬件健康:CPU温度、硬盘健康状态(是否报警)、RAID阵列状态、电源模块状态。
- 系统资源:CPU负载峰值、内存利用率、磁盘I/O等待时间。
- 异常事件描述:记录告警时间、处理过程、处理结果、遗留问题。
一个实操技巧是:巡检记录中必须包含“上次巡检遗留问题”的复查结果,如果没有闭环这一项,周报写得再漂亮,故障风险依然存在。
维护窗口期的执行标准
无论是打补丁还是换硬件,都需要维护窗口。
- 常规维护窗口建议设置在业务低峰期,比如凌晨02:00至05:00。
- 执行变更前,必须提交变更申请单,包含影响范围、回退方案、操作步骤。
- 变更完成后,建议观察30分钟再宣布结束,重点检查业务日志中是否有报错堆积。
服务器维护标准相关的常见问题
服务器日常维护内容清单里,最容易被忽视的是哪一项?
最容易被忽视的是备份数据的恢复演练,大多数运维人员会做备份,但很少会真的在测试机上把备份的数据恢复一遍,等到数据真的丢失时,才发现备份文件是坏的,这种情况在企业内部很常见,标准是每季度至少做一次完整的恢复演练,并记录恢复用时和成功率。
小型企业没有专职运维,如何执行服务器维护标准?
小企业可以先做减法,优先保住三个底线:第一,开启系统自动安全更新(不自动重启的情况下);第二,配置好日志服务器,哪怕是简单的Linux远程日志;第三,保持一台离线备份机器,对于硬件巡检,可以使用带外管理工具设置邮件告警,减少人工盯守的负担。
服务器安全基线配置标准是否会与业务性能冲突?
一定程度上会,比如开启强制访问控制(SELinux)或应用白名单,可能会影响原有程序的正常运行,解决思路不是关闭安全功能,而是先启用告警模式,观察一周业务日志,收集误报信息,再逐步切换到强制模式,安全基线的最终目标是让业务在受控环境中运行,而不是让业务跑在裸奔的边缘。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/787544.html