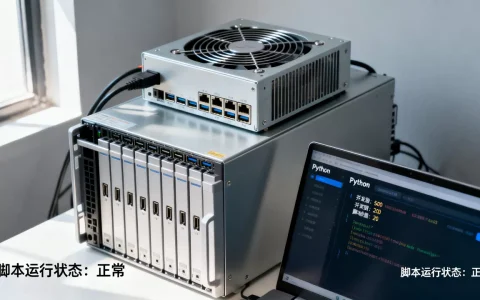
高性能计算之所以更依赖物理服务器,核心在于其工作负载对极致算力、低延迟和零虚拟化干扰的刚性需求,而物理服务器独占硬件、直通底层资源的特性,恰好是满足这些苛刻条件的唯一答案。
高性能计算为什么不用云服务器?虚拟化损耗这道坎迈不过去
大多数企业上云图的是弹性伸缩和按需付费,但对高性能计算而言,云服务器的“共享”基因从底层就埋下了性能损耗的隐患,业内专家指出,虚拟化层就像一层无形的膜,它让多租户共享物理资源成为可能,却也额外增加了指令转换的中间环节。

虚拟化层吃掉的不只是几个百分点的性能
在高性能计算场景里,CPU的每条指令都在为浮点运算服务,云服务器的超线程、CPU份额限制、内存页面映射,都会让计算任务在“真实硬件”和“虚拟硬件”之间频繁跳转,举个例子,跑分子动力学模拟时,一次内存访问在物理机上可能需要100纳秒,在虚拟化环境中这个数字可能膨胀到300纳秒以上,这种差距在单次操作中微乎其微,但在动辄百万亿次的计算规模下,累积的时延会让整体进度慢上30%到50%,这几乎是行业共识。
“吵闹的邻居”是高性能计算的致命伤
云服务器上你永远不知道隔壁租户在跑什么任务,他可能在进行一次大规模的数据压缩,也可能在持续打满磁盘IO,这意味着你的计算节点性能会出现断崖式波动,高性能计算追求的是可预测的确定性,每一次MPI通信的延迟抖动,都可能导致整个集群的同步等待,物理服务器完全独占一套硬件,CPU缓存、内存带宽、PCIe通道都专属于一个任务,性能曲线稳定得能画成一条直线。
高性能计算为什么需要物理服务器独占GPU与InfiniBand
AI训练和天气预报这类极端计算场景,依赖GPU直通和RDMA网络,云服务器想用GPU,要么走虚拟化透传,要么用vGPU切分,透传虽然接近物理性能,但管理复杂;vGPU切分出来的算力根本喂不饱大规模并行框架,物理服务器可以轻松插上8块A100/H100,通过InfiniBand网卡直接互联,每节点吞吐量达到400Gbps,延迟低至1微秒,这种硬件级的深度融合,云厂商即便推出了裸金属服务器变体,本质上也是物理服务器这类方案在云平台上的租用服务。
物理服务器和云服务器区别:从资源掌控权到故障域的天然边界
选物理机还是云主机,表面看是预算问题,深层次其实是控制权的取舍,高性能计算任务往往需要调整CPU频率、关闭系统安全模块、加载特定的内核驱动,云环境下这类操作几乎不可能完成,而物理服务器从操作系统到固件层面都向你完全开放。
底层指令集与内核定制:物理机的专属特权
- 高性能计算普遍依赖MPI(消息传递接口)库,对网络协议栈和CPU指令集有严苛要求,物理服务器允许直接修改BIOS参数,开启NUMA平衡、调整内存分页策略,甚至刷入定制化内核。
- 使用高性能计算服务器跑气象模型时,操作员通常需要关闭CPU的Turbo Boost以换取更稳定的频率输出,云服务器默认开启动态调频,用户根本无法干涉。
- 处理基因测序拼接任务时,需要大量使用AVX-512指令集,物理机充足的散热设计和电源冗余能保证指令集持续满载输出,而云主机受限于机架密度,往往触发降频保护。
从故障隔离来看,物理服务器的故障边界特别清晰,一台物理机宕机,影响范围就是这台机器,云服务器虽然也有故障迁移,但迁移本身需要时间,对于长时间运行的并行任务,一次迁移的成本等同于任务重启,很多超算中心宁可牺牲所谓的“高可用”,也要坚持使用物理服务器来保证任务完整性。
高性能计算服务器租用价格:算一笔更细的账
涉足高性能计算领域,成本是避不开的话题。高性能计算服务器租用价格在2026年已经出现明显分化,云主机小时单价看起来便宜,但总持有成本未必有优势。
长期稳定负载与抢占式实例的性价比博弈
- 云服务器适合短周期、突发型的高性能计算任务,比如渲染农场处理一部电影的特效镜头,跑完即释放,这时云服务器价格优势明显。
- 物理服务器租用适合7×24小时持续计算的场景,例如新材料模拟、金融风险模型回测,按月租用物理服务器的成本,叠加带宽和IP费用,通常只有同等算力云主机包月费用的60%到70%。
- 国内一线城市数据中心租用搭载双路志强/EPYC处理器、512GB内存的GPU算力服务器,月租金范围在数千元至两万元之间,具体价格看GPU型号和带宽配置,对比云厂商同规格包年实例,省下的钱足够再添两套高性能存储集群。
容错成本与数据迁移成本为何常被忽略
大量实践案例表明,使用云服务器进行大规模并行计算时,一次节点故障导致的推理中断、数据回滚需要大量额外开销,物理服务器租用提供商通常会提供免费的硬件维保和硬盘阵列重建服务,这些隐性成本在云环境中往往没有清晰报价,行业里流传着一种说法:“计算任务跑一周,物理机比云主机多跑一天的结果,这多出来的一天就是纯利润。”
北京、上海、广州等一线城市的物理机柜托管费用相对透明,对于预算有限但有稳定算力需求的机构,直接采购二手物理服务器到IDC机房托管,是比租用云主机更划算的长期策略。
从裸金属到高密度集群:物理服务器的新形态演进
人们对物理服务器的刻板印象还停留在“一台机器一个机箱”,实际上2026年的物理服务器形态已经高度分化,GPU服务器普遍采用8U甚至12U的高密度机箱设计,内置8到16张加速卡,存储服务器则配置了24块NVMe SSD整数阵列。
算力网格的底层依赖物理直连
百亿亿次级超算系统的构建基础是数万个物理节点通过高速互联网络连接,无论软件定义网络多发达,数据最终还是要流经物理网卡、物理线缆、物理交换机,完全没有虚拟化层的物理服务器,可以让深度学习框架的通信库直接绑定到网卡队列上,实现零拷贝传输,这种精细的调优空间,在云主机上完全无法实现。
混合部署:物理服务器与云服务器的合理分工
这并非是说物理服务器要完全取代云服务器,而是在特定场景下各自发挥优势,前端Web服务、大数据预处理、容灾备份可以放在云端,享受弹性扩缩容的便利,核心计算引擎、参数服务器、高并发推理节点应当部署在物理服务器上,一套成熟的架构一定是混合的:云负责应对流量高峰,物理服务器负责稳定产出计算结果。
高性能计算为何绕不开物理服务器:三个关键问题的深度解答
高性能计算集群可以完全构建在云上吗?
可以,但仅限于中小规模且对延迟不敏感的任务,一旦跨入数百节点规模,云网络的多层 Overlay 隧道会显著放大通信延迟,导致集群线性扩展比急剧下降,靠谱的方案是选择云厂商提供的裸金属产品,本质上依然是物理服务器,只是由云平台代管。
如何选择合适的物理服务器配置?
以单精度浮点运算为主要负载的场景,优先考虑GPU数量和显存带宽;以整数运算和内存吞吐为主的应用,重点优化CPU核心数和内存通道数,对于高性能计算,磁盘IO同样是瓶颈,建议选择配备高频率固态盘并支持RAID卡直通模式的机型。
物理服务器是否意味着更复杂的运维负担?
确实如此,这是物理服务器的天然短板,硬件故障需要自行响应,故障硬件更换可能需要数小时甚至跨城市物流,大量用户转而选择包含硬件维保服务的物理服务器租用方案,让专业IDC团队负责硬件巡检与更换,自己专注应用层优化,这本质上是用服务成本换取运维时间的二次分配。
高性能计算本质上是在与物理世界的极限博弈,算力、功耗、冷却、网络每一环都在挑战工程上限,物理服务器作为这一切的物理载体,提供了最直接的硬件控制权和最可观的性能表现,在可预见的未来几年,即便容器化和边缘计算继续发展,物理服务器依然是高性能计算领域不可替代的底座,其价值不在于技术是否先进,而在于能否交付确定性成果。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/787857.html