高峰期显卡不够用的本质是“算力峰值”和“固定硬件”之间的矛盾,解决思路就一句话:把任务分优先级,本地显卡只能排队干重要的事,临时溢出的大批量任务直接甩给云渲染,不要再纠结买卡。
这句话听起来像废话,但真到接单高峰期,大部分小工作室的做法恰恰相反:一边死磕本地渲染,一边懊恼当初没多买两张卡,然后硬扛通宵,今天这篇内容,就从实操层面把“怎么调度”这件事拆开讲透,涵盖任务排级、软件队列设置、云渲染的切入时机和成本对比,以及怎么用排单策略把“显卡不够”这个雷提前拆掉。
第一步先分清:哪些活必须占本地卡,哪些活可以等
很多工作室显卡不够用,不是卡真的少,而是什么活都往GPU上扔,一张4060和一张4090干同样的活,效率差好几倍,但如果你把不同精度的任务混在一起排队,高端卡会被低端任务拖死,低端卡又被高端任务卡到爆显存,行业共识是:先给任务分级,再决定资源去向。
按交付紧急度划分三个等级
- A级任务:今晚必须交付、甲方明早开庭要用、模型已经锁定不能再改,这类任务锁定最高优先级,独占主力卡。
- B级任务:明天下午交付、还在反复修改阶段、分辨率要求不高,这类任务可以进队列排队,但允许被A级任务抢占,或者错峰到深夜渲染。
- C级任务:后天以后交付、测试图、小样、16:9预览图,这类任务根本不值得占本地卡,直接丢给云渲染或者用CPU兜底。
实际执行时,先在项目文件夹里建立“交付时间轴”表格,把每个任务按“死线-修改次数-单张预计耗时”三列排出来,单张耗时少于10分钟的任务,根本不需要调度,让它排队就好;单张耗时超过30分钟的长任务,才值得考虑要不要切到云渲染。
软件层面先自救:多卡调度和任务队列的底层设置逻辑
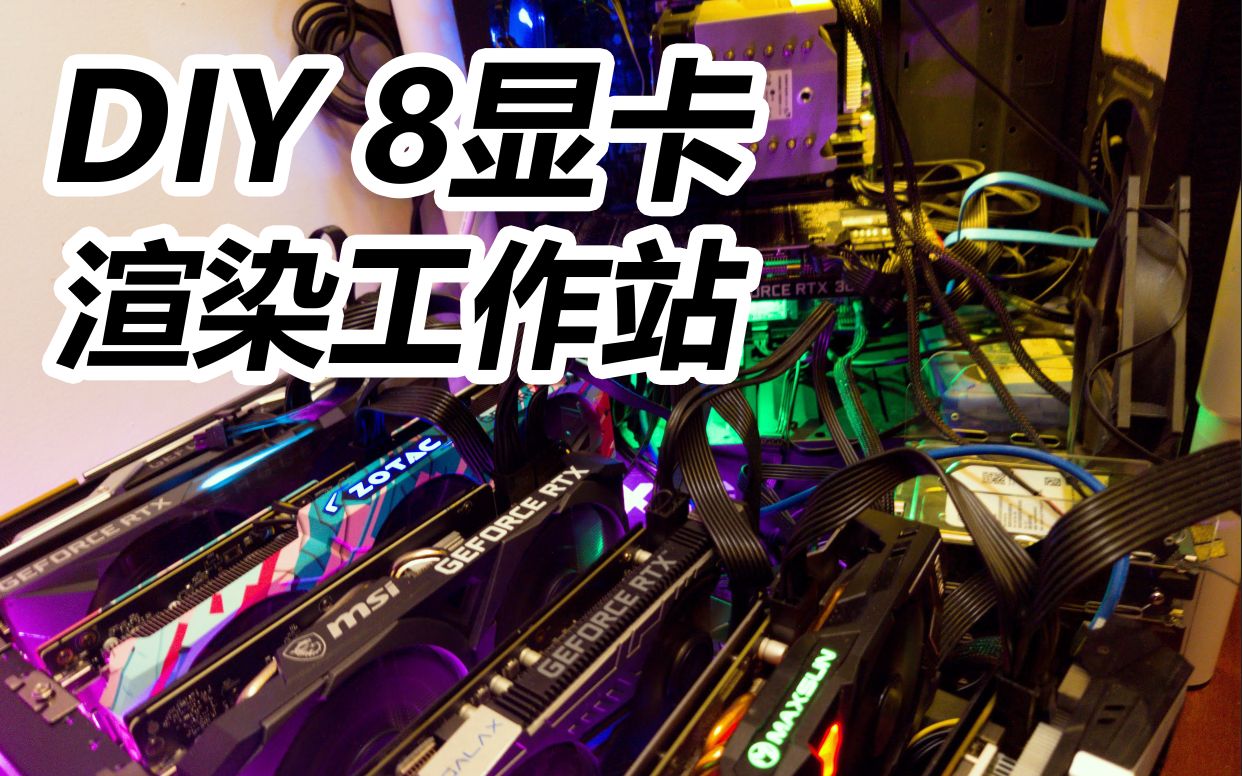
经常遇到的情况是:工作室有两张显卡,一张4060一张4090,活一多就乱套,很多人以为只要渲染器支持多GPU就能自动分配,其实不然,大部分渲染软件默认是“把所有任务平均切给所有GPU”,不会根据显存大小和渲染强度动态分配,你必须在软件层面手工指定。
多卡渲染任务队列怎么设置
以主流的三维软件和渲染器为例,实操路径是这样的:
- Blender Cycles:在“渲染属性”里关闭“自动检测GPU”,手动勾选需要参与计算的显卡,如果你的场景显存占用超过8GB,只勾选大显存卡,避免小显存卡爆掉导致整个任务中断。
- C4D + Octane:Octane的设备管理里可以逐卡设置“渲染优先级”,主力卡设为主要设备,副卡设为“GPU降级模式”或直接禁用,让副卡只处理简单场景。
- 3ds Max + V-Ray:V-Ray的GPU渲染设置里,有一个“任务分割”选项,按帧分割而不是按图像块分割更适合多卡,如果一台机器上两张卡规格不同,按帧分割能规避“木桶效应”。
软件级限流:卡住“占着茅坑不拉屎”的任务
渲染器跑大图时,显卡占用率往往跑不满,但任务一直挂着,这时候需要给显卡加“闸门”。
- Windows系统下,用进程管理器把后台频繁索引、杀毒扫描的进程临时关闭,释放显存带宽。
- 使用GPU-Z实时监控每一张卡的显存占用率、温度、功耗,如果发现某张卡显存占用超过90%但核心利用率只有40%,说明场景里有大量重复几何体,要回去优化场景,而不是继续堆显卡。
- 队列渲染软件(如Deadline、Thinkbox Deadline或简单的Batch Render插件)可以设置“任务插队”规则:当A级任务提交时,自动暂停B级队列里的当前帧,渲染完A级帧后再恢复,这个功能平时没用,但高峰期非常救命。
小工作室不一定需要花大钱买队列管理软件,用Premiere Pro的Media Encoder或DaVinci Resolve的渲染队列也能实现基本的按序输出,关键是立下规矩:每个任务提交前,必须标明优先级和预计渲染时长,否则调度员有权拒收。
算力兜底方案:云渲染是“临时工”不是“长期饭票”
本地卡不够的时候,最直接的临时扩容手段就是云渲染,但这里必须说清楚一个坑:云渲染不是为省钱设计的,它是为“在截止日期前交活”设计的,适合高峰期溢出任务、单机跑不动的超大场景、以及需要多机并行输出的批量渲染。
云渲染和新显卡哪个划算,算一笔总账
很多人在高峰期纠结“要不要咬咬牙买一张新卡”,业内专家指出,这个问题的答案取决于你未来半年每个月的峰值任务频率。
- 如果峰值一年就出现两三次,买卡纯属浪费,一张中高端显卡的售价,足够你在这两三次高峰期里包掉几乎全部云渲染费用。
- 如果每月都有一周以上处于排队爆满状态,买卡是更优解,因为云渲染的单价累加起来会超过硬件折旧成本。
- 云渲染的隐藏成本不只是单价:上传场景文件的时间、平台插件版本不兼容导致的重试、高峰期平台本身排队也要等,这些“隐性等待”往往比渲染费用更伤人。
实操建议:在云渲染平台注册后,先用你手上最复杂的那个场景跑一次测试帧,记录“上传耗时+排队耗时+单帧渲染耗时+下载耗时”,再对比本地单机渲染速度,如果云渲染测试帧的端到端速度达不到本地速度的至少一半,这个平台在高峰期帮不了你,趁早换一家,相似场景下,平台间价格差距较大,优先选按时长计费、不用预充值太多余额的。
哪些任务适合上云,哪些必须留在本地
- 适合上云:大批量8K静帧输出、地形/植被类高面数场景、需要输出20张以上同一场景不同角度的图,这类任务高度并行,且单帧之间无依赖关系,云渲染的并行优势能完全发挥。
- 绝对别上云:还在频繁改材质、调灯光的半成品、涉密项目、需要在本地有特定插件(如特定版本的Corona材质库)才能渲染的工程,传出传回加上来回沟通的沟通成本,比本地排队更慢。
排单本身就是调度:把“显卡不够”的雷提前拆掉
高峰期最怕的不是卡不够,而是所有任务同时催稿,很多工作室习惯性“先到先做”,结果所有人的任务都卡在“渲染中”状态,谁的都出不来,真正的调度高手,功夫花在排单上。
用“时间差”把高峰期削峰填谷
- 夜间错峰:客户第二天早上看的图,通常前一天晚上才最终确认,这类任务永远排晚上渲染,正好把白天的高峰时段让给其他需要反复交互操作的任务。
- 分辨率错峰:需要交付4K的镜头和1080p的镜头,如果分辨率差距大,不要同时抢卡,先让4K任务单独占卡跑,1080p任务排队等,因为低分辨率任务在等待期间的损失远小于4K任务卡顿或中断的损失。
- 用内部报价引导优先级:对内部项目或预付费项目,可以设定“高峰期加急费”逻辑紧急项目走紧急通道,但要使排队系统里的优先级排序不仅看时间,也看项目类型。
高峰期显卡调度的两条铁律
- 任何高优先级任务都必须有明确的“中断重启”预案,比如渲染到第7帧时客户突然要改材质,你要能3分钟内停掉当前帧、改参数、从第6帧断点续渲染,而不是从头再来,这需要渲染软件里开启“保存交互式渲染缓存”或“检查点输出”。
- 别再手动盯着渲染进度,利用渲染队列的邮件或微信通知功能,每帧渲染完成自动通知,这样可以把人从“等待渲染”中解放出来,去处理建模和动画这些不需要GPU的工作。
处理高峰期压力,真正要管的是信息流和决策流:谁的任务优先、谁在等、谁可以提前预渲染,这些理顺了,一半的“显卡不够”问题其实根本不会发生。
常见问题
问:高峰期临时租用云渲染和买一张二手显卡应急,哪个更靠谱?
二手显卡的问题在于显存不透明,很多所谓“个人自用”的显卡在实际重型渲染时会出现显存报错或驱动崩溃,云渲染平台的优势是算力规格明确,出了问题有技术支持介入;缺点是上传和等待耗时,如果你手里有超过24小时的缓冲时间,且任务场景文件小于几个GB,云渲染更稳;如果只剩一个通宵,本地二手卡反而是唯一能救急的选项,前提是你接受渲染中途可能翻车的风险。
问:双显卡配置下,渲染任务应该手动拆分还是让软件自动分配?
多数渲染软件在“显存和核心算力平衡”这块的自动分配策略仍然不够好,具体而言,当两张卡规格差距小于20%时,自动分配问题不大;但当新旧混插(例如4060+3080),手动指定主力卡和辅助卡更可靠,操作路径:在渲染设备的GPU列表中,只勾选主力卡的“渲染”选项,辅助卡勾选“桌面显示+交互预览”,避免交互操作占用渲染卡资源。
问:高峰期所有显卡满载时,再打开一个软件就卡死,怎么避免?
这是显存管理问题,渲染场景如果吃掉了显卡的大部分显存,再开软件会触发显存溢出,办法是:将渲染器的缓存限制设置在总显存扣除1.5GB-2GB的数值上,预留一部分给系统桌面渲染,具体设置在Blender里是“内存限制”选项,在Octane里是“GPU显存上限”,这个数值要设为具体数字(例如显存24GB的卡,设置为22000MB),而不是默认无限制。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/788195.html