视频渲染农场的GPU资源规划,核心一句话:先算并发峰值,再定单卡型号,最后谈总量规模,算错并发,后面所有配置都是浪费。
GPU资源规划的起点:算清你的“并发峰值”
规划GPU资源之前,我们得先搞明白一个最扎心的问题你到底在给谁做渲染?是给广告公司做10秒的C4D产品动画,还是给影视团队做两小时的UE5虚拟制片?这两者的GPU消耗量差着好几个数量级。
按业务场景估算并发需求
视频渲染农场的核心指标不是“我用了几张卡”,而是“同一时间能跑多少帧”,业内专家指出,规划GPU资源必须从“帧”的角度倒推。
- 单帧渲染耗时:一个1080P的Octane渲染场景,单帧耗时通常在1-5分钟;4K的Redshift场景,单帧可能拉到10-20分钟;带大量体积光、粒子特效的UE5场景,单帧半小时以上也不稀奇。
- 每日交付量:假设你的客户要求一天交付30秒成品视频,按25fps算,30秒就是750帧,如果单帧渲染要3分钟,总耗时就是2250分钟,要让这活在一个工作日内干完,满打满算需要5张GPU同时跑,至于“1.5张”怎么落地要么买两张卡留冗余,要么一张高配卡加班跑。
- 峰值缓冲系数:很多团队会忽略一个事实客户改片比渲染更频繁,项目交付前三天,往往才是渲染压力最大的时候,行业共识认为,规划GPU数量时要在日均需求基础上乘以5到2倍的峰值缓冲系数。
按渲染器类型决定卡型
不同渲染器对GPU的“胃口”完全不同,跟人吃饭一个道理有人吃米,有人吃面,你不可能让所有人吃一样的。
- Octane / Redshift:这两款是“显存饥渴型”,它们需要把场景几何体、贴图、灯光缓存全部塞进显存,显存不够,直接爆显存弹出错误,这类渲染器,NVIDIA RTX 4090(24GB)或RTX 6000 Ada(48GB)是主力。
- UE5 / 虚幻引擎:Lumen全局光照和Nanite虚拟几何体对显存占用极高,同时对CUDA核心数量也非常敏感,这里更看重整卡吞吐量,建议上RTX 6000 Ada或者A6000。
- Arnold / V-Ray混合渲染:这类渲染器用得比较杂,既有CPU渲染,也有GPU加速,如果你的团队还在用老旧的V-Ray 3.x版本,那它对GPU的利用效率其实很低,这时候盲目堆GPU反而浪费钱。
视频渲染农场GPU服务器配置怎么搭才不浪费
很多初次搭建渲染农场的团队,容易犯一个毛病单机配置拉满,结果节点之间互相拖后腿,GPU资源规划不只是“买几张卡”的问题,而是“整台机器怎么配”的系统工程。
单节点配置的黄金比例
GPU是渲染农场的心脏,但CPU、内存、存储就是输送血液的血管,血管太细,心脏再强也白搭。
- CPU与GPU的比例:对于主流GPU渲染器来说,CPU主要负责场景解算、数据上传和调度,一个经验值:每张RTX 4090搭配一颗16核以上的CPU,如果CPU核心太少,GPU会经常处于“等数据”的空闲状态,利用率直线下降。
- 内存容量:内存要给显存的2倍以上,一张24GB显存的4090,节点内存建议不少于64GB,最好上128GB,原因很简单场景文件从硬盘加载到内存,再从内存上传到显存,内存太小会导致频繁的硬盘交换,拖慢整个流程。
- 系统盘与素材盘分离:系统盘用NVMe SSD装系统和软件,素材盘用大容量SATA SSD做项目缓存,不要把所有东西塞在一个盘里,因为渲染农场7×24小时跑,磁盘I/O压力极大。
节点规模与机房基础设施
这里回答一个高频搜索词:“渲染农场GPU服务器配置”,这不仅仅是硬件清单,还包括物理层面的规划。
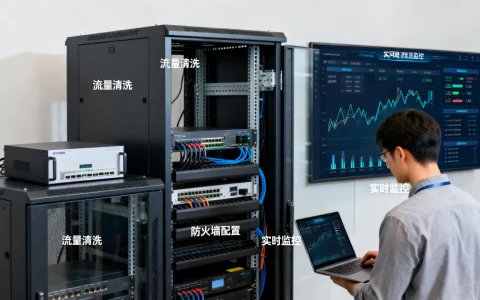
- 机柜功率:一台8卡GPU服务器满载功耗轻松超过4000W,普通机房单个机柜的供电通常只有8-12KW,意味着一个机柜最多放两台8卡机器,再多就会跳闸,规划前先算好机柜总功率,这个坑踩的人特别多。
- 散热方式:RTX 4090这种消费级显卡的涡轮版虽然价格高,但它是1U/2U服务器安装的唯一选择,公版三风扇散热在服务器机箱里根本排不出热风,要么买涡轮版,要么改水冷,没有第三条路。
- 网络瓶颈:如果你的农场要跑分布式渲染(多台机器协作渲染同一帧),万兆内网是标配,千兆网传输大场景缓存文件,会让GPU像饿汉等外卖一样干瞪眼。
视频渲染农场多少钱:算清固定成本与变动成本
“视频渲染农场多少钱”是搜索量最高的长尾词,我们可以把这个问题拆成两笔账来算。
自建农场的固定成本
自建农场是典型的“一次性大出血,后续细水长流”。
- 硬件成本:以10台双卡RTX 4090配置为例,单台主机约6-8万元,10台就是60-80万,加上交换机、布线、机柜,首期投入在70-90万区间。
- 电费成本:10台双卡机器满载功耗约25KW,按商业电价1元/度算,24小时跑满一天就是600元电费,一个月接近8万,这还不算机房空调制冷的额外电费。
- 折旧成本:GPU的寿命通常在3-5年,如果按3年折旧,一年折旧费就是20多万,平摊到每个月约2万。
租用云渲染的变动成本
云渲染按量付费,一帧一价。
- 按帧计费:主流云渲染平台的RTX 4090实例价格约为3-6元/卡/小时,一帧4K Redshift场景如果渲染耗时5分钟,光GPU费用就是25-0.5元/帧。
- 存储费用:云渲染的上传下载流量和中间文件存储是额外收费的,项目文件动辄几十GB,这部分隐性成本常常被低估。
- 对比结论:如果年度渲染总量超过2000卡·天,自建农场的成本就低于纯云渲染,如果你一年只跑两三个项目,云渲染显然更划算。
渲染农场自建与云租用之间如何权衡
这是另一个典型搜索需求:“渲染农场哪家好”,其实没有绝对的好坏,只有合不合适的阶段。
适合自建的场景
- 长期有稳定的渲染任务,每月GPU利用率能保持在60%以上。
- 项目文件涉及商业机密或未上映影片,数据不能出内网。
- 团队有专门的IT运维人员,能折腾驱动和调度系统。
适合云租用的场景
- 业务量起伏大,淡季GPU闲置率高,旺季供不应求。
- 项目周期短,交付急,临时扩容比采购审批来得快。
- 团队规模小,不想养运维,只想专注在创作端。
混合架构是多数团队的选择
近一两年的趋势是“自建核心池+云上弹性池”,日常小项目用本地几台机器扛住,接到大项目或者高峰期,直接通过渲云、Renderbus这类平台的API接口批量提交任务,这种方式的优势是兼顾成本与灵活性,暴风雪场景能扛住,平时不用养闲人。
GPU集群的调度:规划之后的日常运营
买好GPU只是第一步,真正的“运营”在于调度,如果调度不行,再好的GPU也会被白白浪费。
让每张卡都不闲着的策略
- 任务队列优先级:按项目交付时间排序,急的单子插队跑,不急的单子抽空跑,别让所有任务一起抢资源,结果谁都跑不完。
- 自动回收空闲节点:设置好闲置判断逻辑,比如GPU利用率低于10%超过15分钟,就把该节点从渲染池中摘出来,让新的任务不会分给它,这样可以避免资源碎片化。
- 故障自动重试:不要因为一张卡报错就让整个任务堵死,调度系统检测到任务失败后,自动换一台机器重新渲染,保证农场不掉链子。
监控指标盯紧这几个
- 单卡占用率:长期低于60%说明资源有浪费,要么接更多活,要么卖掉部分卡。
- 显存占用峰值:如果某个场景经常让显存爆掉,这个项目的资产确实需要减面或者优化贴图了,不完全是GPU的问题。
- 渲染队列堆积时间:如果提交任务后等待超过半小时才开始渲染,说明并发峰值规划没做好,需要扩容。
Q&A:视频渲染农场GPU规划的常见疑问
Q1:GPU显存选24GB还是48GB?
取决于你的场景规模,如果主力项目是电商产品图和30秒以内的广告片,贴图分辨率不高,24GB完全够用,但如果你要做建筑可视化漫游动画或者影视级特效镜头,场景动辄几十GB,48GB显存能让你少处理很多次“显存不足”的报错。买大不买小,预算允许直接上48GB版本。
Q2:渲染农场用游戏卡还是专业卡?
RTX 4090性价比远高于专业卡,这是行业共识,专业卡的优势在于更大的显存(48GB)、更稳定的驱动和更低的故障率,机房7×24小时满载运营,专业卡的稳定性能减少很多隐性维护成本,个人工作室可以全用游戏卡,商业农场建议混搭核心节点用专业卡,扩展节点用游戏卡,游戏卡故障就停机换卡,成本可控,如果你想避免来回折腾,且预算充足,专业卡省心得多,据行业公开信息,部分渲染平台故障维修时间有一半以上间接来自散热设计偏弱的游戏消费卡长期满载运行。
Q3:渲染任务总是跑不满GPU利用率,卡在什么环节了?
大多数情况下,卡在存储的读写速度上,场景缓存文件太大,硬盘读取速度跟不上GPU的消费速度;或者是Wi-Fi网络连接,文件传输本身就成了瓶颈,特别是素材分散在多个机器上时尤为明显,把项目文件放在本地NVMe SSD上,并确认调度机与渲染节点之间通过万兆内网互联,这两个动作做完,GPU利用率往往能提升20%-30%。
核心结论再强调一遍:先摸清业务峰值,找到自己大多数项目的共性配置,再谈买多少卡、买什么卡,硬件的钱要花在刀刃上,调度和监控的配置同样重要,不要只盯着GPU数量这一个指标,渲染农场是一台精密的机器,每一个环节都要顺滑衔接,这份资源的规划才算真正落地。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/788788.html