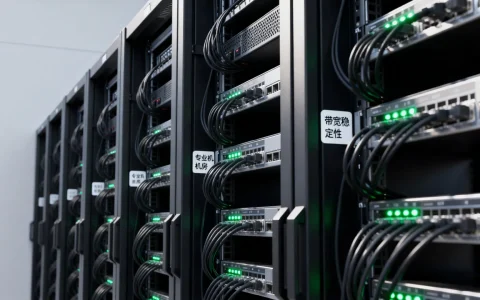
千亿级服务器不是某一款具体机型,而是能支撑千亿参数大模型训练与推理的服务器集群方案,主流选择集中在GPU/加速卡整机柜、超节点和液冷AI集群。 单看品牌容易迷路,先把模型规模、并发、网络、存储和机房条件对齐,再谈选谁。
千亿级服务器有哪些品牌和方案
千亿级服务器有哪些品牌?先按技术路线分
公开产品线里,能覆盖千亿级AI负载的厂商方案大致分几类,它们不是每一台都叫“千亿级”,关键看卡数、显存、互联和软件栈。

- GPU整机与集群方案:NVIDIA DGX/HGX SuperPOD、戴尔PowerEdge XE系列、HPE、Supermicro、联想ThinkSystem/问天、浪潮信息AI服务器、新华三、超聚变、宁畅等,常见形态是8卡GPU服务器加InfiniBand交换机和并行存储。
- 国产加速卡集群:华为昇腾Atlas 900/800系列、中科曙光等,适合信创和国产化适配场景,重点看框架迁移和算子覆盖。
- 超节点/整机柜方案:把多台服务器的高速互联域做大,减少跨机通信开销,适合千亿级训练和长序列推理。
- 云上千亿级算力:简米云、华为云、酷番云、百度智能云等提供按需GPU集群,适合短期POC和弹性推理。
你在机房看到一排8卡GPU服务器,后面接IB交换机,再后面是并行存储,这就是常见千亿级训练集群的物理形态,品牌只是外壳,显存容量、卡间互联、网络带宽、存储吞吐才是内核。
千亿级服务器和普通服务器区别到底在哪
普通服务器以CPU为核心,擅长Web、数据库、虚拟化,千亿级服务器以GPU/加速卡为核心,擅长矩阵运算和高带宽通信,行业共识认为,千亿级服务器的瓶颈往往不在单卡算力,而在集群网络和存储。
| 对比维度 | 普通服务器 | 千亿级服务器 |
|---|---|---|
| 计算单元 | CPU为主 | GPU/加速卡为主,多机多卡 |
| 互联方式 | 以太网为主 | NVLink/NVSwitch、InfiniBand、RoCE |
| 存储要求 | 本地盘/集中式存储 | 高吞吐并行文件系统 |
| 供电散热 | 风冷常见 | 高功率,液冷/整机柜常见 |
| 部署形态 | 单机或小集群 | 整机柜、超节点、大规模集群 |
| 典型用途 | Web、数据库、虚拟化 | 大模型训练、推理、科学计算 |
千亿参数模型仅FP16权重约200GB量级,训练还要加优化器状态、梯度、激活和通信缓冲,单机显存往往不够,需要多机多卡集群,推理侧可以用量化、张量并行把显存压下来,但并发一高,网络和调度又成为重点。
千亿级服务器价格一般多少钱?先看采购方式
价格区间受什么影响
千亿级服务器价格一般多少钱,没有统一报价,单台8卡GPU服务器常见报价从数十万元到数百万元不等;千亿级集群多数落在千万元级到亿元级,具体受卡型、卡数、IB交换、并行存储、液冷和机房改造影响,近年来,租用云上集群做POC的成本比自建更容易控制。
- 卡型和卡数:GPU型号、显存大小、是否带NVLink,直接决定单机价格。
- 网络:IB交换机、线缆、光模块数量一多,预算会被明显抬高。
- 存储:并行文件系统、NVMe全闪、容量和带宽配置,影响训练数据读取效率。
- 机房:高功率机柜、液冷改造、UPS和配电扩容,常被低估。
- 服务:原厂维保、驻场、软件订阅和迁移服务,也要进总账。
采购与POC实操路径
- 先盘点模型参数、训练/推理比例、并发量、精度要求,写成一张需求表。
- 联系厂商售前或系统集成商,要求按“卡数+网络+存储+液冷”出整包方案。
- 申请POC,用真实数据跑一轮训练或推理,不要只看跑分。
- 验收时执行
nvidia-smi topo -m看GPU互联拓扑,执行ibstat和iblinkinfo看IB端口速率与链路状态。 - 用
nvidia-smi -q -d POWER查看功耗上限,用fio --name=read --rw=read --bs=1M --size=10G --numjobs=8 --group_reporting粗测存储带宽。 - 检查
/sys/class/infiniband//ports//rate确认端口速率,BMC里看进出水温度和漏液告警。
北京千亿级服务器采购渠道怎么找
北京千亿级服务器采购渠道可以优先看厂商华北区售前、总代和系统集成商,也可以走云厂商专有云或算力租赁,机房托管要确认高功率机柜、液冷接口和网络出口,合同里写清GPU型号、卡数、维保年限和故障响应时间,避免“同等性能”这类模糊表述。
千亿级服务器适合哪些应用场景
千亿级服务器适合哪些应用场景
- 大模型预训练:千亿参数训练需要多机多卡、IB网络和并行存储,重点看通信效率和故障恢复。
- 推理服务:在线高并发推理更关注显存、批处理、量化和调度,整机柜和超节点能减少跨机通信。
- 行业模型微调:金融、医疗、制造等行业用千亿级底座做微调,常用云上集群加私有数据隔离。
- 科学计算与视频生成:分子模拟、气象、渲染和视频生成也吃GPU显存与带宽。
- 信创场景:国产加速卡集群要提前做框架迁移、算子适配和性能验证。
据工信部公开的算力基础设施政策口径,智算中心建设要看算力、网络、存储和能耗配套,千亿级服务器不是买回来插电就行,机房电力、制冷和网络规划要同步做。
千亿级服务器选型与验收怎么做
先算显存和通信,再谈品牌
业内专家指出,千亿级模型训练要先算显存和通信,再谈品牌,显存不够就上多机,通信不够就上IB或超节点,存储不够就上并行文件系统,顺序反了,预算容易花在刀背上。
- 估算权重显存:千亿参数FP16约200GB量级,训练还要乘上优化器状态和激活。
- 估算通信量:张量并行、流水并行和数据并行的组合,决定IB端口数量和拓扑。
- 估算存储带宽:训练数据读取、checkpoint写入和日志,都会压存储。
- 估算机房条件:单柜功率、液冷能力、UPS余量和网络出口。
验收命令清单
nvidia-smi topo -m:确认GPU之间是NVLink还是PCIe。ibstat、iblinkinfo:确认IB端口Active、速率一致。nvidia-smi -q -d POWER:确认功耗墙和散热策略。fio:粗测顺序读写和随机读写,别只看容量。dcgm diag:如已部署DCGM,可做GPU健康检查。- BMC界面:查看进风温度、风扇转速、液冷流量和漏液传感器状态。
千亿级服务器选型的核心不是追某个品牌,而是把模型规模、并发、网络、存储和机房条件匹配起来。 先做POC再签大单,比只看配置表稳妥。
千亿级服务器有哪些常见问题Q&A
千亿级服务器有哪些必须关注的硬件指标?
先看显存容量和卡间互联带宽,再看IB/RoCE网络、并行存储吞吐、供电散热和整机维保,千亿级训练里,网络和存储经常比单卡算力更早成为瓶颈。
千亿级服务器价格一般多少钱,云租和自建怎么选?
单台8卡GPU服务器从数十万元到数百万元不等,千亿级集群多数在千万元级到亿元级,短期POC、波峰推理适合云租;长期稳定训练、数据不出机房适合自建或专有云,价格要算上网络、存储、液冷和机房改造成本。
千亿级服务器有哪些品牌可以优先考察?
按公开产品线,可考察NVIDIA DGX/HGX、华为昇腾Atlas、浪潮信息、联想、新华三、中科曙光、超聚变、戴尔、HPE、Supermicro等方案,最终选型仍以POC实测结果和商务条款为准。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/789719.html