带宽不够确实会拖慢模型训练,但结论分场景:单机多卡训练几乎不受内网带宽影响,多机分布式训练中带宽不足会直接成为性能瓶颈,且模型越大、并行规模越大,带宽对训练速度的拖累越明显。
内网带宽不够影响大模型训练吗
先说结论:影响极大,但只在跨机场景下体现,你在单台服务器上插8张A100,卡间走的是NVLink,带宽能到600GB/s级别,跟网线没关系,但一旦把训练任务扩展到两台以上服务器,梯度同步就得靠网卡和内网交换机跑,这时候,内网带宽不够影响大模型训练吗?答案是肯定的,尤其是在千亿参数模型场景中。
训练过程里,带宽到底在传什么
分布式训练是数据并行(Data Parallelism)的天下,每张卡拿一个batch的数据,前向传播算完,反向传播算出梯度,梯度算出来之后,得让所有卡拿到全局平均梯度,才能更新模型参数。
这个“让所有卡拿到全局梯度”的过程叫AllReduce,AllReduce传送的数据量和模型大小直接相关。
- 1750亿参数的模型,每个参数对应一个梯度,每个梯度至少4字节(FP32)。
- 一次AllReduce就要传1750亿 × 4字节 = 700GB的数据量。
- 这还只是一次迭代,训练这个模型通常要跑几十万次迭代。
700GB的数据塞进万兆网卡,理论速度是1.25GB/s,一次同步就要560秒,但实际训练里,单次迭代的总时间也就在几秒到几十秒量级,带宽不够,卡就在那里干等,GPU利用率直接掉到个位数。
内网带宽不够影响大模型训练吗?在千亿模型场景下,那不是“影响”,是“锁死”。
什么时候带宽不是首要瓶颈
也有例外,当你用模型并行(Model Parallelism)或者流水线并行(Pipeline Parallelism)时,卡间传输的是激活值和中间结果,数据量比梯度同步小很多,这种情况下,带宽压力反而没那么突出,瓶颈更多在计算本身。
小规模集群(比如2-4台机器)跑中小模型,梯度总量不大,甚至万兆网络也能凑合跑,只是GPU利用率会偏低,但并非完全跑不动。
业内专家指出:带宽问题的严重程度,与模型参数量、并行策略、集群规模三者强相关,不存在放之四海而皆准的结论。
多机训练万兆够用吗
这个问题几乎是所有初次搭建训练集群的团队必问,直说:万兆(10Gbps)在多机训练场景中,多数情况下不够用,尤其是用于梯度同步时。
算一笔账:万兆到底能跑多大的模型
10Gbps万兆网卡的理论吞吐量是1.25GB/s,但注意,这是理论值,实际TCP/IP协议开销、交换机转发延迟、NCCL库的通信效率,通常只能跑到理论值的70%-80%,也就是875GB/s-1GB/s。
拿这个数字对比模型梯度大小:
- 10亿参数模型:梯度总量约4GB,一次AllReduce需要4秒,单次迭代目标时间如果是2秒,通信占比就达到200%,网络完全拖垮训练。
- 1亿参数模型:梯度总量约400MB,一次AllReduce需要0.4秒,单次迭代目标时间如果是2秒,通信占比约20%,影响相对可控。
- 小模型(千万级参数):带宽影响就比较小了。
多机训练万兆够用吗?如果你的模型以亿级为单位起步,万兆显然不够,往上走,25Gbps、100Gbps、200Gbps才是更主流的选择。
RDMA vs TCP:为什么说万兆的短板不只是带宽
除了总带宽,网络协议也有很大影响,TCP协议在数据传输时需要经过内核协议栈,CPU干预多、延迟高,在频繁小包传输场景下效率非常差。
RDMA(Remote Direct Memory Access)允许网卡直接读写GPU显存,绕过CPU内核,延迟极低、CPU占用几乎为零,当前主流的分布式训练框架(如NCCL)对RDMA做了深度优化。
| 网络类型 | 单口速率 | 典型延迟 | CPU占用 | 是否适合梯度同步 |
|---|---|---|---|---|
| 千兆以太网 | 1Gbps | 高 | 高 | 不适合 |
| 万兆以太网(TCP) | 10Gbps | 中高 | 高 | 小模型勉强 |
| 25Gbps RoCE | 25Gbps | 低 | 低 | 中等模型可用 |
| 100Gbps RoCE | 100Gbps | 低 | 低 | 大规模训练主流 |
| 200Gbps InfiniBand | 200Gbps | 极低 | 极低 | 高性能集群标配 |
业内共识是:跑大模型训练,优先考虑RDMA网络(RoCE或InfiniBand),光有高带宽没有低延迟,效果依然打折。
千亿模型多机训练组网需要多大带宽
这个问题的答案很直接:如果你在训练千亿参数级别的模型,单口25Gbps以下基本可以不用考虑,100Gbps是及格线,200Gbps是体验线。
梯度同步带宽需求估算方法
假设你用的是纯数据并行,计算梯度同步所需带宽的公式很简洁:
所需带宽 = 模型参数量 × 4字节 × 2 × 迭代次数/秒
- 公式里的4字节是FP32梯度大小;如果用了FP16混合精度,可以减半到2字节。
- 乘以2是因为AllReduce过程中数据在reduce和broadcast阶段各经过一次网络传输。
- 迭代次数/秒通常由算力决定,千亿模型单次迭代一般在1-10秒之间。
以千亿模型为例,如果目标每秒完成1次迭代(也就是说单次迭代耗时1秒),梯度总量700GB,理想情况下需要14Gbps的最低带宽乘以协议开销系数(通常按1.5-2倍计算),实际需求就在21-28Gbps,这还只是理论下限,没有考虑多机并行度进一步放大的通信量。
千亿模型多机训练组网需要多大带宽?答案是从100Gbps起步,低于这个数,通信等待时间将占据单次迭代的绝对多数。
全互联拓扑与“带宽叠加”陷阱
有人会说:“我8台机器,每台都插了4张25Gbps网卡,总带宽不小啊,是不是就可以了?”
逻辑上没错,但实际传输模式不是“所有网卡同时往一个地方灌”,NCCL在AllReduce中采用Ring-AllReduce算法,通信流量是在环上的相邻节点间流动的,每一跳的实际带宽受限于单条链路,虽然Ring-AllReduce把数据切成小块多路并行,但如网络拓扑设计不当,实际吞吐远低于总带宽之和。
多机场景下的真实瓶颈往往在交换机上联带宽,如果每台机器有4个25Gbps口接在TOR交换机上,但交换机上行只有1个100Gbps口,高峰期就会遇到输出拥塞,吞吐陡降。
硬件层面的实操建议
- 规模在16台以内,选择单口100Gbps RoCE网卡跑NCCL。
- 规模在32台以上,建议上200Gbps InfiniBand,或者用多轨网络把流量分散到多张网卡上。
- 交换机选型不要只看端口数,重点看无阻塞背板带宽,所谓无阻塞,是指所有端口同时满速转发时不丢包。
- 网线(光纤)和光模块必须匹配网卡速率,QSFP28对应100Gbps,QSFP-DD对应400Gbps,规格匹配是前提。
组网方案对比:RDMA vs 传统以太网
选型时最常纠结的问题,核心是看你的集群规模和预算,以及模型训练的通信模式。
| 特性 | InfiniBand | RoCE(RDMA over Converged Ethernet) | 传统以太网(TCP) |
|---|---|---|---|
| 带宽范围 | 100Gbps-400Gbps | 25Gbps-400Gbps | 10Gbps-400Gbps |
| 延迟 | 极低(0.5-2微秒) | 低(2-10微秒) | 高(几十微秒以上) |
| 网络层面流控 | 天生无损 | 需要启用PFC、ECN配置 | 有丢包重传机制 |
| GPU直通能力 | 原生支持GPUDirect RDMA | 支持,但需要额外配置 | 不支持(需走内存拷贝) |
| 成本 | 非常高(硬件厂商锁定) | 中等(基于以太网改造) | 低 |
| 部署维护复杂度 | 简单(生态完整) | 复杂(调参难度高) | 最简单 |
从实际落地来看,大部分中小型团队选择RoCE,因为成熟厂商(如Mellanox/Cisco)提供了完整的无损以太网方案,搭配NCCL能获得接近IB的性能,财大气粗的大厂才会全面铺InfiniBand。
升级带宽的优先级:什么时候该动网络
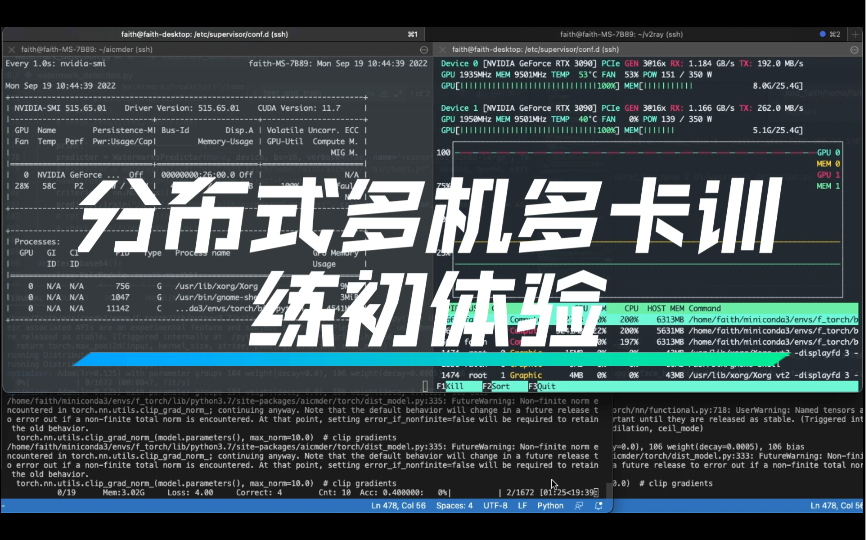
动手升级前,先用监控手段确认瓶颈确实在网络。NVIDIA-SMI里盯显存利用率(Volatile GPU-Util),如果这一项长期低于50%,同时GPU显存占用很高,说明卡在等数据,再用nvidia-smi topo -m查看当前服务器内卡间互联拓扑,确认是否存在NVLink降级或PCIe链路异常。
确认是网络瓶颈后,再按优先级操作:
- 关闭NCCL的P2P检测:环境变量
NCCL_P2P_DISABLE=1可以迫使NCCL走网卡而非内部互联,偶尔能绕过优先级错误的路径选择,提升通信效率。 - 调整NCCL通信算法:设置
NCCL_MAX_NCHANNELS控制通道数,或者用NCCL_ALGO=RING切换Ring算法,减少大报文在树形拓扑下的瓶颈。 - 升级网卡速率:从25Gbps升到100Gbps或200Gbps,这是最直接的,但要注意连接每台服务器的网卡必须同速率,否则集群性能会被最慢的节点拖死。
- 优化交换机设置:在RoCE环境下手动配置PFC(优先流控制)和ECN(显式拥塞通知)参数,具体操作路径是在交换机管理界面的QoS设置中,为RDMA流量启用无损队列,同时给流量打上高优先级DSCP标签。
- 增加带宽聚合:用两张100Gbps网卡做链路聚合(LACP)或NCCL多网卡并行,设置环境变量
NCCL_SOCKET_IFNAME指定多网卡接口名,配合NCCL_MAX_NCHANNELS提升并发通道数。
实操排查:如何判断带宽瓶颈到底存在与否
不停留在理论层面,以下操作步骤可以在你的集群上直接执行,快速判断当前瓶颈点。
第一步:测试理论带宽
在任意两台训练服务器间,用iperf3测TCP带宽:
# 在服务器A启动服务端
iperf3 -s
# 在服务器B发起测试,测试时间20秒
iperf3 -c <服务器A的IP> -t 20
如果实测带宽离网卡标称速率差距较大(比如100Gbps网卡只跑出50Gbps),说明网络配置或硬件链路有隐患,检查是否误开了TCP校验和卸载、网卡固件版本是否过旧、是否缺少最新的驱动。
第二步:用NCCL测试通信吞吐
NCCL官方提供了nccl-tests工具集,其中all_reduce_perf用于直接测梯度同步性能:
# 在每台机器上执行(让所有GPU参与测试)
mpirun -host <所有机器IP> -np <总GPU数> -x NCCL_DEBUG=INFO \
  ./build/all_reduce_perf -b 8 -e 128M -f 2 -g 1
关注输出的busbw字段(总线带宽),它代表实际通信吞吐,如果busbw远低于单卡NVLINK带宽(比如A100的busbw不到600GB/s,或跨机后掉到10GB/s以下),网络问题就坐实了。
第三步:看训练日志中的NCCL告警
训练时设置环境变量NCCL_DEBUG=INFO,如果日志中出现类似:
[1] NCCL INFO NET/IB : Got NPt to send: 8192 bytes
[1] NCCL INFO NET/IB : Retrying tx, retransmissions出现Retrying tx、timeout、rate limited等字样,说明网络已经出现重传或限速,带宽瓶颈直接显现。
第四步:用GPU利用率反推
nvidia-smi dmon -s puc可以每秒采集一次GPU利用率和显存带宽,如果某张卡的GPU利用率反复出现“拉升-掉零”的锯齿形,说明卡在梯度过账的等待期,这种锯齿节奏的频率与AllReduce间隔高度吻合的话,那就是带宽不够的证据。
Q&A:关于训练带宽的常见疑问
Q1:为什么加了带宽,训练速度没变化?
A1:大概率瓶颈不在带宽而在计算和通信的重叠度不足,检查NCCL_DEBUG=INFO的时间戳,如果通信和计算呈串行状态,考虑开启梯度异步通信(torch.distributed中设置bucket_cap_mb调大,例如从默认25MB提升到200MB以上,让梯度更早开始传输)。
Q2:昇腾集群组网带宽配置有什么特殊之处?
A2:昇腾集群的HCCS(高速互联)默认只覆盖单机内卡间通信,跨机仍依赖RoCE或IB网卡,配置要点与英伟达平台类似,但需额外注意环境变量HCCL_CONNECT_TIMEOUT不能设置过小,否则在大规模集群初始化时会因连接超时导致建链失败,昇腾的HCCL默认走HCCL_IB_TC指定的服务等级,如果交换机没开放对应优先级队列,性能会显著下降。
Q3:带宽和延迟,哪个对大模型训练更重要?
A3:小规模短距离传输更看重延迟,大规模梯度同步更看重带宽,单机内多卡走NVLink,延迟极低,因此主要关注带宽;跨机场景梯度总量大,带宽低就意味着分钟级的阻塞,但如果节点数量多且通信频繁,延迟同样会有影响,总体而言,大模型训练普遍是带宽优先,延迟其次。
带宽不是模型训练里唯一决定速度的变量,但它是多机集群里最常被低估的一个,小模型随便跑,大模型就得精打细算,先确认模型规模、并行策略、网络拓扑,再决定要不要升级带宽,比盲目堆硬件更高效。有负载压力的通信集群,网络带宽的多一分投入,通常都能换来GPU利用率更平稳地接近满载。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/789837.html