显存容量越大不等于模型训练越快。 显存大小决定的是“能不能装下”模型,而训练速度主要取决于GPU算力、显存带宽以及数据读写效率,只有在显存不够用、被迫降低批次大小或使用CPU换页时,加大显存才会带来明显的速度提升,换句话说,显存是仓库,算力是工人仓库再大,工人速度不变,出货速度也不会变快。
显存容量越大模型训练越快吗:先分清“装得下”和“跑得快”
显存和算力是两个独立维度
理解这个问题之前,得先拆解GPU训练模型时发生了什么,模型训练时,显卡需要同时存放:
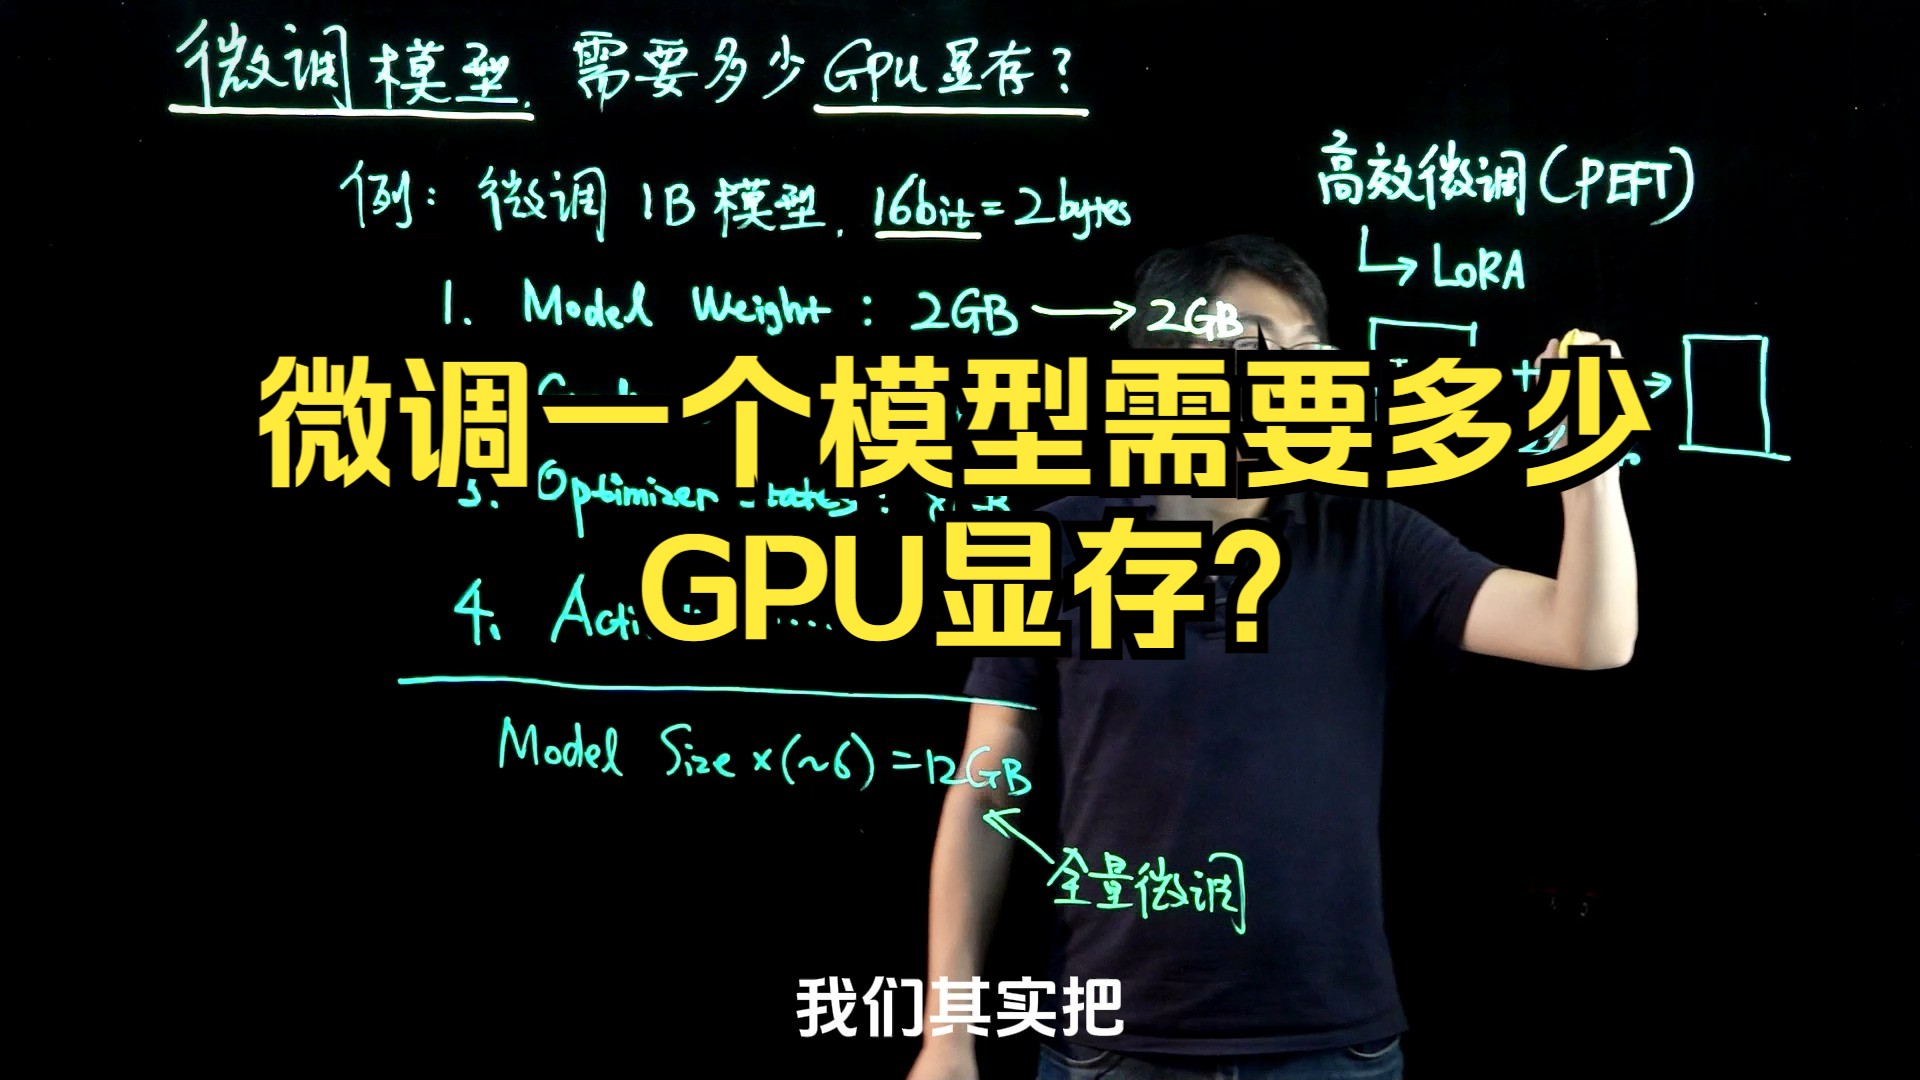
- 模型参数
- 梯度数据
- 优化器状态(如Adam的一阶动量和二阶动量)
- 激活值(前向传播的中间结果)
这些数据的总量就是显存占用,假设你的模型加批次大小需要14GB显存,而你手里的显卡恰好是16GB,那就能跑;如果换成8GB显存的卡,程序直接报错“CUDA out of memory”,一步都动不了。
而训练速度则取决于另外两件事:GPU的计算单元每秒钟能做多少次运算(算力)以及数据从显存搬运到计算核心的速度(显存带宽),这两个指标与显存容量没有直接关系,一张RTX 4060 Ti 16GB的算力远低于RTX 3090 24GB,尽管前者显存只少了8GB,但训练同等规模模型时,4060 Ti的迭代速度可能只有3090的一半甚至更低。
什么情况下显存大确实能提速
虽然显存大不直接等于快,但实际训练中,显存不足确实会严重拖慢速度,常见的影响路径有三条:
-
被迫降低批次大小,在条件相同的情况下,批次越大,GPU利用率越高,显存不够时只能把batch size从32降到8,算力闲置,每次参数更新的步数也变多,训练时间成倍拉长。
-
触发梯度累积,为了弥补batch size缩水,很多人开启梯度累积,相当于多次小批次累加后再更新参数,这会让训练耗时增加30%到50%不等。
-
边训练边换页,少数框架支持将部分参数临时挪到CPU内存,这种“显存换页”会在每个训练步骤中增加大量数据拷贝开销,训练速度可能骤降10倍以上。
如果你恰好卡在显存容量边界上,那么换一张更大显存的卡,训练速度提升是立竿见影的,比如用一个7B参数模型做全参微调,RTX 4090 24GB勉强能塞下批大小为1的配置,中途频繁爆显存;换到RTX 5090 32GB后,批次翻倍,每秒处理的token数量明显上涨,这就是显存容量突破了瓶颈带来的红利。
深度学习显卡显存怎么选:容量与算力的权衡策略
先算清你的训练任务要吃多少显存
选卡之前,有一个粗略估算公式在业内很常用,对于全参数微调来说,显存占用大约是模型参数量的12到20倍,这个数字来自业界多年的实践总结:
- 一个7B模型做全参微调,大约需要84GB到140GB显存
- 一个13B模型,大约需要156GB到260GB显存
- 一个70B模型,没有500GB以上显存基本无法全参微调
而如果只是做推理或者LoRA这类参数高效微调,显存需求大幅降低,以7B模型LoRA微调为例,显存占用通常在16GB到24GB左右,这也是RTX 4060 Ti 16G和RTX 3090成为很多个人开发者首选的原因。
根据预算和需求做取舍
训练场景千差万别,买卡思路也不一样,这里给出几类典型需求的选卡建议:
-
入门尝鲜(显存8-12GB)
适合跑通代码、微调小型模型(1.5B以下)或用LoRA微调7B模型(批次极小、开启CPU offload),这个档位速度不是重点,价格是关键。 -
中度训练(显存16-24GB)
这个区间是当前最主流的玩家配置。RTX 4060 Ti 16G和RTX 3090 24GB经常被放在一起比较,前者价格低、功耗低,但算力缩水严重;后者是上一代旗舰,算力强得多,二手市场价格约在七八千元,性价比更高。 -
专业训练(显存48GB以上)
RTX 6000 Ada、L40S、A100 80G这些级别的显卡,适合处理较大模型的全参微调或预训练,这个赛道里显存容量和显存带宽同步放大,容量大本身就是性能指标。
这里单独聊聊4060ti 16g和3090怎么选,如果你追求“先跑起来”,选4060 Ti 16G没问题它显存够用,功耗低,不需要升级电源,但你对训练速度有要求,二手3090几乎是碾压级的优势:显存多出8GB,算力接近翻倍,唯一代价是功耗高、需要强劲的散热环境,行业共识认为,预算允许的前提下,优先保算力再考虑显存,因为显存不够可以调小批次,算力不够只能干等。
显存带宽:一个容易被忽略的隐藏变量
除了容量和算力,显存带宽其实也直接决定训练速度,显存带宽指的是每秒从显存读取或写入的数据量,单位是GB/s,GPU要不断读取参数、权重和激活值进行计算,带宽不足时,计算核心会处于“等数据”的空闲状态,这时候再大的显存也白搭。
- RTX 4060 Ti 16G的显存带宽是288GB/s
- RTX 3090 24G的显存带宽是936GB/s
同样是读取一份大模型参数,3090花的时间只有4060 Ti的三分之一,这也能解释为什么算力差不太多的两张显卡,实际训练速度能差出一大截,显存大只是上限高,带宽大才是公路宽,车流才快。
显卡显存不够怎么训练模型:四种绕过硬件墙的实操方法
不是每个人都能一步到位买大显存显卡,显存不够时,合理的软件策略能在一定程度上缓解硬件压力,虽然不能完全替代物理显存,但足够让训练跑起来。
梯度检查点(Gradient Checkpointing)
这是最常用的降显存技术,原理很简单:前向传播时不再保留所有层的激活值,而是只保存少量关键节点;反向传播需要激活值时,再重新计算一遍,相当于用额外的计算时间换显存空间,开启后显存占用通常能下降50%到60%,代价是训练速度变慢约20%到30%。
在Hugging Face的Transformers库中,只需要一行配置:
model.gradient_checkpointing_enable()混合精度训练(AMP)
将部分运算从FP32切换到FP16或BF16格式,因为FP16比FP32占用空间少一半,显存占用直接砍半,计算速度也会提升,现代显卡(尤其是RTX 30系及以后)都内置了专用的Tensor Core加速单元,混合精度训练反而比全FP32更快。
在PyTorch中开启方式:
with torch.cuda.amp.autocast():
    output = model(input)
CPU Offload
把优化器状态或部分参数搬到内存中,这里说的内存指系统内存而非显存,虽然传输瓶颈会导致训练变慢,但至少让原本跑不了的训练任务变得可以执行,该方法适合“救急”,比如在16GB显存的显卡上微调7B模型。
分布式训练“众人拾柴”
前面几种方法是在单卡上腾挪空间,分布式训练则是引入多张显卡协同工作,业界主流的DeepSpeed ZeRO-Stage和FSDP方案,可以把模型参数、梯度、优化器状态分散到多个GPU上,举个例子,用4张24GB显存的卡,在ZeRO-3的优化下,理论上足够训练接近70B参数的大模型,这背后的原理是让每张卡只保存模型的一份分片,而非完整副本。
大显存显卡训练大模型值得吗:成本与效率的长期账
值得为“显存余量”多花钱吗
很多人在选购显卡时会追问:要不要为了未来可能增加的模型规模,提前买一张显存更大的卡?答案取决于你的使用周期。
按照每一代GPU大约两年的更新节奏,大显存卡在二手市场的价格保值率较高。RTX 3090发布时价格在12000元上下,三年后的二手价格约7000到8000元,相比之下,中端卡贬值速度更快,如果你未来明确要接触7B以上的开源模型微调,那么多花一点预算换取显存余量,长期来看摊销成本更低。
但反过来,如果只跑1B到3B的模型推理和小规模微调,8GB显存就绰绰有余,花大价钱买24GB显存属于性能冗余,钱没有花在刀刃上。
显存容量和训练速度的最终结论
对“显存容量越大是不是模型训练就越快”这个问题,最终结论可以概括为:
- 显存不足时,加大显存能直接破局、提升速度
- 显存充足时,再增大容量对速度提升毫无贡献
- 真正的速度瓶颈永远是GPU算力和显存带宽的合力
打个比方,训练模型就像是搬运一堆砖头,显存是停车场的大小,算力是搬运工的脚力,带宽是电梯的运载能力,停车场再大,只要停得下车,多出来的空位并不会让搬砖速度变快,但如果停车场小到车都没法停,那不论搬砖工有多强壮,工作都无从开展。
最终决定你训练体验的,不是显存容量这一个数字,而是显存容量、算力、带宽三者之间的平衡匹配。 预算有限时,优先算力;模型很大时,优先容量;卡在边缘场景时,优先运行效率,理解这个逻辑,比盲目追“大显存”三个字要重要得多。
常见问题
用大显存显卡训练同一个模型,一定比小显存快吗
不一定,如果小显存显卡已经能无缝容纳模型训练所需的所有数据,那么速度完全取决于GPU算力,此时把显存从16GB加到24GB,训练速度几乎不会有任何变化,只有显存成为瓶颈时,加大容量才会体现为速度提升。
显存和内存有什么区别,能互相替代吗
显存是显卡专用的高速存储,直接与GPU计算核心相连,带宽可达数百GB/s甚至更高;内存是CPU使用的一般存储,带宽通常在几十GB/s量级,CPU offload方案让内存帮忙分担部分数据,但低频通信和高延迟会明显拖慢训练速度,只适合“慢慢跑通”的场景,无法替代物理显存。
微调大模型时,显存需求是固定的吗
不是,显存需求随批次大小、序列长度和训练方式动态变化,开启混合精度或梯度检查点可以显著降低显存占用;增大序列长度或批次大小则会推高显存占用,调参过程中可以在训练脚本里逐步增大batch size,观察显存使用率,找到当前硬件下的最优配置。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/789886.html