出海应用访问卡顿的根因不在用户手机,而在国际链路的传输效率;与其被动换服务器,不如主动做链路优化。本文从线路调度、协议改造、节点布局三个维度拆解优化方案,帮你把海外用户的请求延迟降下来。
出海应用访问卡顿,链路到底卡在哪一环
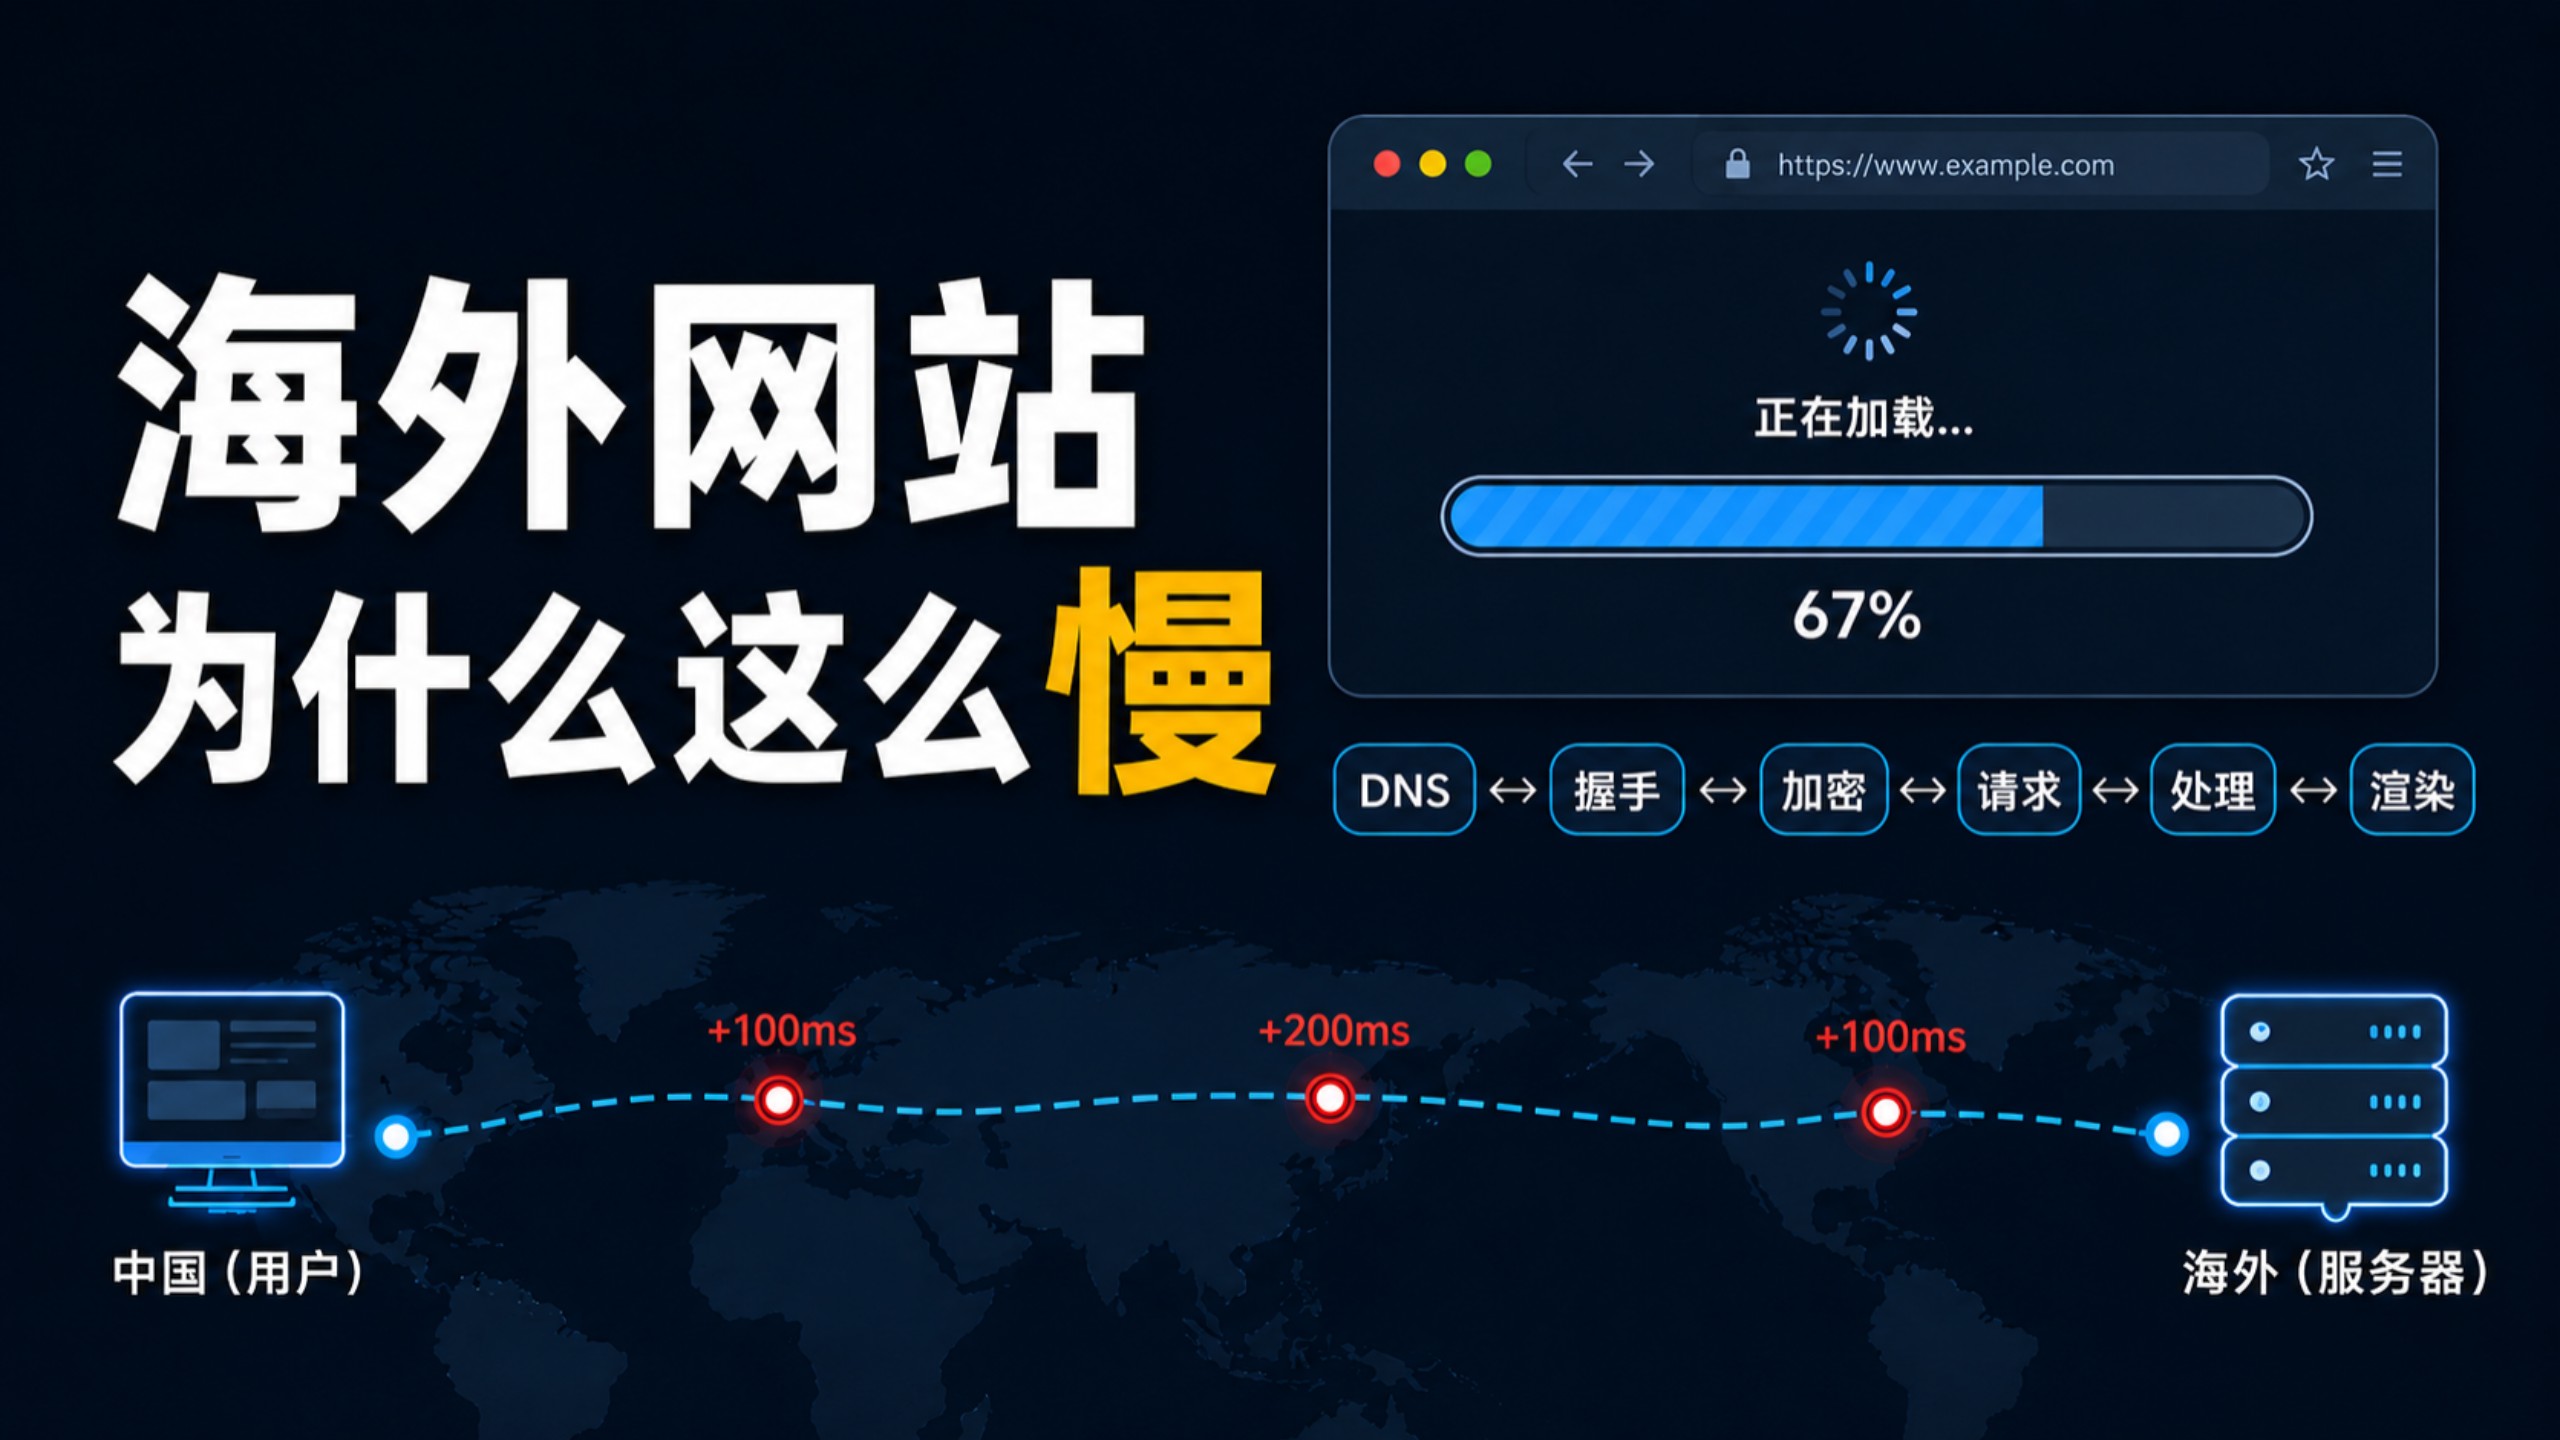
每次用户点击按钮,请求都要走完“用户设备→本地运营商→国际出口→目标服务器”这段路,任何一个环节拥堵,页面就会转圈,业内专家指出,国际链路80%以上的延迟问题出在跨境骨干网的绕路和丢包,而非服务器本身性能不足。
国际出口拥堵:高峰期必然排队
国内到海外的流量都要经过几个有限的国际出口,晚高峰时段带宽被占满,丢包率从平时的0.5%飙到5%以上,表现就是白天流畅、晚上卡死,这个时间段的规律性极强。
跨洋路由绕路:物理距离绕出三倍延迟
国内直连欧美服务器,路由通常要经过多条国际海底光缆中转,比如从上海到洛杉矶,物理直线距离约1万公里,理论延迟100毫秒,但实际路由可能绕道日本或新加坡,延迟直接拉到180-220毫秒,用户感知到的卡顿,很大一部分是这种无谓的绕路造成的。
运营商互联互通:不同网络之间的“过路费”
移动用户访问电信机房的服务器,流量需要经过运营商互联节点,这个节点一旦繁忙,跨网延迟就会比同网访问高出50-100毫秒,出海场景下,这个环节的问题会被国际链路进一步放大。
国际链路延迟高怎么解决,先分清“加速”和“优化”的区别
很多团队一上来就买全球加速服务,但加速≠优化,加速是在现有链路上套一层转发协议,优化是从架构层面减少不必要的传输损耗,两者成本差3-5倍,效果也完全不同。
传输层优化:TCP参数调优是第一步
不要急着上昂贵方案,先把服务器端的TCP配置检查一遍:
- 将TCP初始拥塞窗口从10提升到20,减少慢启动阶段的往返次数
- 启用BBR拥塞控制算法,替代默认的Cubic,在丢包环境下吞吐量能提升数倍(这是Google开源算法,行业共识认为效果显著)
- 调整TCP_NODELAY参数,禁用Nagle算法,减少小包延迟
操作在Nginx层通过tcp_nodelay on即可实现,应用代码无需改动。
协议层改造:UDP比TCP更适合跨国传输
TCP的“丢包重传”机制在跨国链路上是噩梦每丢一个包,要等一个完整RTT才重传,数据像蜗牛一样爬,如果应用场景是实时音视频、游戏同步、动态内容加载,QUIC协议(基于UDP)能带来质的飞跃。
- QUIC内置连接迁移功能,用户切换Wi-Fi也不会断连
- 多路复用避免队头阻塞,一个请求卡住不影响其他资源加载
- 0-RTT握手比TCP+TLS的2-RTT快了一半以上
实际操作中,在服务器部署支持HTTP/3的Caddy或Nginx,动静分离后动态请求走QUIC通道,海外用户的加载时间普遍缩短30%-40%(据公开测试案例统计)。
出海应用网络优化哪家好,核心看调度能力和节点覆盖
当自建链路成本过高、自己优化运维复杂时,选择第三方的全球加速服务是常见路径,但市面上CDN和国际链路优化产品鱼龙混杂,挑选时要盯住三个硬指标:
| 评估维度 | 关键问题 | 达标标准 |
|---|---|---|
| 智能调度 | 是否具备实时路由探测?能否动态切换最优线路? | 路由故障自动切换时间<1秒 |
| 节点覆盖 | 目标市场是否有直连物理节点? | 覆盖目标市场主流城市,而非仅国家节点 |
| 协议兼容 | 是否支持UDP、QUIC等自定义协议? | 支持TCP与UDP双栈加速 |
自建全球加速的最佳实践:中转机 + Anycast
如果你有技术团队,自建cc中转机是性价比最高的方案之一,具体操作路径:
- 在香港、日本、新加坡各部署一台低配BGP中转机(2C2G配置即可)
- 国内服务器与中转机之间建立WireGuard隧道,开启
KeepAlive保活 - 海外用户就近接入中转机,由中转机通过内网专线转发请求到源站
这套方案要求源站与中转机之间网络质量优秀,常见做法是使用同一云厂商的不同区域实例(如简米云香港→简米云新加坡),走云厂商内网传输,不占用公网带宽。
节点选择的地域逻辑:离用户近不如离网络近
行业共识认为,物理距离不是唯一指标,骨干网直连质量比地理距离更重要,比如你的产品主攻东南亚市场,选择部署在新加坡而不是马来西亚吉隆坡可能是更优解新加坡是东南亚国际网络枢纽,几乎所有海底光缆都经过这里,而吉隆坡的本地网络可能还要绕道新加坡中转,实际延迟反而更高。
选择节点前做一次真实测速是必须的:
- 使用
MTR工具观察目标IP的每一跳延迟 - 丢包率超过2%的路径直接排除
- 用
iperf3测试吞吐量,两次测试之间间隔24小时以上,避免偶然性
应用层加速技巧:让用户感知不到卡顿的存在
链路优化解决的是“传输快不快”,应用层优化解决的是“感觉快不快”,两个配合起来,体验才能拉满。
动静分离缓存策略
- 静态资源(图片、CSS、JS)缓存到全球CDN节点,用户就近加载,回源率控制在10%以下
- 动态API请求走优化后的国际链路,配合响应压缩(Gzip/Brotli),减少传输体积
- 图片使用WebP格式,体积比PNG小30%(据统计,主流站点使用WebP后首屏体积平均下降25%-35%)
异步加载与骨架屏
把非关键的接口请求延后,首屏只加载核心内容,骨架屏先渲染页面框架,数据到了再填充具体内容,用户的认知延迟从“卡顿”变成“加载中”,感知差异巨大。
预连接与预渲染
- 在HTML头部使用
<link rel=“preconnect”>提前建立第三方域名连接 - 对跳转概率高的下一页面(如从列表页到详情页)使用
<link rel=“prefetch”>提前拉取
这两行代码成本几乎为零,却能让用户感觉“点击后立刻就打开了”。
出海应用卡顿用什么加速方案,成本与效果怎么平衡
不同阶段的团队适用不同方案,不必一步到位,常见加速方案价格对比(按月计费估算,实际价格以服务商报价为准):
| 方案 | 投入成本 | 适用阶段 | 延迟改善幅度 |
|---|---|---|---|
| TCP参数调优 | 0元 | 所有阶段 | 10%-20% |
| QUIC协议改造 | 1-2人天开发 | 有自研能力团队 | 30%-50% |
| 自建cc中转机 | 服务器费用≈100-500元/月 | 有一定运维能力 | 30%-60% |
| 第三方全球加速 | 数千元/月起 | 无专职运维团队 | 40%-70% |
出海应用网络优化预算不足时的优先级
预算有限时,优化顺序是:先内核调优、再协议升级、最后考虑加节点,很多团队的卡顿问题本质上只是TCP参数没调,花了冤枉钱买加速服务,效果反而跟着凉。
一个细节点:开启BBR后要检查是否真的生效。sysctl net.ipv4.tcp_congestion_control命令会输出当前拥塞控制算法,如果显示bbr才算成功,改完之后记得sysctl -p刷新。
Q&A:出海应用网络优化的常见疑问
问题1:出海应用访问卡顿,换一家云厂商的海外机房能解决吗?
换机房只是把服务器的位置挪得更近,但国际链路的核心问题跨网互联拥堵和路由绕路依旧存在,如果是物理距离导致的延迟(比如服务器在英国、用户在美国),换机房有效;但如果是晚高峰国际出口拥堵,换机房收效甚微。
问题2:出海应用用什么加速方案成本最低且见效快?
先启用BBR拥塞控制算法,再开启Nginx的tcp_nodelay和HTTP/3支持,两项操作总共不超过半小时,成本为零,适用于所有类型的出海应用,比亚迪式的极端案例是个别地区的跨洋链路丢包率超过10%,BBR的提升幅度反而有限,此时需要配合节点中转或第三方加速。
问题3:如何判断链路问题出在服务器端还是用户侧?
服务器回源服务器上用mtr测试到用户当地干净DNS(如8.8.8或1.1.1)的路径,如果最后一跳延迟正常但整体延迟高,说明是国内与海外之间的链路问题,与用户本地网络无关;如果从多个海外监控点测试结果差异巨大,优先怀疑路由调度策略。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/789977.html