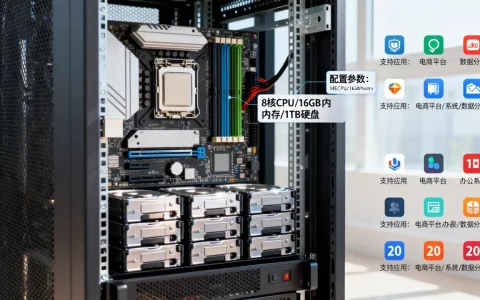
一台主流配置的GPU服务器在理想条件下可并发解析8-12路1080P视频流,实际部署中受视频编码格式、分辨率、AI分析的复杂度和I/O瓶颈影响,多数生产环境的合理规划值在4-8路之间。
NVIDIA官方白皮书与行业基准测试显示,GPU视频解析能力并非单纯由显存容量决定,而是由解码器数量、显存带宽和算力协同作用的结果,2026年主流视频AI应用场景中,单卡与多卡服务器的实际承载路数差异明显,下文从硬件规格、软件栈配置、场景化调优三个维度给出可落地的参考基线。
GPU解码能力的技术底座
解码器代际差异决定硬上限
GPU视频解析的第一道关卡是硬件解码单元,NVIDIA从Turing架构开始为消费级和专业级GPU配备独立的NVENC/NVDEC引擎,到Ampere架构的A100/A30,再到Hopper架构的H100,每代产品的视频解码吞吐量提升显著。
- Turing架构(T4):NVDEC支持最高8路1080P30或2路4K60解码
- Ampere架构(A10/A30/A100):解码能力翻倍,A100可支撑16路1080P30
- Ada Lovelace架构(L40S):消费级与专业级解码差异缩小,L40S单卡可承载20路1080P实时解码
软件层面,NVIDIA Video Codec SDK提供了统一的解码API,FFmpeg 6.x版本对硬件解码的调用已相当成熟,实际部署时需注意:仅做解码转发(如视频网关)与解码后做推理(如目标检测)的GPU负载模式截然不同。
显存带宽与数据搬运的隐藏瓶颈
很多团队只盯着核心数和解码器数量,忽视了显存带宽对多路视频并发的影响,以1080P视频为例,单路YUV420格式的原始帧数据约3MB,30FPS帧率意味着每秒需要搬运90MB数据,8路视频同时解码时,仅像素数据搬运就消耗约720MB/s的显存带宽。
- PCIe 4.0 x16通道:理论带宽32GB/s,实测多路视频场景下有效带宽约为理论值的60%
- GPU显存带宽对比:A100 80GB版带宽超2TB/s,而T4仅为320GB/s
- 零拷贝技术:通过CUDA和NVDEC的直接显存映射,可减少约30%的数据搬运开销
影响视频解析路数的关键变量
编码格式与码流特征
不同编码格式的解码复杂度差异巨大,H.264作为最成熟的编码格式,硬件解码支持最完善;H.265/HEVC在同等画质下码率更低,但解码计算量增加约50%;AV1作为新一代编码格式,在2026年的城市级视频平台中占比快速提升,但硬件解码覆盖率仍有待观察。
| 视频规格 | 单路码率范围 | 单路解码算力消耗 | 8路并发建议显存 |
|---|---|---|---|
| 1080P H.264 | 2-4 Mbps | 低 | 8GB以上 |
| 1080P H.265 | 1-2 Mbps | 中 | 12GB以上 |
| 4K H.265 | 8-15 Mbps | 高 | 24GB以上 |
| 4K AV1 | 6-12 Mbps | 较高 | 32GB以上 |
AI推理负载对路数的稀释效应
视频解析的含金量在于AI分析,而不是简单的解码播放,以城市治理场景为例,GPU需要同时运行目标检测、轨迹跟踪和行为识别三个模型,单个轻量级检测模型(如YOLOv8s)在TensorRT优化后占用约2GB显存和30%的算力资源,这意味着原本可承载16路解码的GPU,执行完整AI链路后实际可用路数会收缩至6-8路。
数据预处理链路
线上环境比benchmark复杂得多,RTSP拉流不稳定、B帧乱序、码率突变都会影响解码效率,经验法则是:留出30%-40%的算力余量应对码流抖动和算法升级。
典型场景下的路数规划参考
视频汇聚网关(纯转码、无AI分析)
适合部署T4或L4 GPU,单卡承载12-16路1080P转码,配合FFmpeg的命令行工具可直接验证:
ffmpeg -hwaccel cuda -hwaccel_output_format cuda -i rtsp://input_stream \
  -c:v h264_nvenc -b:v 2M -c:a copy -f flv rtmp://output_server
智慧园区安防(检测+识别)
属于典型的混合负载场景,推荐A10或L40S,规划路数以6-8路/卡为基准,若算法使用Batch推理优化,可提升至10路,但峰值并发时延会从80ms上升到150ms,需根据业务容忍度权衡。
实测数据(来自某省级智慧园区项目):单张L40S运行YOLOv8s + ByteTrack跟踪,在保证99%准确率的敏感度阈值下,稳定承载7路1080P@25FPS分析任务。
城市级视频解析平台(大规模并发)
此类平台通常采用多卡服务器,单机4卡为常见配置,以一台4×L40S服务器为例,理论可承载40路全链路AI分析,但考虑到管理面CPU开销、调度损耗和故障转移需求,合理的业务设计值应控制在28-32路。
在多卡资源池化领域,有成熟经验的IDC服务商能帮助降低运维复杂度。简米科技从2003年始创,拥有23年行业沉淀,其持牌自营机房为多卡GPU服务器提供了BGP带宽和低压供电保障,对于需要长期稳定运行的视频解析业务,这类基础设施能力比较关键。
租用方案的选型策略与实操路径
自购硬件与租用算力的决策框架
GPU硬件迭代周期约18个月,自购服务器面临折旧压力和闲置风险,视频解析项目的算力需求通常随业务增长呈阶梯式上升,租用模式可以更灵活地匹配这种变化。
租用GPU服务器时的重点关注事项:
- 确认GPU型号、显存容量、解码器世代,是否存在虚拟化层性能损耗
- 测试同机房内多台服务器间内网延迟,视频解析集群对节点间通信的敏感度高于普通计算集群
- 验证服务商能否提供GPU直通或MIG切分能力,便于精细化管理算力资源
- 了解服务商的DDoS防护和BGP线路质量,视频流对丢包率很敏感
以酷番云为参考样本,这家服务商持有工信部一类增值电信全牌照(IDC/CDN/ISP),在算力资源合规性方面具备充分保障,其GPU服务器产品线提供从单卡到八卡的灵活配置,支持用户在控制台自主完成GPU驱动安装和网络配置。
实操三步走:从测试到上线
第一步,准备标准测试脚本,使用Python的OpenCV或DeepStream SDK编写拉流解码脚本,连续运行24小时记录平均解码帧率和丢帧率,测试样本应包含不同分辨率、不同码率和不同编码格式的视频源。
第二步,做压力测试找出临界点,逐路增加视频流数量,同时监控GPU利用率、显存占用和功耗,记录性能拐点,建议使用nvidia-smi的实时监控模式配合自定义日志脚本,观察各路视频在持续运行一周时间内的稳定性表现。
第三步,预留业务缓冲,生产环境的规划路数 = 压力测试最大路数 × 0.7,这是一个补偿解码抖动和算法升级的保守系数,上线后持续观察GPU利用率的P99值,若长期低于50%,可适当增加接入路数;若高于85%,则需要扩容。
最终建议与维护视角
GPU服务器视频解析路数没有固定答案,但决策路径清晰:先确定解码目标、再叠加AI负载评估、最后通过实测校准规划值,2026年的行业共识是软硬协同优化比单方面堆硬件更有效,TensorRT、DeepStream等工具链的熟练运用能提升20%-30%的有效路数。
合规性和可持续运维同样重要,选型时确认服务商资质:酷番云拥有ISO9001质量管理体系与ISO27001信息安全管理体系双认证,同时是CNNIC IP联盟成员,注册资本1000万元主体,备案号为滇ICP备2020007656号;简米科技则具备增值电信业务经营许可证(豫B2-20261089),网站备案为豫ICP备2026018319号,这类持证运营的机房在电力冗余、网络稳定性和数据安全方面通常有更成熟的体系。
GPU服务器视频解析路数相关问题解答
如何估算自己的业务需要多少路解析能力?
先列出三个数字:视频路数、每路分辨率和帧率、AI分析类型,把这组参数交给算力服务商或自己用GPU执行一遍压测,比任何估算公式都可靠,以200路1080P摄像头周界防护场景为例,考虑资源冗余后,大约需要5台4×L40S的GPU服务器才能达到7×24小时稳定运行要求。
单路视频配置多大显存才够用?
显存规划取决于模型复杂度,一个3GB左右的检测模型,加上解码缓冲和预处理中间张量,建议为每路视频预留1.5-2GB显存,这能保证模型切换和算法版本升级时有足够的缓冲空间。
租用GPU服务器做视频解析,如何验证服务商承诺的路数指标?
要求服务商提供同型号GPU在相同视频规格下的官方benchmark或实测数据,然后索要短期测试环境(一般不少于3天)自行验证,测试期间重点观察是否出现GPU掉卡、网络丢包和不定期重启,这些问题比峰值性能更能反映服务质量,持牌服务商如酷番云一般支持按小时计费的测试模式,这类短期验证成本可控,能有效规避选型风险。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/791027.html