服务器日志字段有哪些?一文拆解日志里的全部秘密
服务器日志是运维与开发人员排查问题的第一现场,其核心字段主要包含时间戳、客户端IP、请求方法、请求URL、协议版本、状态码、响应字节数、User-Agent、Referer等十多个基础信息,而进阶场景还会涉及响应时间、上游服务器地址、Cookie、会话ID与安全审计字段。 理解这些字段的含义,远比死记硬背日志格式更重要,我把这些字段挨个“请”出来,让它们自我介绍一番。
日志字段的“第一梯队”:所有服务器都有的基础字段
打开一份Nginx或Apache的访问日志,默认格式里就藏着几个老熟人,它们构建了每一次HTTP请求的骨架。
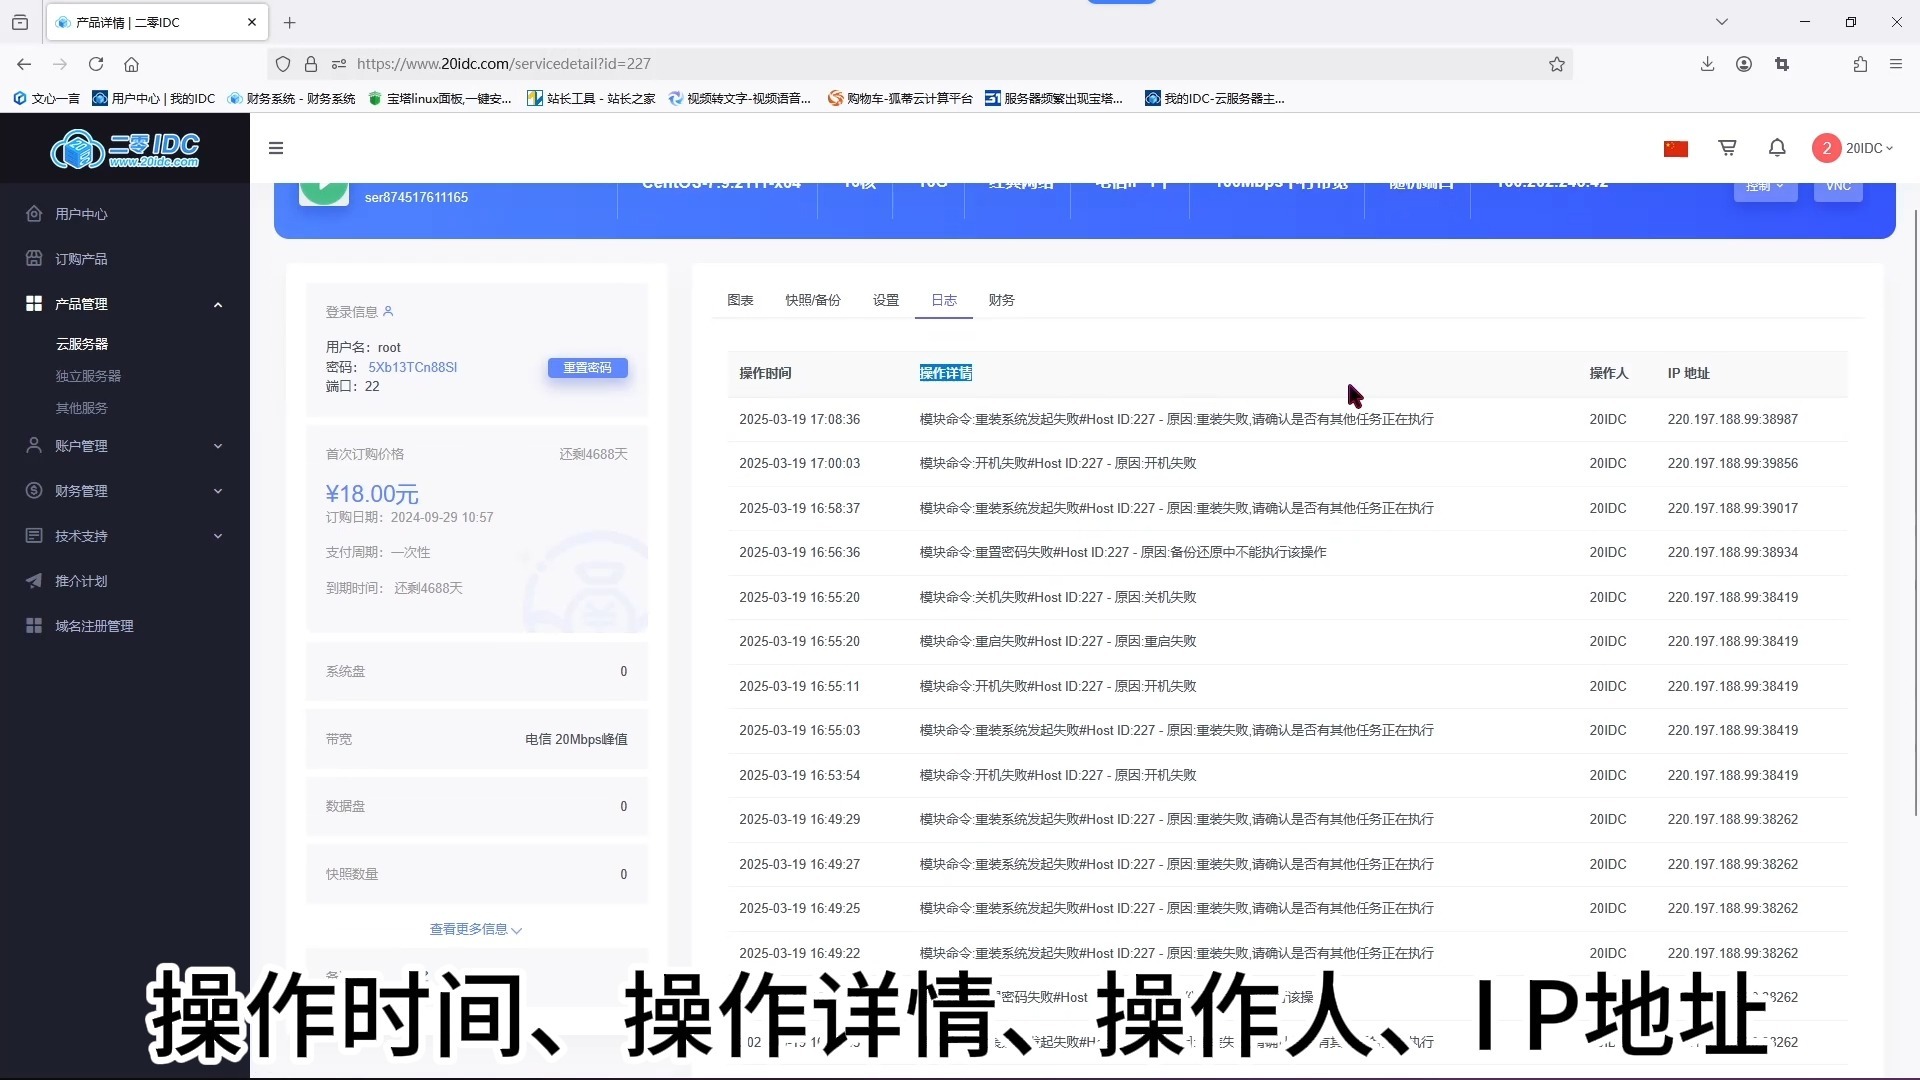
时间戳:记录请求发生的精确时刻
这个字段通常格式为 [10/Oct/2026:13:55:36 +0800],包含了日期、时间与时区信息,它不仅仅是给人看的,更是用来做日志排序、性能分析、以及排查特定时间点故障的锚点,没有它,日志记录的先后顺序将陷入混乱。
客户端IP:找到那个“敲门”的人
它记录了发起请求的设备IP地址,别小看这个字段,它直接决定了你是放行还是拦截,但要注意,当服务器前面挂了CDN或负载均衡器时,记录到的IP可能是代理服务器的地址,此时需要查看X-Forwarded-For字段来取得真实客户端IP,这是运维排查中常见的坑。
请求方法与请求URL:看穿用户想干什么
请求方法一般是GET、POST、PUT、DELETE等,它代表了操作类型,请求URL则是具体访问的资源路径,比如/index.php?id=123,这两个字段组合起来,能还原出用户完整的操作意图,对于网站安全分析,重点关注POST请求是否异常频繁,以及URL参数中是否带有SQL注入等可疑特征。
协议版本与状态码:对话的结果如何
协议版本通常是HTTP/1.1或HTTP/2.0,状态码是服务器给用户的“回执”,比如200代表成功,404代表资源不存在,500代表服务器内部错误,这一串三位数字是排查问题的导航灯,如果日志里出现大量503或502,基本可以判断是服务端或网关出了问题,而非用户的网络故障。
进阶字段全解读:让日志开口说话的细节
当问题定位需要更深入时,我们就要依赖扩展日志格式中的字段了,以下字段能帮我们明确区分“是谁的锅”。
响应字节数:消耗了多少流量
它记录服务器返回给客户端的内容大小,单位是字节,这个数字有助于统计网站的带宽消耗,也能侧面反映页面加载的数据量,如果某个URL的响应字节数异常巨大,可能要检查是否有大文件被频繁请求了。
Referer 字段:用户从哪里跳转来的
它记录了上一个页面地址,假如URL为空,则可能是用户直接输入网址或从收藏夹访问的,这个字段在分析流量来源时非常关键,能直观看到是从百度搜索来的,还是从外链广告来的。用户常搜“Referer字段怎么看流量来源”,本质就是靠这个字段做分析。
User-Agent:看清用户使用的客户端环境
它包含了用户的操作系统、浏览器类型及版本号,甚至能识别出是不是爬虫,以Mozilla/5.0开头的一般是正常浏览器,而包含python-requests或curl的,很可能是脚本工具,攻击者常伪造此字段,所以它只能作为参考依据,不能作为信任凭证。
响应时间(request_time / upstream_response_time):性能瓶颈的探针
这个字段记录了服务器处理请求总共耗时多久,单位通常是秒或毫秒,在Nginx日志中,request_time指代全程处理时间,upstream_response_time指代后端服务器处理时间,两者一对比,就能快速判断是Nginx自身慢,还是PHP-FPM或Java后端慢。
上游服务器IP(upstream_addr):找到内鬼
当使用反向代理时,它会记录请求实际转发给了哪台内网服务器,这在多节点负载均衡环境中尤其重要,能精准定位是哪一台机器出现了延迟或错误。
常见日志格式对比:Apache、Nginx与JSON
不同服务器软件默认的日志字段排版略有不同,理解它们之间的差异,能帮你更快的在真实环境中对号入座。
| 属性 | Nginx 默认 combined 格式 | Apache 默认 common 格式 | 建议的 JSON 格式 |
|---|---|---|---|
| 时间字段 | 01/Jan/2026:00:00:00 +0800 |
[01/Jan/2026:00:00:00 +0800] |
"time_local" |
| 请求信息 | "GET / HTTP/1.1" |
"GET / HTTP/1.1" |
"request" |
| 状态码 | 200 |
200 |
"status" |
| 响应大小 | 1024 |
1024 |
"body_bytes_sent" |
| 来源地址 | "http_referer" |
Nginx 的 combined 格式中,在没有数据时会用 (短横线)填充占位。Apache 的字段顺序与 Nginx 略有不同,但核心含义一致,近年来,越来越多的团队把日志格式改为JSON,因为JSON自带键值结构,无需依赖空格或引号来区分字段,直接对接ELK等日志分析系统时,能省去大量的解析正则表达式编写工作。
安全场景下的特殊字段:日志里藏着黑客的脚印
常规字段满足不了安全审计需求,这时候需要额外记录一些特定字段,安全日志与访问日志最大的区别在于,它更关注“谁用了什么权限干了什么”。
- 会话ID(Session ID)与Cookie:用于追踪用户的一次完整会话流,一旦发生账号被盗,根据会话ID可以快速串起黑客的整个操作链条。
- X-Forwarded-For 字段处理:在WAF(Web应用防火墙)日志中,这个字段是必看的,因为攻击者常用伪造IP的方式绕过访问控制,如果配置不当,直接信任
X-Forwarded-For,很容易被伪造IP骗过。 - 请求体(Request Body):在高安全级别场景下,还需要记录POST请求的原始Body内容,这有助于事后分析攻击payload,但数据量巨大且涉及隐私,需谨慎开启。
如何配置和查询字段:实操步骤指南
光认识字段名字不够,你得知道它们从哪里来,到哪里去,以最常见的Linux服务器为例,日志通常存放在 /var/log/ 目录下。
Nginx日志格式配置示例
打开Nginx配置文件 nginx.conf,在http块内定义一个日志格式:
log_format main '$remote_addr - $remote_user [$time_local] "$request" '
                '$status $body_bytes_sent "$http_referer" '
                '"$http_user_agent" "$http_x_forwarded_for"';
定义好之后,在对应的server块或location块中引用它:
access_log /var/log/nginx/access.log main;
保存后执行 nginx -t 测试配置,无误后执行 nginx -s reload 生效。
快速查询技巧:用 grep 和 awk 提取字段
当你需要从几万行日志中找出“某个IP在今天访问了哪些页面”时,用文本命令是最高效的,比如查看今天IP地址为 2.3.4 的请求记录:
grep "$(date +%d/%b/%Y)" /var/log/nginx/access.log | grep "1.2.3.4"
若只想提取状态码为500的请求耗时,可用awk按空格分割字段来做,但如果是复杂的多条件聚合查询,建议将日志导入专业的日志分析平台(如ELK、Loki),用KQL或Lucene语法来查询,效率会高得多。
日志字段分析的常见误区与工具
行业共识认为,日志分析最怕的不是字段少,而是字段值不标准,比如时间戳时区不统一,或者IP字段里混入了端口号,会导致统计出现严重偏差。
忽略代理层IP字段
如前所述,如果不解析 X-Forwarded-For,那么所有日志分析都会指向CDN节点IP,导致用户地域分布统计失真,正确做法是在Nginx配置中显式记录该字段,或在日志清洗阶段取逗号分隔的第一个IP。
不保留原始日志
很多人为了省磁盘空间,只配置了经过聚合的统计日志,一旦遇到恶性攻击,想回放原始请求却无据可查。建议至少保留最近180天的原始访问日志,并定期冷备到对象存储中。
分不清业务字段与技术字段
日志分析不能只依赖运维的访问日志,业务订单号、用户UID等技术字段,应该在应用日志(如Java Logback或Python Logging)中打点,访问日志解决“请求通不通”的问题,应用日志解决“业务对不对”的问题,两者结合才是全链路的可观测性。
Q&A:围绕服务器日志字段的疑问解答
问:服务器日志里记录的用户IP地址能作为唯一身份标识吗?
答:不能,无论是IPv4还是IPv6,IP地址都可能被多个用户共享(如企业出口NAT、家庭路由器),IP地址只能作为定位网络位置的参考值,不能作为识别用户的唯一凭证,在精确统计独立访客时,应优先结合Cookie中的唯一标识符。
问:为什么我的Nginx日志里时间比北京时间慢了8小时?
答:这通常是因为Nginx配置中未指定正确的时区,在Nginx配置的http块中,添加log_format时如果使用了$time_local变量,它遵循的是系统时区设置,如果系统时区设置为UTC,日志时间就会比东八区慢8小时,解决方法是修改系统时区为Asia/Shanghai,或者在配置中显式使用 $time_iso8601 并处理好偏移量。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/791038.html