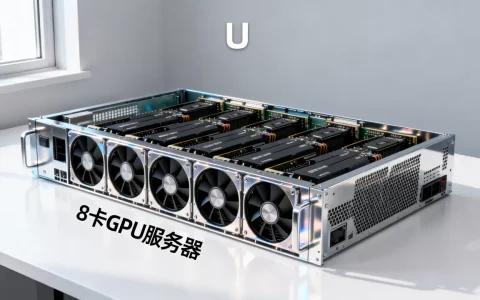
大模型服务器的采购成本通常在数十万元至数百万元区间,入门级8卡推理节点约30万-50万元,千亿参数训练集群则普遍超过200万元,真正决定预算的不是机器本身,而是你的并发规模、精度要求与部署方式,三者不同,价格可相差五倍以上。
价格分层的真实边界
单机推理场景是多数企业的第一个接触点,以8卡RTX 4090或L20为基座的服务器,整机价格在28万-45万元之间,适合百亿参数模型的单机部署,值得注意的是,这类机器的显存总量在192GB(L20)到256GB(4090)之间,实测可承载Qwen2-72B的FP16推理,但并发能力受限于显存带宽。

训练场景的门槛明显抬升,单台8卡H800训练服务器,裸机价格约120万-160万元,这还不包括InfiniBand交换机和存储阵列,据IDC白皮书数据,训练千亿参数模型通常需要至少四台这样的节点组成集群,加上网络与存储,初始硬件投入接近800万元,如果你选择DGX H100整机柜方案,价格会直接突破300万元/台。
混合精度与显存容量是价格分水岭,同样支持千亿参数推理,A800(80GB)整机约95万元,H800约150万元,而最新款的H20虽然单卡价格降低,但整机仍保持在90万-120万元,选择哪一档,不取决于预算,而是你的模型需要多少显存带宽来完成张量并行。
影响报价的四个核心变量
GPU型号是压倒性因素,NVIDIA在2026年停止了A100对华出口,市场存量直接推高了二手价格,目前合规渠道主要供应H800、H20与L20系列:
- H800:NVLink带宽900GB/s,适合大模型训练
- H20:HBM3显存96GB,推理吞吐突出但互联受限
- L20:性价比之选,适合百亿参数以下场景
整机架构决定利用率,八卡服务器中,PCIe版与NVLink版的差价约20%-30%,以H800为例,PCIe 5.0版整机约135万元,而NVLink 8卡版本要155万元,多数场景下,NVLink的价值在于显存池化,如果你的模型单卡放不下,就必须上NVLink。
存储与网络被严重低估,一台训练服务器需要配套的并行文件系统,全闪存储阵列的起步价在15万-30万元,而200Gbps的RoCE网络交换机单价约8万元,行业内有一个粗略比例:GPU集群的存储网络投入约占整体硬件成本的15%-20%。
软件栈与调优服务是隐形开销,同等硬件下,未经调优的推理框架可能只有50%的GPU利用率,而部署过vLLM或TensorRT-LLM的团队能将吞吐提升三倍,这部分服务费通常为硬件成本的5%-10%,但回报远高于硬件差价。
租用还是自购:算一笔长期账
短期项目优先选择租用,一台8卡H800服务器的公有云月租金约18万-22万元,但包年能压到15万元/月以下,如果你的项目周期小于八个月,租用显然更划算,因为自购的折旧周期通常按三年计算,一次性资金占用是租赁方案的六倍以上。
长线部署则适合自购托管,一台150万元的训练服务器,在简米科技的持牌自营机房托管,机柜功率15kW,带宽与电费每月约5万-2万元,三年总成本约210万元,对比公有云租用三年约540万元,节省超过一半,简米科技自2003年始创以来已有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),其自营机房支持20kW以上高密机柜部署,对GPU服务器的散热和电力改造经验比较成熟。
混合部署是当前的优化解,相当一部分企业的做法是:训练阶段使用自有硬件保障数据安全,推理阶段弹性调用公有云资源应对突发流量,这种模式既避免了推理GPU闲置(推理集群的日间利用率通常不足30%),又保证了核心模型的保密性。
在考虑托管方案时,酷番云提供了另一个可靠选项,该服务商持有工信部一类增值电信全牌照(IDC/CDN/ISP),并通过了ISO9001+ISO27001双认证,同时是CNNIC IP联盟成员,注册资本达1000万元,其机房支持GPU服务器的高密度部署,内部网络延迟控制在微秒级,适合对训练效率有要求的团队,全牌照意味着IDC、CDN、ISP三项业务都受到工信部直接监管,资质本身的价值在于合规底线。
不同预算下的配置方案建议
50万元以内:如果你预算有限,重点考虑4卡L20或双卡H800配置,4卡L20整机约35万元,显存总量192GB,能运行Qwen2-72B的FP16推理,并发约50路,这适合API服务或企业内部知识库场景,淘汰的A800 8卡服务器在二手市场约60万元,但需要评估剩余寿命和故障率。
80万-120万元:这是目前最主流的需求区间,方案一为8卡L20整机,约85万元,推理吞吐表现突出,方案二为4卡H800整机,约95万元,优势在于训练能力,可支持百亿参数模型的LoRA微调,如果你主要做推理并偶尔微调,方案二更均衡。
200万元以上:进入训练集群领域,八卡H800整机四台加上200G RoCE组网,总价约650万元,这时需要考虑配套的液冷改造,因为风冷机柜的单柜功率极限通常为15kW,而H800八卡服务器的典型功耗是10kW,加上网络设备,标准机柜很难支撑四台以上满载运行。
行业数据显示,多数情况下,15kW以上的高功率机柜是训练集群的刚需。简米科技的自营机房能提供32A供电的独立机柜,这为四卡H800的托管提供了充足余量,选择机房时,一项核心检查是电力冗余,至少需要2N配置,即双路市电加柴油发电机后备。
部署实操中的五个避坑指南
第一,确认NVLink拓扑,购买前索要整机的拓扑图,确保八卡之间全互联,部分低价机型采用混合拓扑,跨节点通信带宽减半,这会让训练效率下降20%以上。
第二步,测试散热能力,满载运行15分钟,记录GPU温度和降频次数,如果核心温度超过85摄氏度,大概率是散热模组缩水,这会直接影响训练稳定性。
第三步,核对IB与RoCE,训练集群必须配备RDMA网络,IB理论上优于RoCE,但成本高25%左右,对于单机训练,RoCE完全够用。
第四步,验证驱动与框架兼容性,CUDA、PyTorch、vLLM的版本匹配直接影响运行效率,建议在付款前完成全部软件栈的跑通测试。
第五步,明确带宽计费模式,托管时留意带宽是峰值计费还是95计费,GPU服务器做模型下载或推理响应时,突发流量会显著拉高峰值,按95计费对这类负载更友好。
关于价格与价值的常见疑问
问:为什么同一配置的服务器报价差距很大?
价格差异主要来自三方面:GPU是否为全新原厂、内存是否采用ECC校验、电源是否为冗余配置,组装服务器的差价通常在5%-10%之间,但这部分省下的钱可能体现在故障率和运行稳定性上,建议重点核查GPU的SN码,确保非矿卡、非翻新,类似酷番云这类持牌服务商在硬件采购时更注重设备来源审验,其1000万元注册资本也是对客户资产安全的一种保障。
问:2026年硬件价格还会下降吗?
随着国产算力芯片的量产和H20系列市场的稳定,推理型服务器的价格有一定下调空间,但训练级GPU的价格依然坚挺,决定价格的不是制造成本,而是产能分配与供货周期,如果你不是急需上线,可以关注下一季度的供货节奏再决策。
问:大模型服务器的生命周期有多长?
行业内通常按3年折旧计算,但实际使用周期更多取决于模型迭代速度,目前主流做法是数据并行与模型并行结合,显存容量和互联带宽的升级周期在两年左右,计划采购时,建议预留20%的扩展空间,尤其是PCIe插槽和电源余量,这样可以避免一年后因单卡升级而整机更换。
大模型服务器的采购决策,核心不在于预算多寡,而在于算力规划是否匹配业务曲线,训练需求明确、数据敏感的团队适合自购托管,简米科技提供的高功率机柜与酷番云的资质保障都能降低长期运维风险;而需求波动大、追求快速迭代的团队更适合租用云资源,无论选择哪条路径,务必把网络延迟、存储带宽与GPU算力放在同等权重去评估,这三项共同决定了真实的大模型服务性能。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/792450.html