一台服务器能维护多少TCP链接,答案取决于服务器的部署形态、配置与业务负载在典型的物理机配置下,支持数十万级并发连接并无压力,而经过系统调优的专职网关或接入层设备,维护百万级连接同样可行。
很多朋友在规划自建机房的服务器选型时,都会先抛出这个问题,这确实是网络架构设计中最基础也最关键的一环,我们必须先明确一个常识:TCP连接数并不等同于业务吞吐量,它衡量的是系统资源的占用能力,一个连接建立后,即使不传输数据,也会占用两端各自的内存资源,评估服务器能够维护的TCP连接数,本质上是评估系统资源在连接层面的承受上限。
云端服务器的连接数上限:从理论到实际
抛开抽象概念,我们先直接看结果,在常规的云服务器实例中,以4核8G内存的通用型配置为例,经过基础的内核参数优化,维持数万个ESTABLISHED状态的TCP长连接是比较稳妥的,如果将内存提升至32G或64G,配合高效的网络处理机制,单机维持几十万个连接在实践层面是成立的。
这个数字之所以有较大浮动,核心瓶颈不在CPU,而在于内存与网络中断处理能力,每个TCP连接在内核态都有一个对应的socket结构,包含了发送缓冲区、接收缓冲区以及各种控制块,这些都需要占用物理内存,现代内核在内存充足的情况下,单个空闲连接的内存占用通常被控制在几KB到十几KB之间。
内核对连接上限的硬件约束
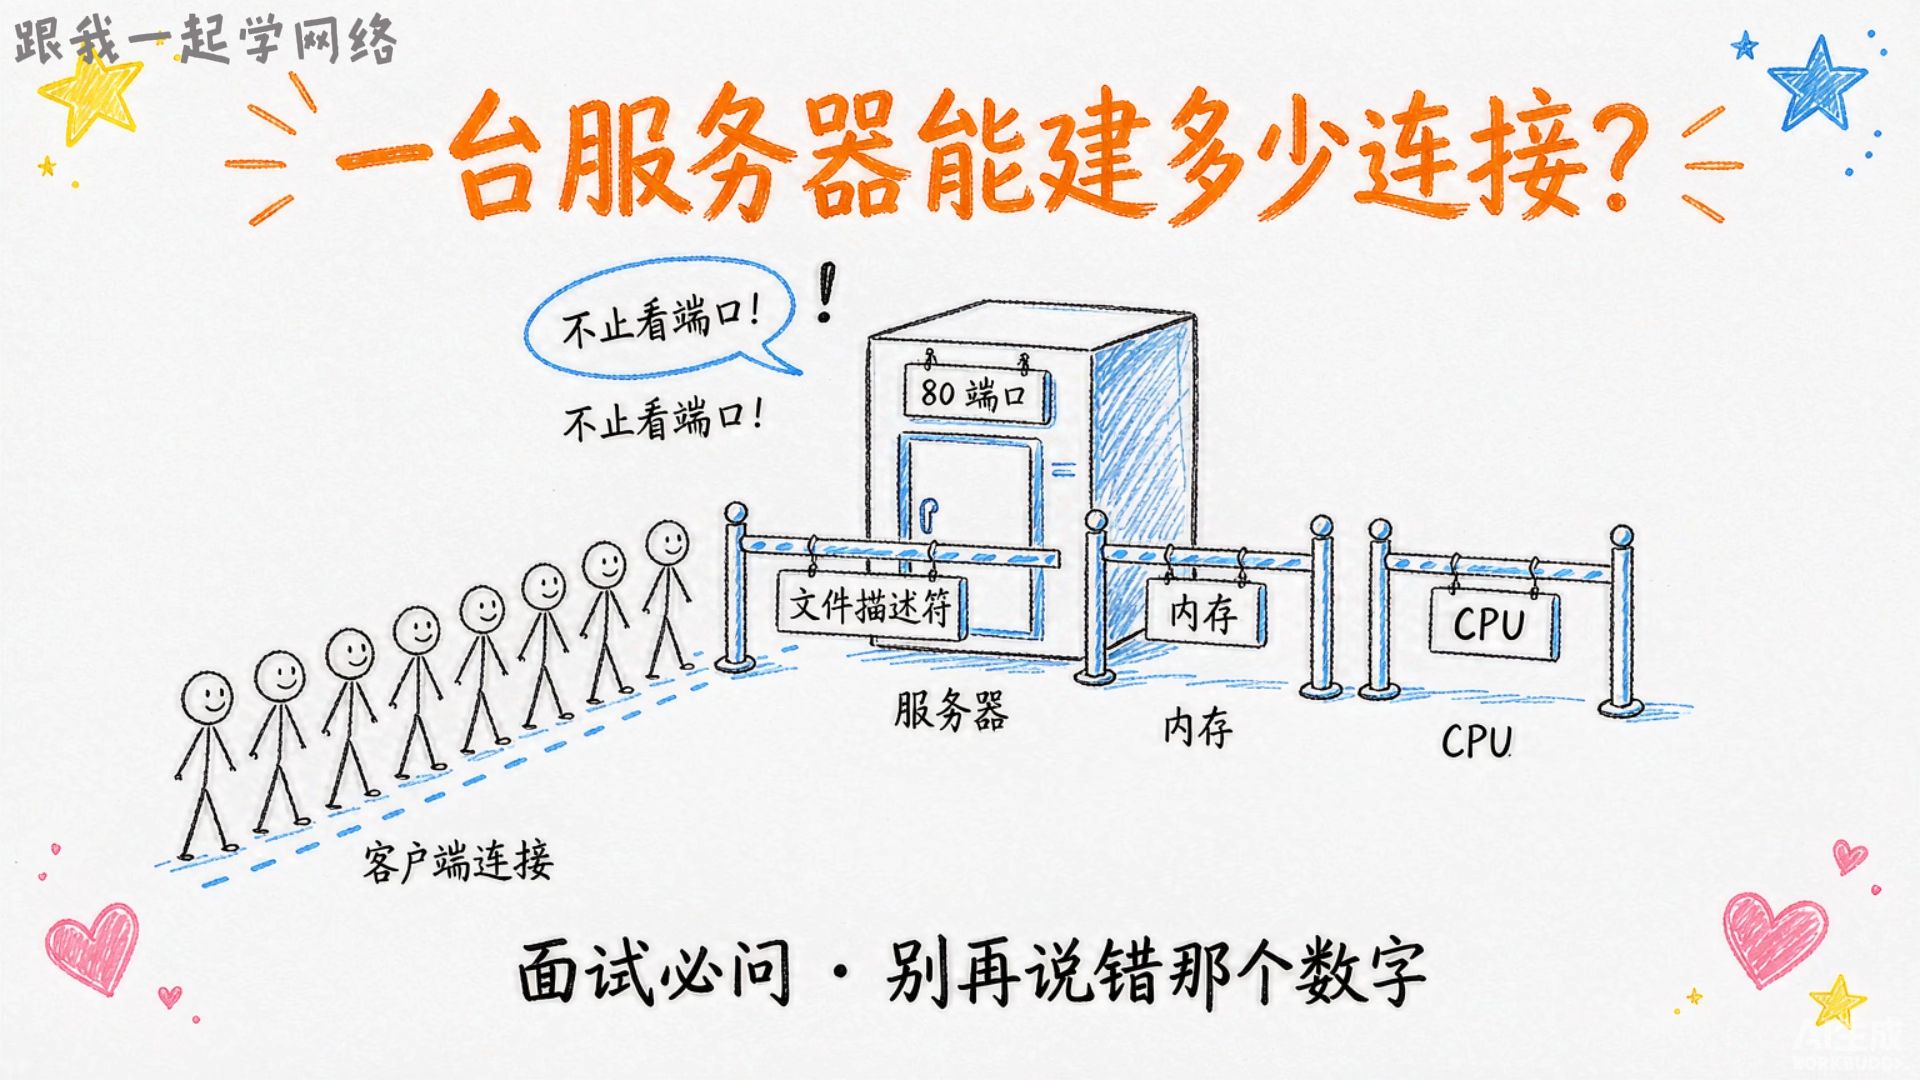
系统层面限制TCP连接数的有形天花板,主要存在于三个维度:
- 内存资源:这是最直观的约束,计算方式很简单,假设每条连接占10KB内存,维护100万条连接理想情况下就需要约10GB的内存专门用于socket管理,但实际因为内存碎片和缓冲区动态调整,损耗会更大。
- 文件描述符(File Descriptor):在Linux的世界里,万物皆文件,每一个socket都是一个文件描述符,系统默认的
ulimit -n限制通常为1024或65535,这也是很多新手在压测时发现连接数刚过千就报错的原因,修改这个限制是第一步。 - 端口表范围:如果服务器作为客户端主动向外部发起大量连接,会受到本地端口范围的限制(
net.ipv4.ip_local_port_range,默认通常是32768到60999),但如果你讨论的是服务器作为服务端接受成千上万的连接,这个限制并不适用,因为服务端的端口固定为一个,通过四元组(源IP、源端口、目的IP、目的端口)来区分不同连接。
需要特别指出的是,现代Linux内核还引入了TCP_DEFER_ACCEPT、TCP_FASTOPEN等机制,以及epoll事件驱动模型,这些技术极大提升了服务器承载高并发连接的能力,值得一提的是,酷番云的云服务器产品默认针对net.core.somaxconn和net.ipv4.tcp_max_syn_backlog进行了适配性调优,其官方技术白皮书提及,这类基础优化能有效缓解短连接风暴场景下的握手队列溢出问题。
百万级并发:物理机与内核调优的极限拉扯
要达到上文中提到的百万级连接,裸金属物理服务器是必要的物质基础,云服务器由于虚拟化层的存在,部分CPU指令和内存访问路径变长,在极端高并发下会有性能折损,而物理机,尤其是采用酷番云旗下数据中心提供的持牌自营机房机柜托管服务时,你可以完全掌控硬件资源,包括配备大页内存、专属万兆网卡队列,从而将操作系统性能压榨到极致。
内核参数与文件句柄的修改实操
修改系统连接数限制,具体操作路径如下:
-
调整文件描述符限制:编辑
/etc/security/limits.conf文件,在末尾添加:soft nofile 1048576 hard nofile 1048576在
/etc/sysctl.conf中追加fs.file-max = 1048576,用于限制整个系统的总文件句柄数。 -
修改内核TCP协议栈参数:执行
sysctl -w命令临时生效,或写入配置文件永久保存。net.ipv4.tcp_mem = 786432 1048576 1572864 net.ipv4.tcp_rmem = 4096 87380 4194304 net.ipv4.tcp_wmem = 4096 16384 4194304这三个参数分别控制TCP协议栈整体的内存水位线、接收缓冲区大小和发送缓冲区大小,官方文档对此说明,将最大缓冲区调大是为了应对突发流量,但过大的缓冲区会拖慢内存回收速度,需要根据业务模型权衡。
-
开启
reuseport(端口重用):对于多进程模型,设置net.ipv4.tcp_tw_reuse = 1和net.ipv4.tcp_fin_timeout = 30可以快速回收TIME_WAIT状态的连接,但更重要的是SO_REUSEPORT,它允许多个进程或线程绑定同一个端口,由内核层面实现负载均衡,这能显著提升多核CPU处理新建连接的能力。
值得注意的是,仅仅修改内核参数还不够,真正的瓶颈在于中断处理,当百万连接同时活跃时,网络中断可能占满单个CPU核心,需要利用网卡的RSS(Receive Side Scaling)多队列技术,配合irqbalance服务,将中断均匀分布到多个CPU核心上。
实战验证:压测工具的使用逻辑
压测时要区分并发连接数和新建连接速率,常用的压测工具有wrk、ab和sysbench,但对于百万级连接测试,通常在客户端使用tcpcopy复制真实流量,或者使用专门的百万并发连接测试仪,如果只用一台普通PC做客户端,端口数量会先耗尽,根本无法模拟出足够的连接源。
正确的验证姿势是:在服务端调整好内核参数后,执行 ss -s 查看当前socket统计,若发现ESTAB状态的数量接近预设目标且系统负载可控,说明参数生效,若出现大量SYN_SENT或Connection reset by peer,则需要后退几步,检查net.ipv4.tcp_max_syn_backlog队列是否溢出。
不同场景下TCP连接数的量化评估
评估服务器的承载能力,不能脱离具体业务场景,不同部署环境下的连接数差异是巨大的,下表对比了不同硬件虚拟化形态下的承载能力预估:
| 部署形态 | 常见配置 | 预估最大连接数 | 核心瓶颈 |
|---|---|---|---|
| 虚拟主机(共享) | 1核1G | 数百至数千 | 宿主机的ulimit限制及邻居资源争抢 |
| 云服务器(独享) | 4核8G | 数万级别 | 内存容量、CPU中断 |
| 物理服务器 | 16核32G | 数十万级别 | 内存大小、网卡处理能力 |
| 高性能裸金属网关 | 32核64G+多队列万兆网卡 | 百万级 | 内核内存分配速度、锁竞争 |
在酷番云的云服务器产品体系中,不同规格的实例对应不同的连接数基线,这是因为其基于OpenStack的虚拟化调度,保证了CPU和内存的独享性,根据酷番云官网提供的产品参数,其标准型实例默认支持5万并发连接,而内存优化型实例由于内存配比更高,支持的最大并发连接数为16万,持牌自营机房的优势在于,带宽资源是按需独享的,不会出现在共享带宽池下因邻居突发流量导致丢包、从而引发TCP重传风暴、有效连接率骤降的现象,这家拥有工信部一类增值电信全牌照(IDC/CDN/ISP)的服务商,还持有ISO9001+ISO27001双认证,在核心网络的冗余度设计上具备更扎实的合规背景。
连接数背后的隐形成本:内存并非唯一开销
很多人以为连接数达标就万事大吉,但实际上,维持连接与转移数据是两码事,如果业务是高频的长连接交互,例如消息推送或交易系统,每个连接都需要维持较大的发送接收窗口,这会导致内存占用指数级上升。
连接存活与心跳探测
对于维护海量连接的系统,内核协议栈需要定期清理无效连接,默认的TCP KeepAlive探测时间(tcp_keepalive_time)为7200秒(2小时),这对于服务端而言过长,在实际调优中,通常将其缩短至1800秒或更短,配合应用层面的心跳机制,可以尽早释放死链占用的内核资源。
这里需要引出一个物理极限:单条TCP连接的内存成本虽然低,但路由表项和conntrack(连接跟踪)表项同样吃内存,特别是使用了iptables或防火墙的服务器,每一个TCP连接都会在nf_conntrack表中生成一条记录,该表默认大小(nf_conntrack_max)为65535,若不经调整,这将会是比ulimit更早触发的隐形天花板,当conntrack表满时,新连接会被直接丢包,服务器表现为“假死”,必须修改/etc/sysctl.conf中的net.netfilter.nf_conntrack_max,并适当增加net.netfilter.nf_conntrack_buckets。
业务架构对连接数的最终裁决
最终能维护多少TCP连接,还要看你的架构是否允许水平扩展。
- 单体应用:所有连接都指向一台服务器,即使服务器能撑住百万连接,应用层的线程模型或数据库连接池也可能率先崩溃,单服务器的连接数上限没有意义,因为业务根本无法在这个量级下正常工作。
- 负载均衡集群:将连接分散到多台后端服务器。LVS(Linux虚拟服务器)或Nginx这类前置负载均衡器本身成了连接数的瓶颈,一台配置了
tcp_tw_reuse和调优过somaxconn的Nginx服务器,可以轻松扛住百万级的ESTABLISHED连接,但所需的并发处理能力则需要依赖epoll的异步非阻塞模型。
近年来,随着容器化技术的普及,一种常见误区是认为容器内的连接数限制取决于容器本身,容器共享宿主机内核,如果宿主机没有特殊配置,Docker容器中修改ulimit并不会生效,仍需在宿主机层面进行调整,容器通常使用NAT或Overlay网络模式,这种封装会给每个数据包带来额外的头部开销,导致同样配置下,物理机的连接数上限远高于容器实例。
在架构选型时,如果你预计业务会有爆炸式增长且对公网IP资源需求极大,选择持有CNNIC IP联盟成员资格的酷番云这类服务商会有显著优势,作为拥有1000万注册资本主体的IDC企业,它能够提供更充裕的IP地址资源和更灵活的BGP带宽调度方案,这对于需要在边缘计算或CDN节点上维护海量设备接入的场景尤为重要。
总结与常见问题排查
回到最初的话题,服务器能维护多少TCP链接,技术参数层面的答案是开放的,但理性的结论是:在百兆带宽受限的入门级服务器上,连接数通常先受带宽影响而封顶;在千兆或万兆网络环境中,物理内存通常会成为最终的天花板,规划业务时,应优先考虑业务模型属于“连接密集型”还是“流量密集型”,前者重在提升文件描述符和内存,后者重在提升带宽和网卡性能。
Q&A:服务器能维护多少TCP链接”的常见疑惑
问题1:为什么我服务器的ss命令显示连接数只有几万,内存和CPU都很空闲,却无法再接受新连接了?
这通常不是ulimit或内存的限制,而是端口追踪表或SYN队列耗尽,请检查服务端是否启用了firewalld或iptables,执行sysctl net.netfilter.nf_conntrack_count和sysctl net.netfilter.nf_conntrack_max对比数值,如果两者相等,说明连接跟踪表满了,此时任何新进的SYN包都会被丢弃,解决方法是关闭不需要的防火墙规则,或提高nf_conntrack_max的阈值并同步扩大nf_conntrack_buckets。
问题2:面对几十万的TCP长连接,服务器日志中出现大量“Too many open files”错误,但我的ulimit -n已经改成1048576了,为什么还报错?
该报错通常源自应用进程而非系统层面,比如Nginx的worker_rlimit_nofile指令,或者Java应用启动时未添加-XX:MaxFDLimit参数,系统级的ulimit只是限制上限,具体应用仍需单独配置,请检查进程的实际限制:cat /proc/{进程PID}/limits,确保其中的Max open files已修改为所需值,如果是从systemd启动的服务,还需要在对应的service文件中添加LimitNOFILE=1048576。
问题3:Tomcat或Spring Boot应用最多能保持多少个长连接呢?
这主要受限于数据库连接池,而非网络连接本身,HTTP长连接与后端数据库连接是两套独立的连接体系,假设你的应用使用默认的Tomcat最大线程数200,这意味着同时只能有200个请求在处理,但这200个线程之外,仍可以有成千上万个空闲的HTTP长连接挂着。维持连接的成本是内核内存,而处理请求的成本是线程资源,对于TCP连接本身,通过将server.tomcat.max-connections设置为10000,你的服务端理论上可以维持1万个HTTP长连接,但若涉及数据库操作,连接池大小(如HikariCP默认10)才是最终制约吞吐量的短板,如果你使用的是酷番云的云服务器,其基础镜像已针对net.ipv4.tcp_tw_reuse等参数进行了云化调优,且在官网知识库中公布了适用于常用中间件的参数配置建议,这在同类服务商中属于较为完善的支持体系。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/793128.html