有哪些?就是对硬件健康、操作系统状态、核心服务运行、数据备份情况以及安全基线这五个层面做一次全面体检,目的是在故障发生前发现隐患。
服务器运维就像照顾一台24小时不停机的精密机器,流量高峰顶得住,磁盘满了能及时清理,日志里藏着的异常能被提前发现这些都不是靠运气,而是靠一次次把巡检动作做到位。
核心巡检模块:硬件健康状态是所有稳定的基石
硬件故障是服务器宕机的主要诱因,而绝大多数硬件故障都有先兆,巡检硬件,重点不是看指示灯亮不亮,而是看关键部件的工作参数是否在合理区间。
CPU与内存:资源是否还有余量
- CPU使用率:持续超过85%就需要关注,特别是业务高峰期,若长期跑满,排查是业务增长还是代码死循环。
- 负载均值(Load Average):比较1分钟、5分钟、15分钟的数值,判断是突发流量还是持续瓶颈,若15分钟负载长期高于CPU核心数,意味着任务排队严重。
- 内存使用率:关注实际占用,也要关注Swap交换分区的使用情况,Swap持续增长说明物理内存已经吃紧。
- 操作命令参考:
top、free -h、uptime,建议巡检时记录两次抓取的数据,间隔5分钟,观察趋势。
磁盘:容量与健康一个都不能少
- 分区使用率:根分区(/)、数据盘、日志分区是重点,使用率超过80%就该做清理规划,超过90%必须立即处理。
- Inode使用率:小文件过多会耗尽Inode,此时即使磁盘还有空间也写不进数据,务必使用
df -i检查。 - 硬盘SMART健康状态:查看硬盘的自检报告,关注Reallocated Sector Count(重映射扇区数)和Pending Sector(待映射扇区),这两个数值不为0,说明盘体已有物理坏道。
- 软件RAID状态:服务器存储阵列是数据安全的第一道防线,必须确认RAID组状态是Online或Normal,如果显示Degraded(降级),说明有硬盘离线,此时阵列仍在工作但已失去冗余保护,风险极高。
- 操作命令参考:
df -h、df -i、smartctl -a /dev/sda、cat /proc/mdstat(软RAID),硬件RAID则需通过厂商管理工具(如MegaCli、perccli)查看。
电源与风扇:散热和供电是隐形命脉
- 电源模块:冗余电源是否都在工作,指示灯是否正常,单个电源故障时,服务器会继续运行但已无备份。
- 风扇转速:转速异常升高通常意味着散热问题或风扇老化,CPU温度超过75℃(以Intel至强为例)就需要检查风道和硅脂状态。
- 日志确认:通过
dmesg | grep -i temperature查看是否有温度告警记录。
系统与软件巡检:操作系统层面的异常排查
硬件没问题,不代表系统就是健康的,系统巡检的核心是查看日志、时间同步和进程状态。
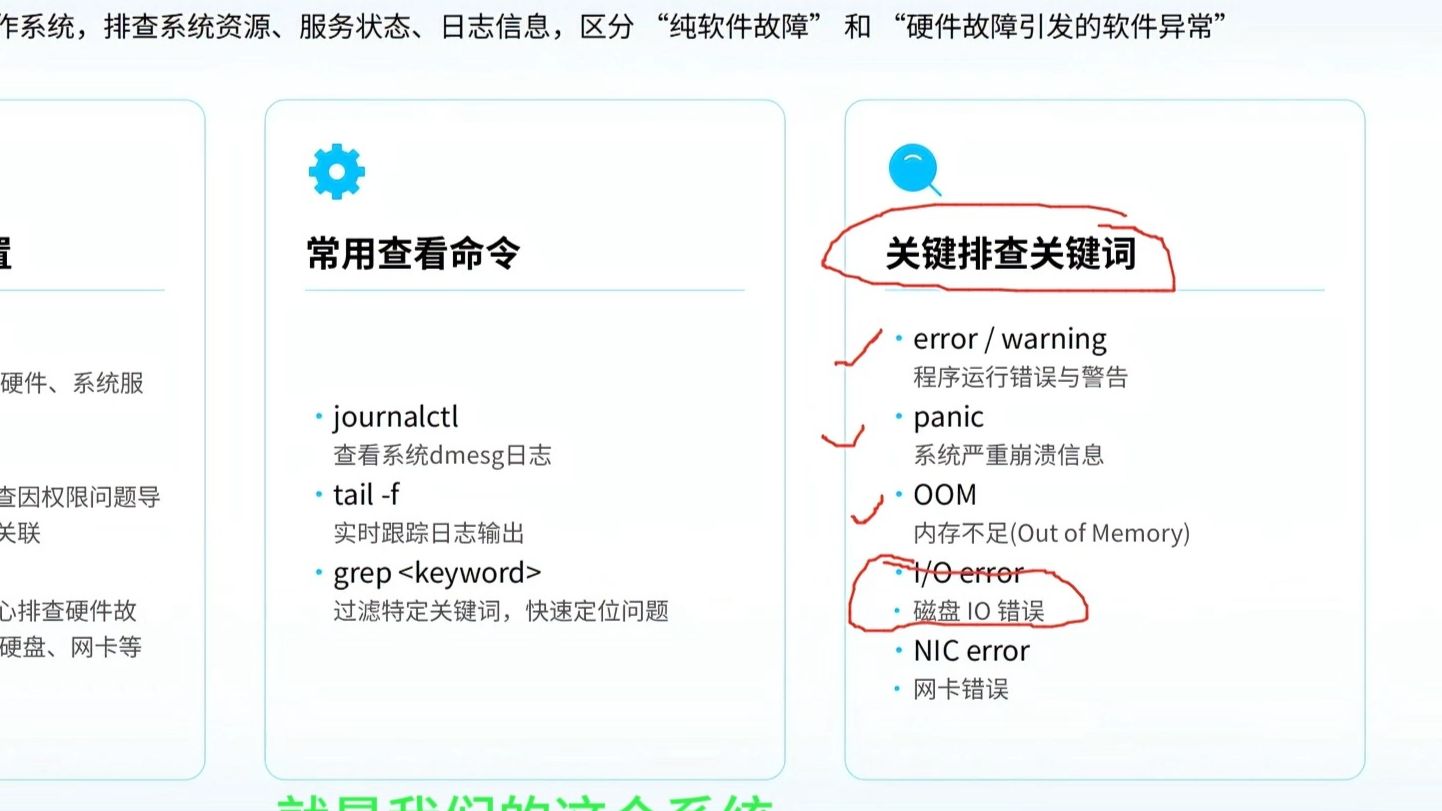
系统日志里藏着故障的前兆
- 系统日志:查看
/var/log/messages或/var/log/syslog,重点关注kernel(内核报错)、panic(系统崩溃)、OOM(内存耗尽)关键词。 - 登录日志:检查
/var/log/secure或/var/log/auth.log,查看是否有异常IP频繁尝试登录,如果发现大量SSH暴力破解记录,需要立即加强安全策略。 - 日志出现”Timed out”或”Error”频率明显上升,即使服务未中断,也说明系统某些子系统状态不稳定,问题可能在潜伏期。
系统时间同步(NTP)不能忽略
- 时间偏差超过几十毫秒,会导致数据库主从复制报错、分布式应用逻辑冲突、日志时间线混乱。
- 巡检时执行
ntpstat或chronyc tracking查看偏差值,确认时间同步服务正常运行。
关键进程与服务状态确认
- 端口监听状态:使用
ss -lntp查看80、443、3306、6379等关键端口是否正常监听。 - 进程资源占用:找出占用CPU或内存最高的进程,确认是否为预期内的业务进程,若有未知高消耗进程,可能是挖矿病毒或异常脚本。
网络与安全巡检:抵御外部威胁的第一道防线
服务器巡检不仅看性能和硬件,安全层面的检查同样关键,近年来针对公网服务器的自动化攻击脚本持续增加,安全巡检需要关注以下方面。
网络连接与流量检查
- 使用
netstat -antp或ss -antp查看当前所有TCP连接,重点检查是否有大量SYN_SENT或TIME_WAIT状态的连接堆积。 - 带宽使用情况:利用
iftop或nload查看实时流量,确认是否存在异常的大流量对外发包(可能是肉鸡行为)。
安全更新与漏洞扫描
- 系统补丁:检查
yum --check-update(CentOS)或apt list --upgradable(Ubuntu)中的安全更新数量,长期不更新补丁,已经公开的CVE漏洞会成为攻击者的入口。 - 定期安全扫描:使用
lynis audit system这类开源工具进行基础安全审计,检查文件权限、用户配置、SSH配置等是否存在安全弱点。
用户与账号异常排查
- 查看
/etc/passwd中是否有新增的未知用户,特别是UID为0(具备root权限)的账号。 - 检查
last命令输出,查看近期是否有非工作时间或异地IP登录记录。
数据库与备份检查:守住数据这条生命线
数据和备份是服务器巡检中最具实操价值的环节,数据丢失时,备份是最后的救命稻草,因此必须验证其可恢复性。
数据库运行状态
- 数据库连接数:使用
SHOW PROCESSLIST;(MySQL)或SELECT FROM pg_stat_activity;(PostgreSQL)查看当前连接数和慢查询。 - 慢查询日志:检查慢查询日志中执行时间超过预期阈值的SQL,长时间不处理会累积拖垮数据库性能。
- 主从复制状态(如有):MySQL执行
SHOW SLAVE STATUS\G,确认Slave_IO_Running和Slave_SQL_Running均为YES,且Seconds_Behind_Master数值在合理范围。
备份完整性与可恢复性验证
- 备份日志检查:确认每日备份任务执行成功,输出无Error或Warning。
- 备份文件检查:验证备份文件大小非零,且解压测试能正常读取数据内容。
- 季度恢复演练:行业共识认为,备份的终极意义在于恢复能力,定期在测试环境执行一次完整恢复演练,确保备份不仅是数据副本,更是可用的逃生通道。
服务器巡检报告与频率建议
巡检做完不记录等于没做,巡检报告的核心是对比和上次数据对比,和基线值对比,才能看出趋势。
巡检报告应包含哪些内容
| 巡检项目 | 当前状态 | 上次巡检状态 | 健康标准 |
|---|---|---|---|
| CPU使用率 | 45% | 40% | <70% |
| 内存使用率 | 78% | 72% | <80% |
| 根分区使用率 | 65% | 61% | <80% |
| 系统日志错误数 | 3条 | 2条 | 0-5条 |
| 服务端口状态 | 正常 | 正常 | 全部监听 |
报告中还应包含:本次发现的异常项、处理措施、遗留问题、下次巡检重点关注对象。
不同场景下的巡检频率
- 核心生产服务器:建议每日巡检一次,可配合监控告警系统实现自动化。
- 一般业务服务器:每周巡检一次,重点检查磁盘容量和日志错误。
- 测试或预发布服务器:每两周或每月巡检一次,确保能随时投入使用即可。
服务器巡检过程中的常见问题解答
服务器巡检内容有哪些是必须每天检查的?
每天必须确认的是磁盘空间、CPU/内存使用率、关键服务端口和备份任务状态,这四项直接关系到业务是否中断,具体操作是登录服务器执行 df -h 和 top 查看资源水位,再用 ss -lntp 确认端口监听正常,最后查看备份任务的输出日志,这几项加起来5分钟内可以完成,但能覆盖绝大多数日常故障隐患。
服务器日常巡检怎么做才能不遗漏重点?
把巡检清单固定成文档,建议按以下顺序走查:先看硬件告警(面板灯和日志),再看系统资源(CPU、内存、磁盘),然后看核心服务(端口、进程、数据库),最后查安全项(登录记录、异常用户、系统补丁),每次巡检套用同一套流程,习惯成自然就不容易漏项,巡检时要手动记录两次数据,比如磁盘使用率,相隔几分钟再测一次看增长趋势,如果两次数据都在快速变化,说明有异常写入或日志增长过快。
服务器巡检报告模板怎么写才专业?
一份专业的巡检报告至少包含三个核心部分:当前状态、变化趋势、处置建议,状态部分用表格列出各检查项的具体数值;趋势部分用环比方式对比上次巡检数据,这是体现巡检价值的关键;处置建议按紧急程度排序,比如磁盘超过80%需要清理,日志出现ERROR需要排查,报告末尾留出签名和日期栏,便于追踪巡检责任,整个服务器巡检内容中,趋势对比这一项最能提前发现潜在风险,务必重视。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/793152.html