大数据传输太慢,不一定是带宽不够,带宽只决定管道有多粗,而实际传输速度还受延迟、丢包、文件数量、协议开销和磁盘读写速度共同制约。把问题全部归咎于带宽,就像堵车时只怪马路不够宽,却忽略了红绿灯和司机的反应速度,下文将从判断方法、核心瓶颈、解决路径和常见误区四个层面,拆解这个让人头疼的问题。
如何判断大数据传输太慢是不是带宽问题
先做一道简单的算数题
判断是不是带宽的锅,核心公式只有一条:理论传输时间 = 数据量 ÷ 带宽,如果你要传500GB的数据,带宽是100Mbps(注意是兆比特每秒),那理论耗时就是500×8÷100=40秒?错,单位没换算清楚,500GB是500×1024MB,按字节算,100Mbps带宽实际每秒约12.5MB,算下来需要4小时。
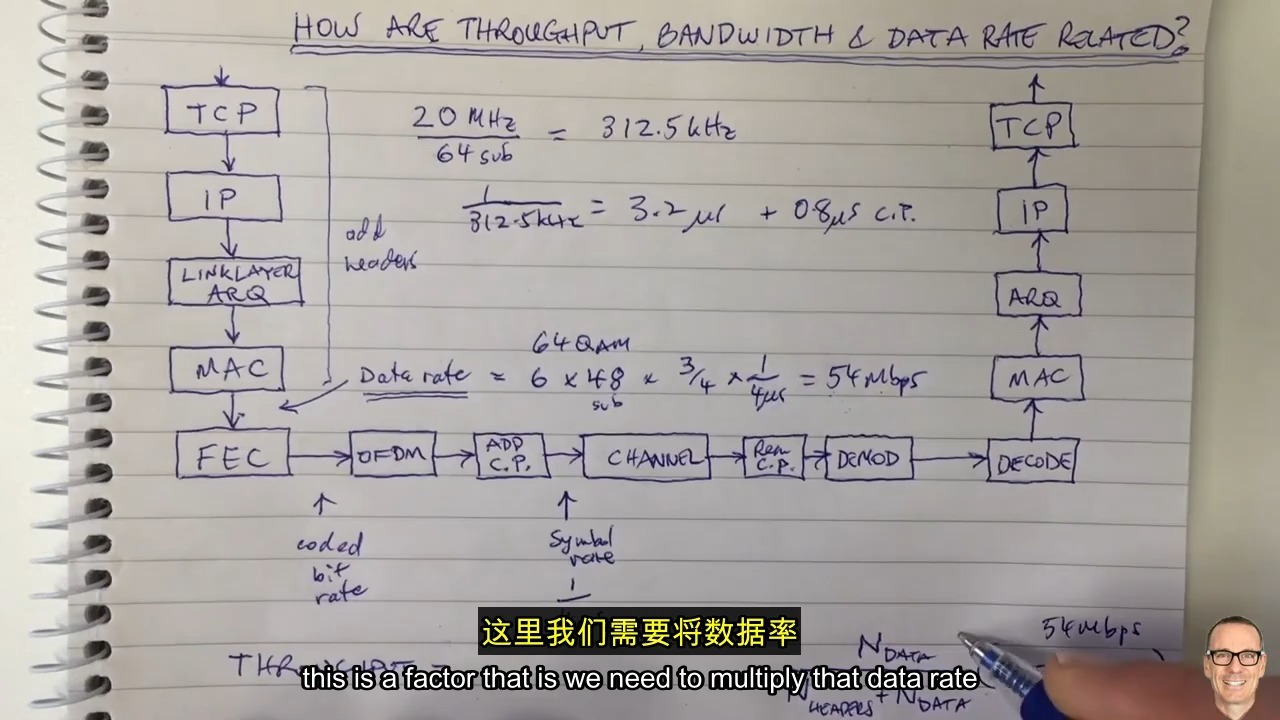
现在对照你的实际耗时:如果实际用时接近理论值,说明带宽确实用满了,慢是物理极限;如果实际用时是理论值的3倍、5倍甚至10倍,那带宽就不是主要矛盾,瓶颈在别处。
用排除法定位真正的瓶颈
- 在同一局域网内,用网线直连两台机器,通过共享文件夹拷贝一个大文件,如果速度能达到90MB/s以上(千兆网卡),说明基础网络没问题。
- 跨公网传输同一个文件,用专业传输工具对比系统自带复制,如果速度快了数倍,说明系统自带方式效率太低。
- 传输一万个1KB的小文件,对比传输一个1GB的大文件,如果小文件速度慢得离谱,问题出在文件数量和协议握手上,跟带宽无关。
业内专家指出,多数“传输慢”的投诉,在完成这三步排查后,真正带宽不够的案例不足三分之一。
大数据传输太慢的核心瓶颈不在带宽
延迟才是隐形杀手
带宽是“每秒能搬多少块砖”,延迟是“搬一块砖要花多少时间准备”,在长距离传输中,每次数据包的确认都要等一个往返时间,如果延迟是100毫秒,TCP协议下单个连接每秒最多只能完成约10次确认,无论带宽多大,单连接的实际吞吐量都被死死摁住。
打个比方:带宽是十车道高速,延迟是收费站只开一个窗口,车再多,也只能一辆一辆过,业界常用的解决方案是多连接并发,把数据拆成多个流同时传输,绕过单连接的延迟限制。
小文件数量多到可怕
一次传输包含100万个文件,每个文件都要经历“发起连接-确认-传输-结束”的过程。文件越多,握手次数越多,白白浪费的时间就越长,多数情况下,大量小文件的传输速度只有大文件的十分之一甚至更低。
NASA的公开资料显示,他们处理海量科学数据时,也会先把小文件打包成大文件再传输,这种思路在业内叫“小文件合并”。
磁盘读写速度拖后腿
传输工具读取数据的速度、写入目标磁盘的速度,是经常被忽视的瓶颈,服务器机械硬盘的持续读写通常在100-150MB/s,如果目标磁盘还在处理其他任务,实际可用速度会进一步下降,就算带宽有万兆,磁盘喂不饱,管道再粗也是白搭。
两套经典协议各有短板
- FTP:老当益壮但效率偏低,单线程传输,文件多时尤其吃力。
- HTTP:适合网页素材,断点续传机制不完善,大文件传输中断后从头再来。
相比之下,针对大数据传输场景设计的专业工具,会在协议层面做优化,比如用UDP替代TCP,牺牲少量可靠性换取数倍吞吐量。
大数据传输太慢怎么办
传输前先做减法
- 打包:把几万个小文件打成一个tar包或zip包,减少文件数量。
- 压缩:文本、日志类数据压缩率很高,压缩后再传输能大幅减少数据量,图片、视频类数据压缩率有限,不必强求。
- 增量:只传变化的部分,而非全量重传,rsync工具是不少运维的首选,支持增量同步。
选对工具很关键
普通场景下免费工具有限,但开源工具组合也能组合出不错的方案,比如用rsync加--partial参数支持断点续传,用iperf测试真实带宽,如果对速度有更高要求,主流云服务商提供的数据传输服务,走专线通道,速度和稳定性远胜公网,可有效缓解大数据传输太慢怎么办的困扰,当然这是付费服务。
调优系统参数
在Linux服务器上,以下几个参数的调整对提升吞吐量有明显帮助:
- TCP缓冲区:增大
net.core.wmem_max和net.core.rmem_max。 - 启用BBR拥塞控制算法:
sysctl -w net.core.default_qdisc=fq加上net.ipv4.tcp_congestion_control=bbr。 - 关闭防火墙卸载功能:部分场景下,网卡硬件校验和卸载会拖慢速度。
这些操作在多数云服务器上都能生效,具体效果因网络环境而异。
改变传输模式
公网传输大文件,尤其是跨国、跨地区场景,走BGP公网链路时,丢包和延迟往往难保障,常听到的说法是,CN2 GIA与普通163骨干网在晚高峰时的表现有明显差异,如果你的业务涉及海外传输,预算允许的情况下,可以考虑CN2 GIA线路的云服务器或专线接入。
实体专线费用较高,初创公司或中小团队可以先对比国际BGP线路的性价比,也可以采用中转机+加速工具的方案,成本低一些,效果凑合。
大数据传输太慢和带宽的关系:不同场景对症下药
同城跨机房传输
物理距离短,延迟低,如果速度依然上不去,先查防火墙规则和路由跳数,本地传输绕了远路,属于常见的低级失误,排查方法是使用traceroute查看路径,如果跳数超过10跳,大概率路径选择有问题。
跨国传输场景
跨国传输是最典型的“延迟+丢包”双重困境,物理距离决定了光速极限,延迟无法改变,能改变的是丢包率。国际线路优化的核心思路是在传输层做文章,而非盲目升级带宽,专线带宽和普通宽带区别在于,专线提供的是独享、稳定的链路质量,普通宽带是共享的,晚高峰拥堵明显。
云计算场景下的大数据迁移
从本地向云上迁移数据,除了走公网,还有更快的选择:离线迁移服务,把硬盘寄给云服务商,由他们代传数据,这类服务的本质是用物理运输绕过网络瓶颈,速度取决于快递有多快,简米云、酷番云、AWS都有类似服务,名称不同但原理相似。
关于大数据传输太慢和带宽不足的常见问题
问:为什么带宽升级了,传输速度没有明显变快?
答:带宽只是上限,不是实际速度,实际速度受限于延迟、丢包、磁盘I/O和协议效率,如果原来的瓶颈不在带宽,升级自然无感,建议先实测当前链路的最大吞吐量,确认带宽利用率已经接近100%再考虑升级,不然往往是白花钱。
问:用网盘传输大文件为什么会中途失败?
答:网盘的核心定位是存储和分享,不是高强度数据传输,浏览器上传走HTTP协议,断点续传机制不完善,浏览器本身对内存和连接数也有限制,传输重要大数据时,更推荐使用支持断点续传的专业传输工具,或干脆用命令行工具配合脚本实现分段上传。
问:买多少带宽够用?
答:没有一个数字能通吃所有场景,先估算你有多少数据、希望多久传完,反推带宽需求,公式是带宽(Mbps)≈ 数据量(GB)×8÷期望时间(秒),然后留出30%的余量,注意这是理论值,实际还要压缩、打包、避开高峰时段。
写在最后
大数据传输慢,带宽不足只是可能性之一,而且往往不是主要因素。先测,再判,后调,用排除法找到真正的瓶颈,才是解决问题的有效路径,大多数场景下,优化传输工具、调整参数、改变传输模式带来的速度提升,远比单纯增加带宽更明显。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/793422.html