AI服务器不是一台普通的电脑,它是一台为大规模并行计算而生的“算力工厂”,核心包括GPU/AI加速卡、CPU、高带宽内存、高速存储、高速网络和专用散热供电系统六大模块。无论你是在规划企业AI项目,还是准备采购第一台训练设备,搞清楚这些组成部分,才能选对配置、控住预算。
AI服务器硬件组成:六大核心模块一个都不能少
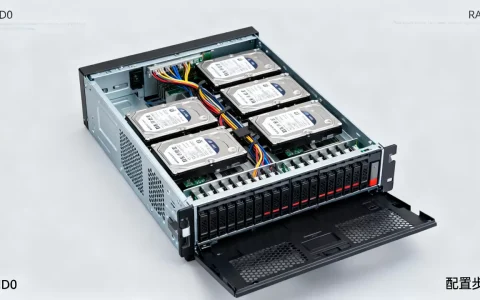
很多人把AI服务器理解成“插了几块显卡的电脑”,这个说法只对了一小半,行业共识认为,AI服务器的设计逻辑跟通用服务器完全不同,它围绕“数据吞吐”和“并行计算”做文章,拆开任何一台主流AI服务器,你都会看到下面这些模块。
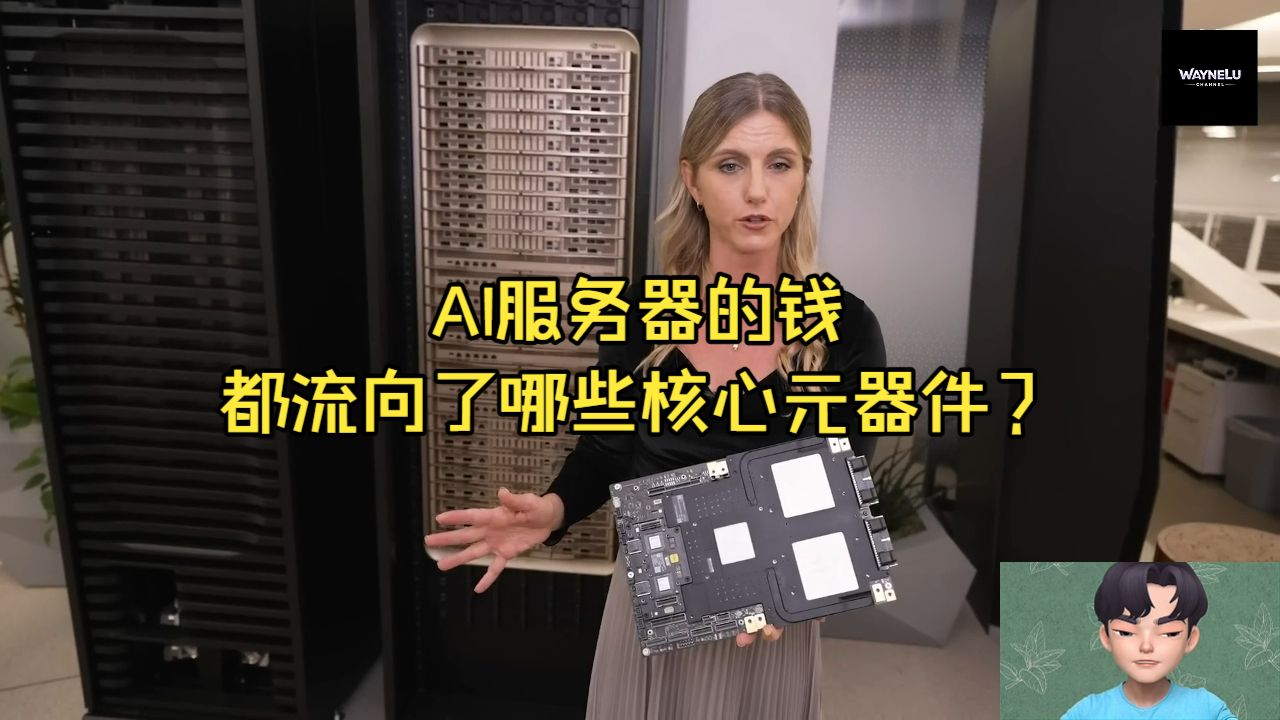
GPU/AI加速卡:算力的绝对主力
AI训练和推理的任务本质是海量矩阵运算,GPU的并行计算架构正好对此非常擅长,目前市面上主流的加速卡包括NVIDIA的A100、H100、H200系列,以及AMD的MI300系列,还有国内厂商如华为昇腾、寒武纪等推出的产品。
选择加速卡时,你需要关注几个参数:
- 显存容量:决定了单卡能装下多大的模型,H100有80GB,处理大语言模型通常需要80GB以上
- NVLink/互联带宽:多卡通信要快,否则并行效率会打折扣
- 计算精度:FP16、BF16、FP8等格式的运行速度各有不同
一张H100在FP16精度下的算力接近1000 TFLOPS,对比CPU的几十GFLOPS,效率差距不是一点半点,如果你做的是大模型训练,GPU这块的投入通常能占到整机成本的70%-80%。
CPU与主板:系统的“指挥官”与“骨架”
CPU在AI服务器里负责调度任务、数据预处理和IO操作,不算计算主力,但选错了会拖累整体性能,目前主流AI服务器采用双路英特尔至强或AMD EPYC处理器,核心数量越多越好,PCIe通道数也要够多,否则插不满8块GPU。
主板方面,AI服务器通常采用双路大板设计方案,提供8到16个PCIe Gen5 x16插槽,专门为GPU和高速网卡预留空间,如果你决定自己组装一台AI服务器,CPU选二路64核以上是比较稳妥的起点。
内存与存储:喂饱GPU的“数据粮仓”
训练大模型时,数据搬运的速度直接决定GPU有没有“活”干,内存方面,AI服务器的容量通常要求512GB起步,1TB到2TB是常见配置,需要足够的内存带宽来支持CPU-GPU间的数据流。
存储则分两个层级:
- 系统盘:装操作系统和软件,通常用1.92TB或3.84TB的NVMe SSD
- 数据盘:存放训练数据集和模型权重,建议采用NVMe SSD组成的阵列,容量根据你的业务需求,从15TB到上百TB不等
存储读写速度不过关,就会出现GPU空转等待数据的情况,这在实际运维中非常让人头疼。
高速网络:集群的“神经系统”
单台8卡AI服务器训练大模型,速度可能不够看,这时就需要多台服务器组成集群,集群内节点通信依赖高速网络,目前的标配是400Gbps InfiniBand或RoCE网络,并配备专门的智能网卡和交换机。
如果你只是做小规模推理或个人学习,单机也能跑,但只要有扩展需求,网络模块绝对不能省,否则集群规模大了以后通信延迟就会成为瓶颈。
散热与供电:稳定运行的“护身符”
一台8卡AI服务器满载功耗很容易突破10kW,普通风冷散热方案往往压不住,现在主流的数据中心都会考虑液冷方案,或者要求机柜功率密度至少10kW起步,供电方面,AI服务器采用冗余电源设计,常见的是4颗3000W或3200W钛金级电源模块。
选购时你可以根据机房的电力条件来定方案,自建机房建议直接预留液冷和高压直流供电的改造空间,租用第三方IDC机柜时则要提前确认单机柜供电能力是否达到要求。
AI服务器和普通服务器的区别,核心不在CPU
要理解AI服务器的构成,最好的方式就是对比传统服务器,这个对比也经常出现在采购决策中。
AI服务器和普通服务器的区别是什么
| 对比维度 | 传统服务器 | AI服务器 |
|---|---|---|
| 核心硬件 | CPU | GPU/AI加速卡 |
| 系统架构 | 通用计算优化 | 异构计算,CPU+GPU协同 |
| 功耗密度 | 单机1-2kW | 单机8-12kW以上 |
| 网络要求 | 万兆网卡足够 | 400G InfiniBand或RoCE |
| 适用场景 | 数据库、Web服务、ERP | 模型训练、推理、科学计算 |
| 采购成本 | 中低 | 昂贵,GPU占大头 |
传统服务器看CPU主频和核心数,AI服务器则看GPU总算力和卡间互联带宽。行业内有个简单判断方法:当服务器的GPU成本超过整机一半,它本质上就是一台AI服务器。
AI服务器配置清单与价格由什么决定
搜索AI服务器配置清单时你会发现,各家方案差异极大,价格从二十万到两百万都有可能,关键就在下面几个变量里。
AI服务器租用价格为什么差别这么大
价格的主要分水岭来自这几部分:
- 加速卡型号差异:A100单卡就比RTX 4090贵数倍,H100更是价格不菲
- 加速卡数量:单卡、4卡、8卡甚至整机柜方案,成本呈阶梯式上升
- 存储与内存容量:大模型训练推荐1TB内存起步,这一项的投入就能差出大几万
- 网络方案:InfiniBand比普通万兆以太网贵不少,却是集群训练的必要投入
如果你预算有限但又要在本地跑模型,可以考虑先租用云GPU服务器,按小时计费,省下一次性硬件投入,统计显示,多数AI创业团队早期更倾向GPU云服务,等跑通业务后再转向自建采购。
AI服务器品牌怎么选:一手整机还是自己组装
市面上的AI服务器主要分三类:国际大厂整机、国内整机品牌和DIY组装机,它们各自有不同的适用场景。
国外品牌AI服务器怎么选配置
戴尔、惠普、超微这些国际品牌的整机方案稳定可靠,售后和认证齐全,适合对稳定性要求高的大型企业,超微的GPU服务器在AI圈里接受度较高,拥有多款4U/8U机架式方案。
选择国外品牌时,你需要关注:
- GPU底座设计:散热风道是否合理,能否支持最新的H100或A100
- 扩展能力:是否预留了额外的PCIe插槽和存储空间
- 出厂预装系统:是否支持主流的Ubuntu和CUDA版本
戴尔PowerEdge XE9680是一款支持8块GPU的4U机型,很多企业把它作为大模型训练的主力设备,这一代产品在市场上认可度较高。
国内品牌AI服务器怎么选配置
国内品牌的性价比通常更友好,浪潮、新华三、曙光都有专门的AI服务器产品线,这些品牌在电信运营商和政企市场占有率较高。
国产方案的最大优势是可以灵活配置昇腾等国产加速卡,满足自主可控的合规要求,需要注意的是,国产AI生态相对封闭,PyTorch框架的适配可能比英伟达平台晚一些,购买前建议先确认核心模型框架的兼容性。
自己组装AI服务器的实用建议
DIY方案的核心价值是把预算尽可能花在GPU上,以一台4卡RTX 4090训练服务器为例,CPU用AMD EPYC 9354或者英特尔至强铂金8458P,主板用支持PCIe Gen5的双路大板,内存上满512GB DDR5 ECC,电源用2000W起步、支持多卡时序的服务器电源。
供电方面建议每张GPU至少预留600W的供电余量,风扇转速和散热风道也要提前规划好,软件层面需要自行安装好NVIDIA驱动、CUDA工具包和cuDNN,然后用nvidia-smi指令检查GPU状态是否正常。
常见问题快速解答
我该先买AI服务器还是先租云GPU?
如果你处于模型开发验证阶段,数据规模和并发量还不稳定,租用云GPU成本更低,灵活性也更好,按小时计费的方式可以快速试错,如果你的业务已经稳定、GPU长期占用率高于60%,自建服务器摊薄成本可能更划算,但需要额外考虑机房电力和散热条件。
大语言模型本地部署需要几块GPU?
7B-13B参数量模型量化推理通常需要1-2块24GB显存的GPU,70B以上的模型需要2-4块80GB显存的A100/H100,训练场景另当别论,通常需要8块GPU起步,具体取决于数据量和训练策略。
AI服务器功耗过高有什么解决思路?
液冷是当前规模部署的最佳选择,冷板式液冷可以将PUE降至1.2以下,容量不足的小机房建议先评估机柜供电上限,必要时混合使用风冷和液冷方案,同时可以用功耗墙设置限制GPU最大功耗来降低散热压力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/795161.html