存储超大服务器并非某一款具体机型,而是一套围绕容量、带宽与可靠性设计的硬件与架构组合,主流方案集中在高密度盘位机架式服务器、分布式存储一体机和面向AI场景的NVMe全闪节点三大类。如果你正在为海量数据找“落脚点”,先记住一个判断顺序:先定数据规模和读写模式,再定架构形态,最后才选品牌和型号,下面按这个顺序把方案、选型、价格和地域差异讲清楚。
存储超大服务器的三大主流形态
业内习惯把“超大存储服务器”拆成硬件层和架构层两层来看,硬件层解决“能装多少盘、跑多快”,架构层解决“数据怎么分布、坏了怎么恢复”,两者匹配错了,钱花得再多也白搭。
硬件层:高密度盘位机架式是容量担当
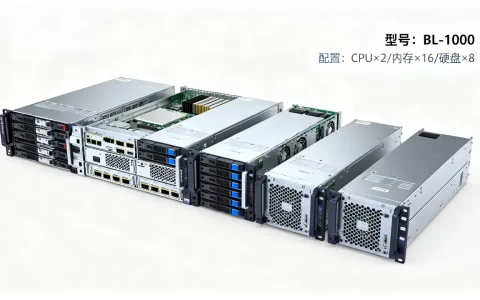
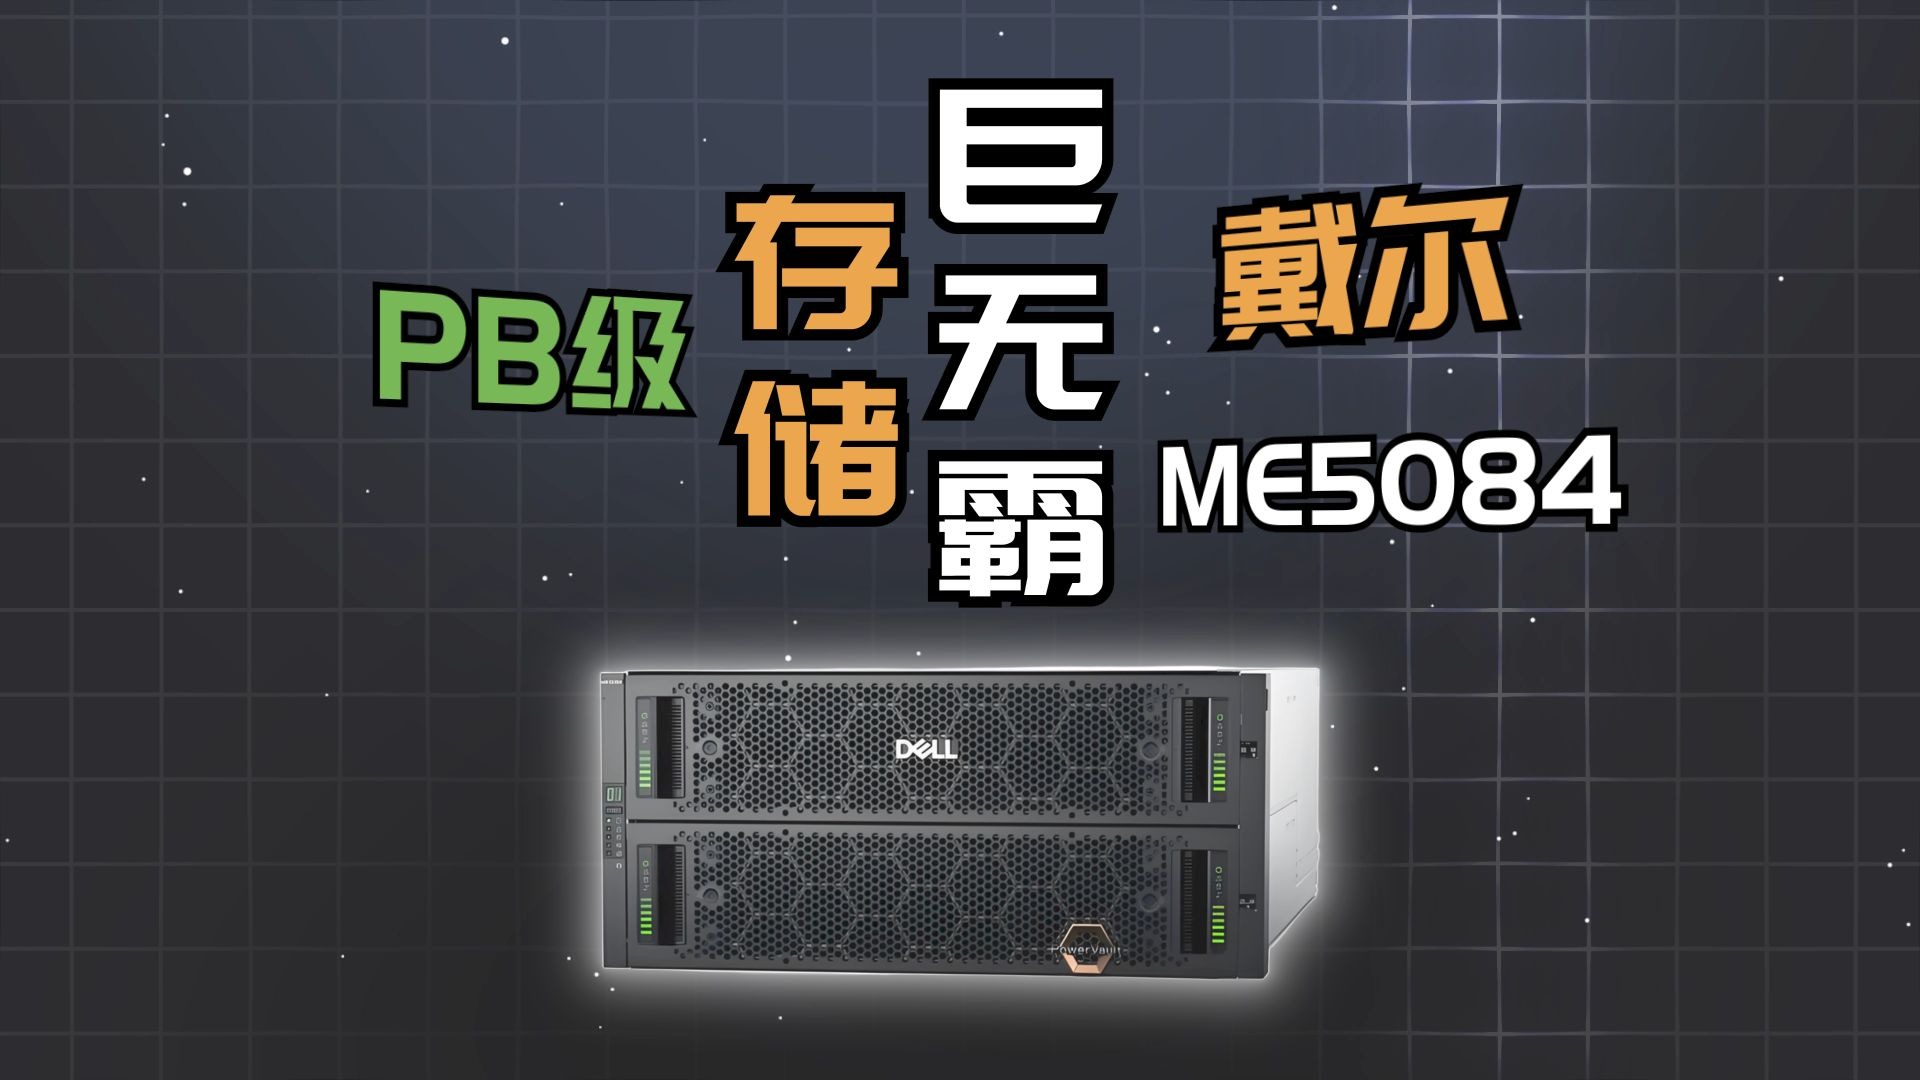
这是最直观的一类“大存储服务器”,常见形态是4U机箱塞进60至90个3.5英寸盘位,单机裸容量可达1PB级别,2026年前后主流厂商陆续推出第二代高密度机型,盘位密度和散热设计都有改进,典型用途是冷数据归档、视频监控存储和备份池。
选这类机器要看三个硬指标:
- 盘位密度与背板带宽:盘多不等于带宽够,SAS背板扩展器数量决定单机实际吞吐上限
- 电源与散热冗余:满盘满载功耗可观,双电源和风道设计不到位会直接限制可用盘数
- 管理接口:IPMI或带外管理是否支持批量盘位监控,直接影响后期运维成本
架构层:分布式与超融合是规模担当
单机盘位再密也有天花板,真正“超大”要靠横向扩展,分布式存储把多台服务器组成统一命名空间,容量和性能随节点线性增长,是云平台和大数据集群的常见底座。
行业共识认为,单集群可用容量达到数PB以上时,分布式架构的性价比通常优于继续堆单机,但前提是网络跟得上:万兆起步、25G或100G更稳妥,否则节点间数据重建会拖垮前端业务。
场景层:NVMe全闪节点专治高并发
AI训练、实时风控、高频交易这类场景,要的不是容量而是IOPS和低延迟,全闪存储节点通常配置24至48个NVMe盘位,单节点随机读性能可达数百万IOPS量级,价格敏感的业务要算清楚:全闪每TB成本仍是机械盘的数倍,只放热数据,冷数据沉到大容量机械节点。
存储超大服务器怎么选:五个维度对号入座
“存储超大服务器怎么选”是搜索量最集中的问题,本质是把业务需求翻译成硬件参数,按下面五个维度逐项打分,基本不会跑偏。
容量规划要留出重建余量
可用容量不等于裸容量,以常见的纠删码或双副本策略计算,有效容量通常只有裸容量的五成到七成,规划时按三年数据增长预留空间,同时给数据重建留出至少一个节点的余量,否则单节点故障后集群会进入高风险状态。
读写模式决定介质配比
- 顺序大文件写入为主:机械盘+少量SSD做缓存层即可
- 随机小IO密集:NVMe或SATA SSD为主,机械盘只做归档
- 混合负载:分层存储,热数据全闪、温数据机械、冷数据磁带或大容量归档
实际操作中可以先跑一个基准测试再下单,Linux下用fio模拟业务IO模型,例如随机读测试:
fio --name=randread --ioengine=libaio --direct=1 --rw=randread --bs=4k --numjobs=8 --size=10G --runtime=60 --group_reporting
测出来的IOPS和延迟,比厂商彩页上的峰值数据更接近真实表现。
网络与协议别成瓶颈
分布式存储节点间通常走RDMA或NVMe-oF,前端业务走NFS、SMB或S3对象接口,如果前端还是千兆网络,后端再快也体现不出来,实操路径是先确认业务侧协议,再倒推网络配置,别反过来。
可靠性与运维成本
盘多故障率就高,这是概率问题不是质量问题,关键看两点:是否支持热插拔更换,以及重建速度是否可控,大容量机械盘单盘重建动辄十几小时,盘位越密重建压力越大,选型时问清楚厂商的重建限速和优先级策略。
扩展路径要提前想好
买的时候就要想第二年加节点怎么加、加盘怎么加,分布式方案要确认新节点加入是否自动重平衡,单机方案要确认背板和控制器是否支持后续扩盘,扩展路径不清晰的方案,后期往往只能整机替换。
存储超大服务器价格对比:钱花在哪
“存储超大服务器价格”没有统一答案,但成本结构是清晰的,整机价格主要由盘位密度、控制器规格、介质配比和品牌溢价四块构成,按近年来市场行情粗略划分:
| 方案类型 | 裸容量量级 | 成本特征 | 适用场景 |
|---|---|---|---|
| 高密度机械盘机架式 | 数百TB至1PB级 | 每TB成本较低,整机价格随盘位和盘数上升 | 归档、备份、监控 |
| 分布式存储节点集群 | 数PB起 | 初始投入较高,扩容边际成本递减 | 云平台、大数据 |
| NVMe全闪节点 | 数十至数百TB | 每TB成本明显偏高,性能溢价大 | AI、实时业务 |
需要提醒的是,相当一部分采购预算实际花在了配套上:交换机、机柜、UPS、运维软件授权,只比整机报价容易低估总拥有成本,价格谈判时把三年维保和扩容报价一起要,横向对比才有意义。
国内存储超大服务器选购的地域与品牌差异
国内用户搜“存储超大服务器”时,地域因素往往被忽略,但实际影响不小,国产厂商在本地服务响应和信创适配上有优势,国际品牌在特定行业生态里积累较深,近年来国产整机和分布式存储方案在政务、金融、运营商领域落地较多,备件响应周期通常更短。
地域差异主要体现在交付和运维上:一线城市周边有厂商备件库,故障响应通常按小时计;偏远地区项目要提前确认备件调拨周期和现场工程师覆盖情况,采购合同里把响应时效写清楚,比只看品牌名更实在。
另一个实操建议是:机柜承重和供电要先算,满配高密度存储服务器单机重量可达上百公斤,普通机柜未必扛得住;满盘功耗也远超一般业务服务器,机房配电和制冷要提前评估,这一步做不好,设备到货也上不了架。
部署与运维的关键动作
设备到位只是开始,几个动作决定后期是否省心:
- 上架前完成固件和带外管理统一配置,批量操作比逐台折腾效率高得多
- 存储池划分按业务隔离,避免单一池故障影响全部业务
- 监控重点盯盘健康度、重建进度和网络丢包,这三项出问题往往连锁反应
- 定期做恢复演练,备份没验证过等于没有备份
对于分布式方案,节点加入和退出要按厂商推荐流程走,手动干预容易触发非预期重平衡,命令行操作前先在测试环境验证,生产环境改配置留好回滚路径。
说到底,存储超大服务器的选型逻辑是需求先行、架构匹配、成本算全,而不是追某一个参数或品牌。容量、性能、可靠性三者不可能同时最优,想清楚业务最不能妥协的是哪一项,答案自然就出来了。
存储超大服务器常见问题Q&A
存储超大服务器和普通服务器加硬盘有什么区别?
普通服务器通常只有几个到十几个盘位,扩展能力和背板带宽有限,适合一般业务数据,存储超大服务器在盘位密度、背板通道、电源散热和管理接口上按海量数据设计,单机可承载的容量和吞吐高出一个量级,本质上不是“多插几块盘”的事,而是整机架构围绕存储负载做了取舍。
预算有限时,存储超大服务器怎么选更划算?
优先保证容量底座和网络不拖后腿,性能层按热数据比例配置,多数情况下,机械盘为主、少量SSD做缓存的分层方案,总拥有成本低于全闪方案,扩容路径清晰的分布式节点集群,也比一次性买满单机更灵活,前提是重建余量和维保范围别省,这两项省下来的钱后期往往加倍还回去。
分布式存储和单机高密度方案哪个更适合海量数据场景?
单机高密度方案部署简单、每TB成本较低,适合容量需求明确且增长平缓的场景,比如归档和监控,分布式方案初始投入更高,但容量和性能可随节点扩展,适合数据持续增长、对可用性要求高的业务,行业实践中,数PB以上的活跃数据集群多倾向分布式架构,而冷数据归档仍大量使用高密度单机,两者并不互斥,分层组合是常见做法。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/796864.html