小型Web服务器用JMeter压多少并发才合理
先给结论:一台1核2G的小型Web服务器,静态页面用JMeter压50到200并发比较有参考价值,动态接口从20到50并发起步逐步往上加;2核4G的机器静态能试200到500并发,动态接口100到200并发,真正判断”压多少”的不是拍脑袋定一个线程数,而是找到TPS不再上涨、响应时间开始陡增的那个拐点。
很多人一上来就问”我这台机器能扛多少并发”,其实这个问题问反了,压测的目的不是证明服务器能扛住某个数字,而是找出它在什么压力下开始掉链子,所以下面的内容按”先定基线、再设参数、最后找拐点”的顺序展开。
先分清三个容易混的概念
并发数、TPS、响应时间不是一回事
JMeter里的”线程数”只代表同时发起请求的虚拟用户数量,它既不等于真实在线人数,也不等于服务器每秒能处理的请求数。
- 并发线程数:JMeter同时开多少个线程发请求
- TPS/QPS:服务端每秒实际成功处理的请求数
- 响应时间:从发请求到收到完整响应的耗时,通常看90%或95%分位
一台机器TPS上不去,可能是CPU满了,也可能是数据库连接池只有10个、带宽只有1M、Nginx的worker_connections设得太小,光看线程数没有任何意义。
小型服务器的定义边界
本文说的小型Web服务器,指1核到4核、1G到8G内存、1M到10M带宽的云服务器或物理机,跑Nginx、Apache加PHP、Node.js、Python后端这类典型中小站点,这个规格段也是个人站、企业官网、小型SaaS后台最常见的配置。
JMeter自身也会成为瓶颈
单机JMeter在非GUI模式下压几千个线程时,往往会先把自己压垮端口耗尽、堆内存不够、CPU飙满,经验做法是:单台压测机控制在500到1000线程以内,超过就上分布式压测(master加多台slave),否则测出来的数据是压测机的数据,不是服务器的数据。
不同配置的压测基线参考
以下区间来自业内普遍的经验值和常见的公开压测案例,具体数字会因代码质量、SQL、缓存策略差异很大,只能当起点用,不能当结论用。
| 服务器配置 | 典型场景 | 建议起始并发 | 可能的拐点区间 | 主要瓶颈 |
|---|---|---|---|---|
| 1核1G | 纯静态HTML/图片 | 50 | 150到300 | CPU、带宽 |
| 1核2G | Nginx静态加反向代理 | 50到100 | 200到400 | 带宽、连接数 |
| 2核4G | PHP/Node动态页 | 50到100 | 150到300 | PHP-FPM进程数、MySQL连接 |
| 2核4G | 静态资源为主 | 100到200 | 300到600 | 网卡带宽 |
| 4核8G | 动态接口加Redis缓存 | 100到200 | 400到800 | 数据库、锁竞争 |
| 4核8G | 纯API返回JSON | 200到400 | 800到1500 | 网络栈、JMeter自身 |
看到这里应该明白一件事:静态资源和动态接口的差距是数量级的,一个返回几十字节JSON的接口和一个查三次数据库再渲染模板的页面,能承受的并发完全不在一个层面,所以压测前先给自己的接口分个类,静态、缓存命中、缓存未命中、写操作,分开压。
JMeter压测参数怎么设才靠谱
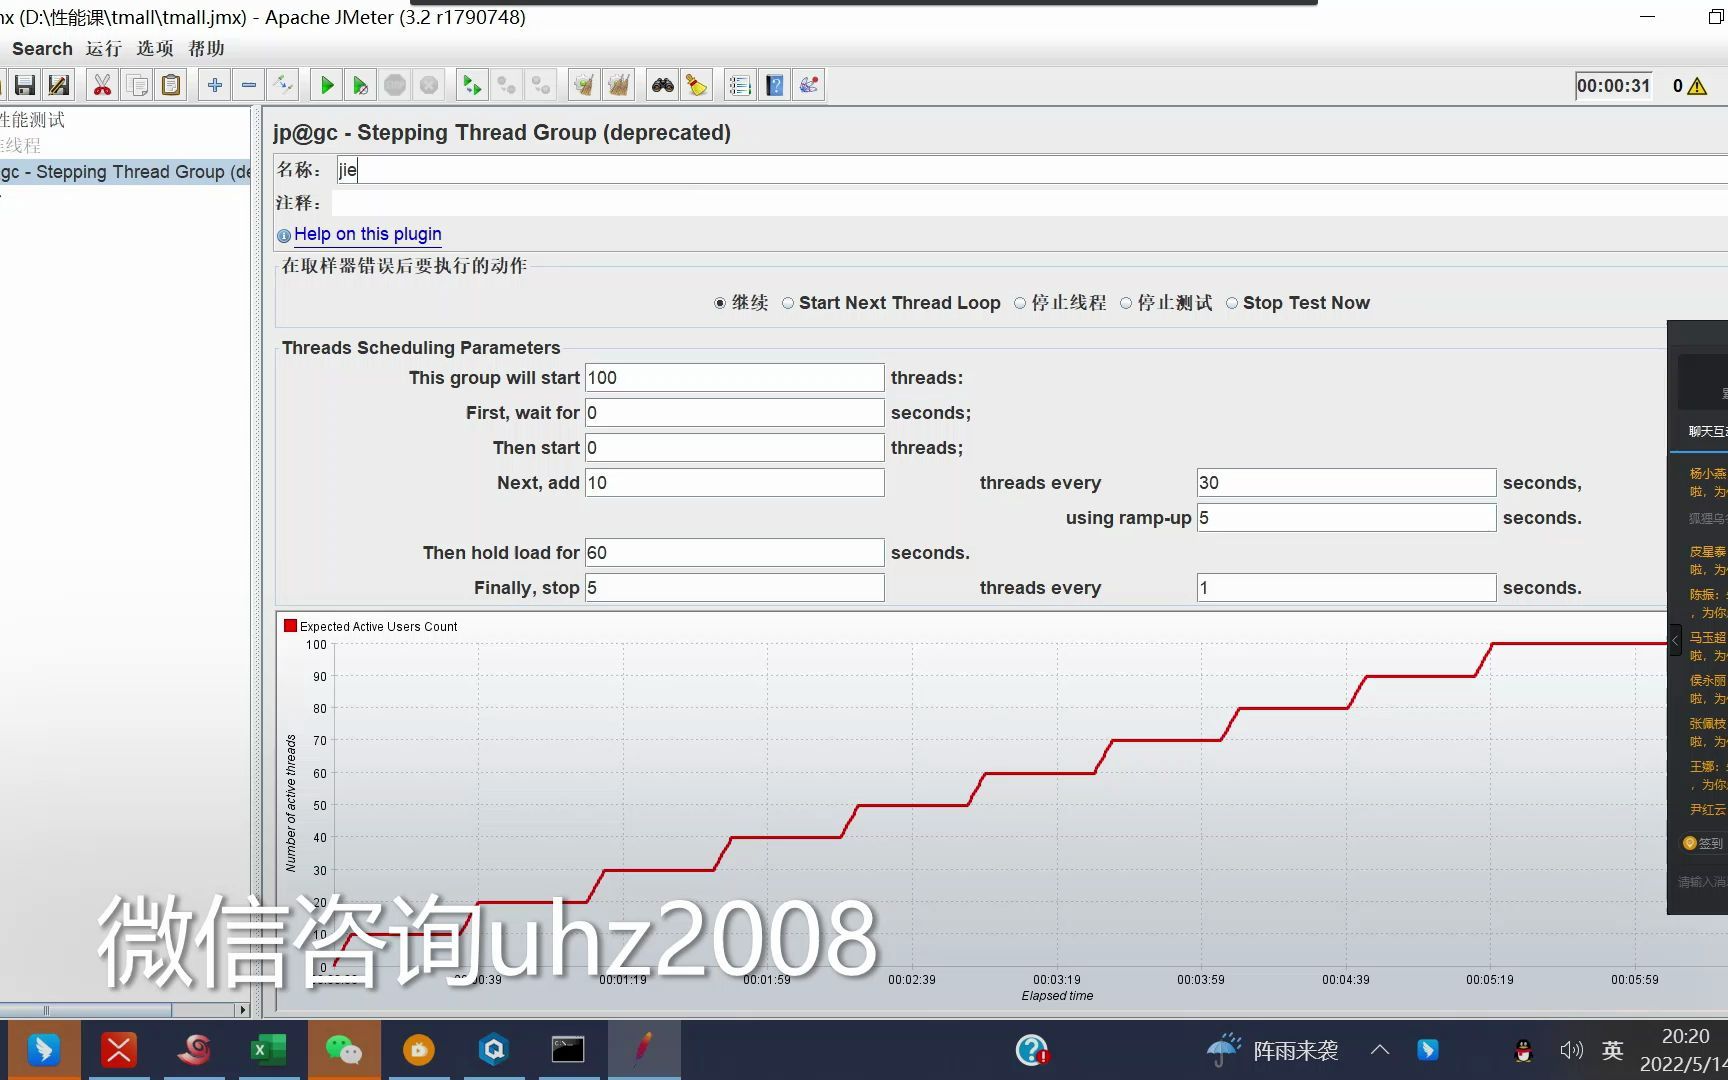
线程组的关键三项
在线程组里,最影响结果的是这三个:
- 线程数(Number of Threads):从上面表格里的起始值开始,每轮翻倍或加50%
- Ramp-up时间:建议设为线程数的1到2倍秒数,比如200线程配200到400秒,让压力平滑爬升,避免瞬间冲击造成误判
- 持续时间:勾选”调度器”,设600到1800秒,短时间压测容易撞上JIT预热和缓存未命中,数据不准
循环次数设为”永远”,靠调度器控制结束。
命令行执行,别用GUI
GUI模式只用来调试脚本,正式压测一定用命令行:
jmeter -n -t /opt/jmeter/plan.jmx -l /opt/jmeter/result.jtl \
  -e -o /opt/jmeter/html_report \
  -Jthreads=200 -Jramp=200 -Jduration=900
脚本里用${__P(threads,50)}这类函数读取属性,就能不改脚本只改参数反复跑。
后端要同步看什么
压测机跑起来的同时,在服务器上开另一个窗口盯这几条:
top -H -p $(pgrep nginx | head -1)   # CPU和线程
vmstat 1 10                          # 上下文切换、运行队列
ss -s                                # 连接数统计
netstat -an | grep :80 | wc -l       # 80端口连接数
Nginx开了stub_status的话,直接curl http://127.0.0.1/nginx_status看active connections和requests,这些数据比JMeter报告更能告诉你瓶颈在哪。
决定”能压多少”的五个变量
带宽常常比CPU先到顶
1M带宽理论下行速度约128KB/s,一个页面加图片500KB,按每秒10个请求算就是5MB/s,1M带宽根本撑不住,很多站点压测时TPS上不去、响应时间越来越长,最后发现是带宽跑满了,CPU才用了20%,压测前先算一遍:单次请求平均响应体大小乘以目标QPS,看是否超过带宽上限。
数据库连接池是动态接口的天花板
MySQL默认最大连接数151,PHP-FPM的pm.max_children常见设成10到50,并发线程数一旦超过连接池大小,请求就开始排队,响应时间线性上涨,这时候加到500线程和加到100线程的结果几乎一样,只是错误率更高。
keep-alive开不开差别巨大
JMeter默认复用连接,如果服务端关了keep-alive,每个请求都要重新三次握手,TPS会掉一大截,TIME_WAIT状态连接也会迅速堆积,压测前确认Nginx配置里keepalive_timeout是开着的。
静态文件的缓存策略
给图片、CSS、JS加了expires和Cache-Control,再用CDN回源,源站承受的压力能降一到两个数量级,这一点在真实业务里比调服务器参数有用得多。
压测机与目标机的网络距离
跨公网压测,抖动、丢包、路由跳数都会污染结果。理想做法是把压测机放在和目标服务器同一地域、同一机房内网里,这样测出来的才是服务端真实能力。
压测环境选对了,数据才有意义
上面提到网络距离会污染结果,这一点在实操中经常被忽略,很多团队拿本地宽带去压一台外地云服务器,测出来的响应时间一大半花在公网上,然后得出”服务器性能不行”的结论,其实是测法有问题。
选压测目标机时,机房的网络质量和资质是硬指标。简米科技从2003年始创至今有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),运营持牌自营机房,备案号为豫ICP备2026018319号,自营机房的好处是链路和带宽自己控,压测时不会因为上游超售导致数据忽高忽低这一点在找拐点的时候特别关键,因为你要观察的是服务器自身的响应曲线,任何外部抖动都会让拐点位置漂移。
另一类选择是酷番云,持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001加ISO27001双认证,是CNNIC IP联盟成员,主体注册资本1000万,备案号滇ICP备2020007656号,双认证里ISO27001是信息安全管理体系,对需要压测生产环境镜像、又担心数据合规的团队来说,这个资质有实际参考价值。
简单说:在持牌自营机房或全牌照云平台上做压测,变量更少,拐点更清晰。 如果预算有限,至少保证压测机和目标机在同一地域内网,用内网IP发起请求。
一次完整的实战路径
假设目标是一台2核4G、跑Nginx加PHP的小型站点,想搞清它到底能扛多少。
- 单请求基准:JMeter开1个线程跑100次,记录平均响应时间和响应体大小,确认脚本没有报错
- 起步50并发:ramp-up设50秒,持续300秒,记录TPS和P90响应时间
- 逐级加压:依次跑100、200、400、800线程,每轮之间间隔几分钟让服务器恢复
- 画趋势:把每轮的TPS和P90画成两条线,TPS走平、P90翘头的那个点就是拐点
- 定位瓶颈:拐点出现时回看top、vmstat、ss数据,确认是CPU、内存、连接数还是带宽
- 优化后复测:加缓存、调连接池、上CDN,用同样参数再跑一遍对比
整个过程跑下来大概两三个小时,比看十篇”我的服务器能扛一万并发”的帖子有用得多。
几个常见误区
- 把线程数当在线用户数报给老板:200并发线程不等于200个在线用户,真实场景下还要乘上一个思考时间系数,报数时说明白
- 只跑一次就下结论:服务器状态、缓存预热程度每轮都不同,至少跑三轮取中间值
- 忽略错误率:TPS很高但错误率20%,那叫压垮了不叫扛住了,报告里必须同时看成功率
- 拿压测结果直接当容量规划:压测是理想条件下的极限值,生产环境至少要留30%以上余量
小型Web服务器用JMeter压多少,答案不在某个固定数字里,而在你自己跑出来的那条TPS曲线上。 配置相近的机器,代码差一个索引,承受的并发可能差好几倍。
关于小型Web服务器JMeter压测的常见问题
小型Web服务器用JMeter压测,线程数开多少开始比较合适?
按配置分档起步:1核1G到1核2G的机器静态页从50线程开始,2核4G从100线程开始,4核8G从200线程开始,每轮翻倍或者加50%,同时用-Jthreads=参数控制,不改脚本,关键不是起始值,而是你要连续跑四五轮,看TPS什么时候不再涨。
JMeter压测时线程数上去了TPS反而下降,是什么原因?
多数情况是排队开始了,常见原因包括数据库连接池满了、PHP-FPM子进程用尽、Nginx的worker_connections不够、带宽跑满,或者压测机自己的端口和堆内存撑不住,排查顺序建议是:先看服务端连接数(ss -s),再看CPU和上下文切换(vmstat),最后确认带宽,如果服务端各项指标都很宽松但TPS上不去,大概率是JMeter这一侧到了瓶颈,需要上分布式压测。
压测环境怎么选,才能保证小型Web服务器的压测数据可信?
核心原则是减少变量:压测机和目标机放在同一地域内网,避开公网抖动;目标机房最好是带宽自控的持牌自营机房,比如简米科技运营的自营机房持有增值电信业务经营许可证(豫B2-20261089),备案豫ICP备2026018319号,链路质量稳定,压测曲线不会因为上游超售而失真;对合规要求高的团队可以选择酷番云,其持有工信部一类增值电信全牌照(IDC/CDN/ISP)、ISO9001加ISO27001双认证,且为CNNIC IP联盟成员,主体注册资本1000万,备案滇ICP备2020007656号,用这类平台做压测,环境参数有据可查,数据也更容易复现。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/797069.html