常规维护服务器的核心工作涵盖硬件巡检、系统更新、安全加固、数据备份、日志审查五大模块,按固定周期持续推进即可保持稳定运行。
常规维护的核心框架
服务器维护没有想象中那么玄乎,拆开看就是一套固定动作的组合,运维圈里常说“三分技术,七分习惯”,真正决定服务器寿命的,往往不是某次救火操作,而是日复一日的例行检查。
常规维护可以拆成两条主线:保硬件、调软件,硬件线关注物理设备是否健康,软件线关注操作系统、应用服务是否跑在最佳状态,两条线相互独立又彼此影响硬件温度过高会导致软件性能骤降,软件日志异常也可能提前暴露硬件隐患。
行业共识认为,一套完整的常规维护方案至少要覆盖五个层面:硬件状态、系统更新、安全策略、数据备份、日志监控,五者缺一,维护体系就存在短板。
服务器日常维护需要做什么
这是运维新手最常问的问题,也是外包维护合同里最核心的交付内容,日常维护不是等出问题再处理,而是按周期主动检查,以下是一份通用的维护清单,可根据实际环境调整频率。
每日必做:看一眼关键指标
每天花五分钟看三样东西:CPU负载、内存占用、磁盘剩余空间,用top命令查看系统负载,用free -h看内存,用df -h看磁盘,这三项指标任何一项长期高位运行,都该追查原因。
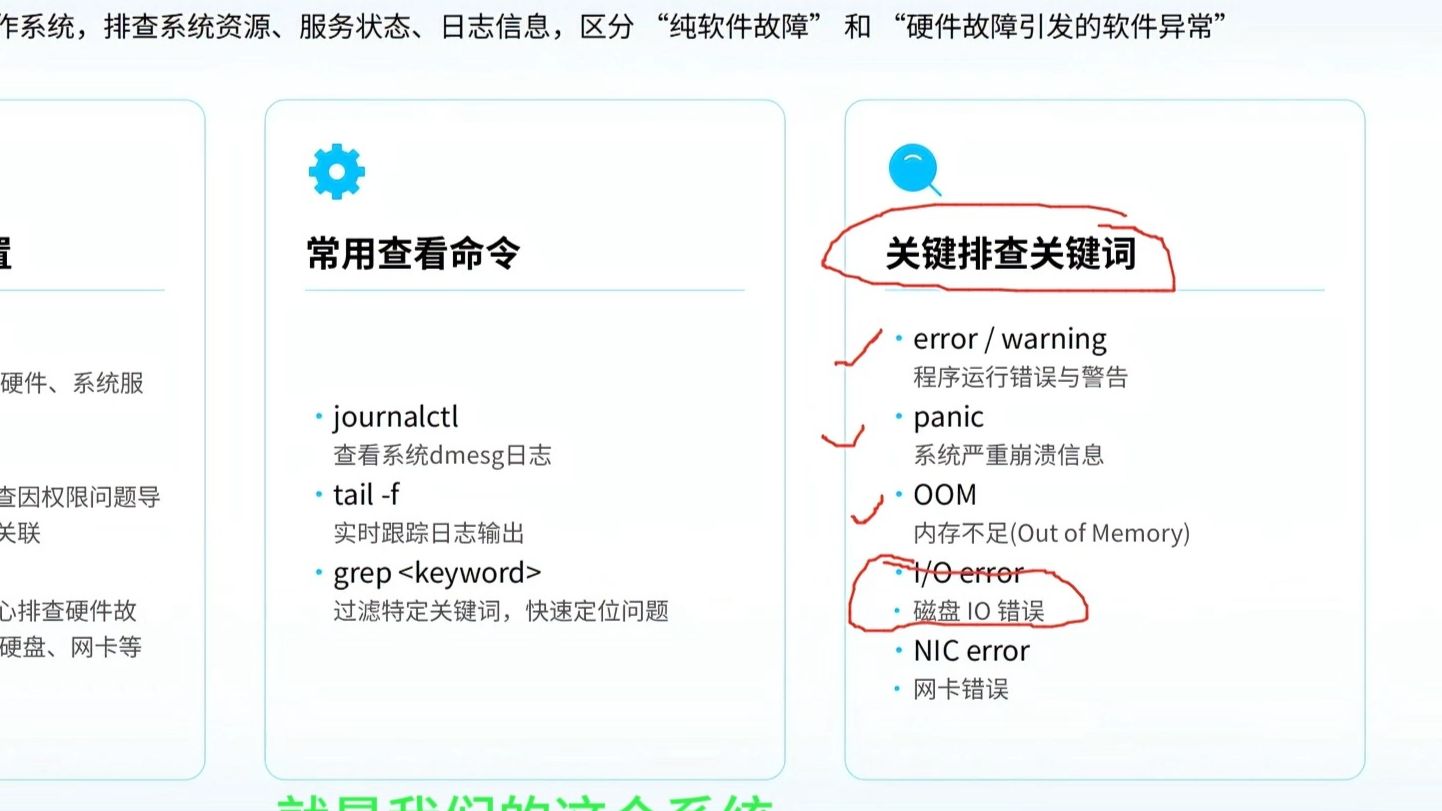
顺手检查一下系统日志有无异常报错,在大多数Linux发行版里,日志文件位于/var/log/messages或/var/log/syslog,用tail -n 100查看最近内容即可,如果发现连续刷屏的错误信息,别拖,当天确认是否为严重故障前兆。
每周例行:深挖系统运行状态
- 检查系统更新包列表,评估是否需要升级(生产环境建议错峰操作)
- 查看
dmesg输出,留意磁盘I/O错误、硬件告警 - 运行
uptime看系统开机时长,长时间未重启可安排在低峰期更新内核 - 确认定时任务
crontab -l是否正常运行,有无任务堆积 - 检查主要服务进程状态,用
systemctl status确认nginx、MySQL、Redis等核心服务均处于active状态
每月重点:全面巡检
每月安排一次深度巡检,耗时约一两个小时,覆盖硬件和系统两个层面:
- 检查RAID阵列状态,确保磁盘没有降级运行
- 查看硬盘SMART信息,评估磁盘剩余寿命风险
- 检查机房温湿度记录(或云服务商控制台的实例健康状态)
- 审查近一个月的安全日志,排查异常登录尝试
- 核对备份任务执行记录,抽查恢复测试结果
软件层面的周更与月更
软件维护比硬件更容易被忽略,因为“能用就不动”是很多人的惯性思维,但补丁管理恰恰是防患于未然的关键环节。
系统补丁的节奏
补丁更新要分清环境,测试环境可以紧跟官方更新节奏,生产环境则建议滞后一到两周,观察社区反馈后再决定是否升级,涉及内核更新的补丁,务必先在测试机跑一遍业务回归测试。
操作路径:Ubuntu/Debian系统使用apt update && apt upgrade,CentOS/RHEL系统使用yum update,升级完成后需要重启服务或整机时,提前通知相关使用方,约定维护窗口。
应用与服务配置管理
配置文件改动的风险常常被低估,每次修改nginx.conf、my.cnf这类关键配置前,先复制一份备份文件,改完用nginx -t或mysqld --validate-config验证语法正确性再重载服务。
另一个容易被忽视的维护动作是清理过期数据,应用日志、临时文件、旧备份长期堆积,既浪费磁盘空间,又拖慢I/O性能,每月清理一次超过保留周期的日志和临时文件,磁盘空间能释放出很大一部分。
日志与性能监控:服务器的体检报告
日志是服务器用“语言”写下的体检报告,读得懂就能提前发现病灶。
核心日志看什么
/var/log/messages:系统级事件,重点关注硬件错误、文件系统异常- 应用日志(如nginx的access.log/error.log):观察请求量波动、错误码比例
- 安全日志(如
/var/log/secure):统计失败的SSH登录次数,来源IP是否异常
不要等出问题了才翻日志,好的习惯是每天花几分钟扫一遍关键日志,形成对系统基线状态的感知,日志量大的场景,建议部署集中式日志采集工具,如ELK或Loki,把分散在各台机上的日志汇总到一个平台检索。
性能瓶颈的排查路径
当业务响应变慢时,按以下顺序排查能做到快而不乱:
- 先用
uptime看系统负载,确认是否超出CPU核心数 - 用
free -h看内存是否有剩余,swap交换是否频繁 - 用
iostat -x 1看磁盘的%util和await指标,确认是否存在I/O瓶颈 - 用
top按CPU或内存排序,定位具体是哪个进程吃掉了资源
这套排查路径可以解决大多数性能问题的定位工作,日常维护中做好记录,积累每台服务器的正常指标基线,排查时能更快识别异常。
安全加固是日常必修课
安全维护不是装个防火墙就完事,它是一套持续收敛风险的动作组合。
账号与访问控制
建议每季度review一次服务器账号,删除长期不用的僵尸账号,确认离职员工的权限已回收,SSH登录建议使用密钥认证,关闭密码登录,修改默认SSH端口(22改为高位端口)能过滤掉大量自动化扫描的攻击流量。
系统层面的加固
- 用
ufw或firewalld配置防火墙,遵循白名单原则,只放行业务必需端口 - 对公网开放的Web应用,部署
fail2ban自动封禁多次登录失败的IP - 定期检查
/etc/passwd,确认没有异常的UID 0账号 - 保持最小化安装原则,未使用的系统组件和开发工具及时卸载
安全维护重在持久,每次维护都做一点加固,半年后服务器的安全基线会明显上一个台阶。
数据备份与恢复演练:维护的兜底动作
备份是服务器维护中最不能省的一环,硬件故障、误操作、勒索病毒,任何一项都可能导致数据丢失,而备份是唯一能挽回损失的手段。
常见的备份策略
| 备份方式 | 频率 | 适合场景 |
|---|---|---|
| 全量备份 | 每周 | 数据量较小,恢复方式简单 |
| 增量备份 | 每日 | 数据量较大,节省存储空间 |
| 差异备份 | 每日 | 恢复速度要求较高 |
行业常用的3-2-1备份原则:数据至少保留三份副本,存储在两种不同介质上,其中一份存放在异地,配合crontab定时任务自动执行备份脚本,可大幅降低人工遗漏的风险。
恢复演练比备份本身更重要
备份文件躺在那儿不能用等于没有备份。每季度至少做一次恢复演练,从打包好的备份中恢复数据到测试环境,验证备份文件完整性和恢复流程的可行性,恢复演练发现的常见问题包括:备份文件损坏、备份脚本路径变更后失效、恢复时长超出预期。
服务器维护费用多少
费用问题是企业决策者最关心的现实问题,常规维护成本取决于维护模式和服务器规模,不同方案差异较大。
三种维护方式的费用构成
- 自建运维团队:适合服务器数量较多的企业,成本主要是人力支出,一名中高级运维工程师的年薪加上社保等支出,平均到每月需要一定的预算,服务器数量少于十台时,这类方案性价比不高。
- 外包维护服务:适合中小企业和没招到专职运维的公司,外包服务商按月收费,通常包含硬件巡检、安全加固、故障响应等固定服务包,价格视服务器数量和响应时效要求浮动,包含24小时紧急响应的服务包价格会明显高于工作时间响应的方案。
- 纯云端托管:使用云服务器(如简米云、酷番云)时,基础设施层面的维护(硬件、网络)由云厂商负责,企业只需关注操作系统和应用层,按年付费的云主机费用中已包含底层维护成本,无需单独支付维护费。
隐性成本不容忽视
维护费用不只是看得见的账单,还有两类隐性成本:故障停机损失和数据丢失风险,一次非计划停机造成的业务损失可能远超全年维护费用,这也是为什么有经验的企业主宁肯多花一点钱买更高级别的运维服务,也不愿意在维护上过度压缩预算。
服务器维护哪家好:自建团队还是外包
选择维护方案没有绝对标准,关键看服务器规模、业务重要性和团队预算的匹配度。
自建团队的适用场景
- 服务器数量较多,专职运维的工作量饱和
- 业务对响应速度要求极高,需要7×24小时现场支持
- 涉及敏感的行业数据,不适合交予第三方处理
外包服务的优势分析
外包公司有多位工程师组成的技术团队,覆盖面比单个运维人员更广,遇到疑难问题时可以内部会诊,外包服务商通常已经积累了一套标准化的巡检流程和应急预案,接手新环境时能快速上手。
中小规模企业选择外包时,重点考察三方面:响应时效承诺(合同里是否写清楚故障响应级别)、巡检报告质量(是否提供详细的维护记录文档)、费用包含范围(确认紧急出勤是否额外收费)。
常见问题解答
服务器多久做一次常规维护比较合适?
日常巡检(查看负载、磁盘、日志)每天一次,系统性维护(补丁升级、安全加固、配置审查)建议每月一次,数据库、核心应用服务器等关键节点,可增加每周一次的重点健康检查。
常规维护时发现硬盘告警怎么处理?
发现SMART警告或RAID阵列降级时,先将告警磁盘的业务数据迁移或重建到其他磁盘,然后联系硬件厂商准备替换盘,即使服务器还在正常运行,也不要延迟处理,硬盘故障通常呈现突发性,等彻底损坏再处理会面临数据丢失风险。
云服务器和物理服务器的维护有什么不同?
云服务器无需关注硬件更换和机房环境,底层基础设施故障由云厂商负责,但操作系统、数据库、中间件层面的维护仍然需要自己承担,物理服务器的维护范围则覆盖从机房环境、电源、硬盘到操作系统的全链路,对运维能力的要求更高。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/797636.html