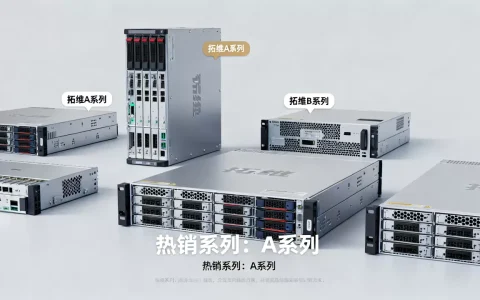
服务器管理不是装个系统就算完事,它是一整套技能组合,核心要具备硬件监控、安全防护、数据备份、性能调优和故障排查五板斧,缺哪块都容易半夜被报警电话叫醒。
服务器管理安全配置:先锁门再装修
服务器暴露在公网上等于把家门钥匙挂在门口,扫描端口、爆破密码的脚本全天候不间断,安全配置是服务器管理的第一顺位,这块做得越早,后面越省心。
系统级安全基线
拿到一台新服务器,先别急着装环境,按这个顺序把基础防线拉起来:
- 修改默认SSH端口,关闭root直接登录,创建普通用户加入sudo组
- 配置密钥登录,禁用密码认证(至少保留一个备用密钥,防止锁死)
- 开启系统防火墙,只放行业务端口和管理端口,其余一律DROP
- 安装fail2ban,连续输错几次密码直接封IP,日志里能看到攻击者来自哪个国家
- 设置自动安全更新,但生产环境建议在测试机验证后再推
端口和服务最小化
行业共识认为,超过一半的入侵事件源于未关闭的默认服务和暴露的调试接口,检查一下正在监听的端口,不知道干嘛的服务,直接停掉,用netstat -tlnp看所有监听状态的服务,用systemctl list-units --type=service --state=running看当前跑着哪些进程,很多云厂商的镜像预装了大量用不上的组件,该清就清。
权限和审计
权限管理是安全配置里最容易被忽视的部分,给开发和运维各分一个账号,谁做了什么操作,日志里一清二楚,用history命令检查可疑执行记录,用last看登录历史,像MySQL、Redis这类中间件,必须设置强密码,禁止用默认端口无密码裸奔,业务越重要,审计越要勤快。
服务器管理需要什么技能:从看懂日志到预判风险
很多新手以为服务器管理就是会敲几个命令,真出故障时才发现自己连日志都没看过,合格的服务器管理需要一套完整的技能栈,底层是Linux基础,上层是问题定位能力。
硬功夫:命令和脚本
- 系统状态:
top、free -h、df -h、iostat,这几个命令要形成肌肉记忆 - 日志分析:
tail -f /var/log/messages、journalctl -xe,出问题第一件事翻日志 - 网络排查:
ping、telnet、traceroute、curl -I,分清是本机问题还是链路问题 - 脚本能力:会写基本的bash脚本,定时任务、日志切割、自动备份都要靠它
软实力:思路和习惯
服务器管理讲究流程化处置,遇到故障先确认现象,再看监控告警,然后查日志,最后动手操作,别上来就重启,很多问题重启就丢线索,更重要的习惯是做变更记录,改了什么配置、什么时候改的、为什么改,写清楚,下次出问题,翻记录比瞎猜快得多。
监控体系搭建
没有监控的服务器管理等于闭眼开车,部署一套监控方案(Zabbix或Prometheus都行),覆盖CPU、内存、磁盘、网络、进程存活状态和端口连通性,告警规则别设得太敏感,否则天天被邮件轰炸,磁盘使用率超过80%要告警,内存余量低于500MB要告警,Nginx进程挂掉要告警,这些规则设置好,日常管理能省掉大部分手工检查工作。
服务器管理面板推荐:宝塔和1Panel谁更顺手
对不习惯全命令行的运维人员来说,面板是提高效率的利器,面板圈子里讨论频率较高的三款产品,各有各的侧重点。
宝塔面板:适合单机和小团队
宝塔在国内用的人最多,原因很简单:界面中文,安装方便,一键部署Nginx、MySQL、PHP环境,文件管理、数据库管理、定时备份都在网页上操作,对个人站长和小团队来说,宝塔的便利性无可替代,但有一点要注意,宝塔账号绑定手机号,部分插件收费,且历史上有过安全公告风波,生产环境使用建议关闭面板公网访问,或限定IP访问。
1Panel:适合喜欢容器化的用户
1Panel是新一代Linux服务器运维面板,界面风格更现代化,内置Docker管理功能,安装应用走容器化方案,对熟悉Docker、Kubernetes生态的用户来说,1Panel的思路更贴近云原生,项目开源,更新节奏快,社区活跃度在快速上升阶段。
其他可选项:Cockpit和Webmin
如果只求系统监控和基础管理,Cockpit是轻量选择,CentOS和RHEL自带,界面简洁,Webmin是老牌工具,功能齐全但年代感较强,除非特殊需求,否则新环境建议优先考虑宝塔或1Panel。
面板 + 命令行的组合模式是多数成熟运维的推荐方式:日常操作走面板降低上手门槛,故障排查和性能调优还得回命令行,两者缺一不可。
服务器管理多少钱一年:价格差异看需求
服务器管理的成本构成比较复杂,不只是服务器本身的租用费用,还包括人力工时、备份存储、带宽流量这些隐性支出。
云服务器和物理机的真实成本对比
| 类型 | 起步价格参考 | 维护强度 | 适合场景 |
|---|---|---|---|
| 云服务器(轻量应用) | 几十元/月 | 低 | 个人博客、小型展示站 |
| 云服务器(通用型) | 几百元/月 | 中 | 中小企业业务系统 |
| 物理机(托管/自购) | 数千元起步 | 高 | 大数据处理、高配计算 |
云服务器好还是物理机好?这个问题没有标准答案,云厂商的优势在于弹性扩展和快照备份,按量付费能省下空转成本,物理机的性能天花板更高,适合数据库、视频渲染这类对IO要求极高的工作负载,但维护成本和故障恢复时间要自己扛。
管理成本的计算口径
自建机房或物理托管,额外需要算上机房带宽、电费、设备折旧、专人维护成本,租用云服务器,则要把快照空间、备份流量、公网带宽、安全产品(如DDoS高防、Web应用防火墙)的订阅费用纳入预算,业内一般建议管理预算占服务器总成本的20%到30%,低于这个比例,监控和备份大概率是缺失的。
预算受限时的取舍
预算有限的团队,优先把成本花在数据备份和安全防护上,省钱做法包括:只在业务高峰期开更高配置的按量付费实例,用对象存储做冷备代替全部热备,日常数据手动备份到本地磁盘,千万别为压缩成本而放弃安全防护,一次数据丢失的损失远超一年省下的服务器管理费用,这是多数发生过事故的运维用教训换来的共识。
服务器管理日常巡检:每个时间段该干什么
管理服务器不只是在出问题时才介入,定期巡检能提前发现很多隐患。
每日任务
- 查看磁盘空间和inode使用率,清理日志、安装包等无用文件
- 检查关键进程状态,确认业务核心服务正常运行
- 看一眼昨天的备份任务日志,确认备份成功且文件大小正常
每周任务
- 升级系统补丁和软件版本,优先关注安全更新
- 检查日志中的异常登录、错误报错,分析是否有潜在威胁
- 清理数据库临时文件和慢查询日志,分析慢查询语句
每月任务
- 做一次全量数据恢复演练,在测试环境尝试还原备份,确认备份可用
- 审查用户权限列表,移除离职员工的账号、过期密钥
- 复盘上个月监控告警记录,调整阈值和告警规则
这些巡检动作建立起来之后,服务器的稳定性会明显提升,很多服务器故障并不是瞬间发生的,磁盘满了、内存泄漏、证书过期都是有预兆的,规律巡检配合监控告警,大部分风险都能及时拦住。
常见问题排查思路
服务器管理过程中有几类高频问题,几乎每个运维都遇到过。
服务器负载高但CPU占用不高,是什么原因?
多数情况下是磁盘IO瓶颈导致负载虚高,用iostat -x查看磁盘等待时间,或用top进程按D状态筛选,另外一个常见原因是内存不足导致Swap频繁读写,看起来CPU不高但系统响应慢,这种情况需要考虑加内存或优化内存使用。
服务器管理多久检查一次比较合适?
商业环境建议每日至少查看一次核心指标,监控告警具备7×24小时覆盖能力,每周做一次完整的安全和资源审计,每月做一次备份恢复演练。
如何判断当前的服务器配置是否够用?
跟踪最繁忙时段(比如每天上午10点和晚上8点)的资源使用峰值,如果CPU长期超过70%,平均负载超过核数,或磁盘IO等待时间持续偏高,就该考虑升配或调整业务架构了,配置升级要关注业务实际增长曲线,提前规划比临时扩容更稳妥。
服务器管理和运维到底有什么区别?
两者在多数场景下指同一个岗位,但侧重点略有差异,服务器管理更偏向基础设施本身,关注硬件状态、操作系统、基础服务的稳定性;运维范围更宽,涵盖业务发布、监控告警、故障处理、容量规划等更完整的技术运营链路,中小公司通常两者合一,大企业才会拆分细分工种。
服务器管理的能力核心不是会重启、会装软件,而是能看出系统当前处于什么状态,推断接下来会发生什么,并且提前拦截问题,把安全基线、监控告警、备份容灾、日常巡检这四件事落实到行动上,服务器的可靠性和安全性会站在你这边。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/797680.html