服务器只有2块盘做RAID,最稳妥且通用的答案是组RAID 1(镜像),它直接牺牲一半容量换数据安全,而RAID 0在多数生产环境下是拿业务开玩笑。在真实机房场景里,2盘位是入门级服务器(如戴尔T140、惠普MicroServer Gen10 Plus)的常见配置,既想提速又想冗余,往往陷入纠结,下面从需求、成本、操作和替代方案四个维度拆开揉碎讲清楚。
2块硬盘做RAID,先搞懂三张明牌
RAID 0、RAID 1、JBOD,这是2盘位服务器仅有的三条正路,RAID 5或RAID 6在物理层面就不可行,别被云厂商的块存储文档带偏了。
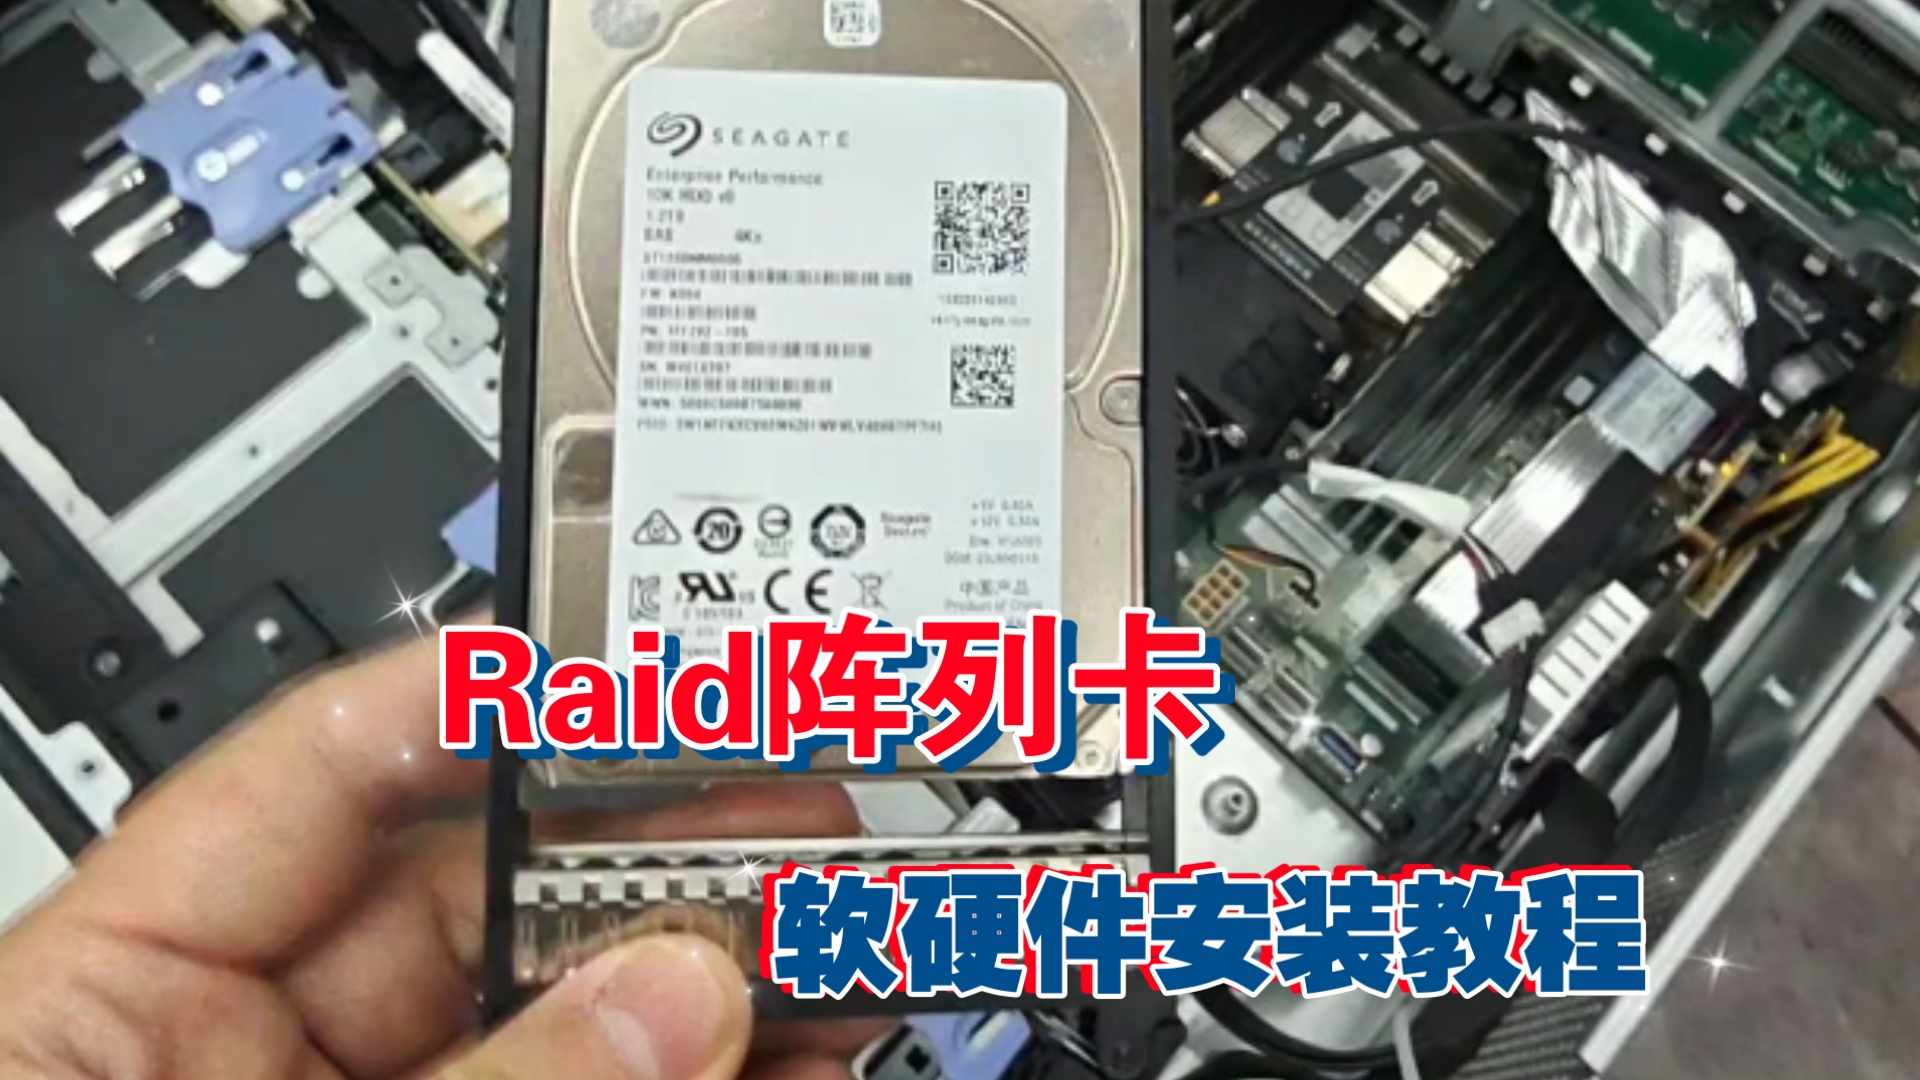
- RAID 0:数据拆成两块分别写入,读和写性能翻倍,总容量=2块盘相加,但任意一块盘损坏,数据全部丢失,它和“备份”二字不存在任何关系。
- RAID 1:两块盘同时写完全一样的数据,任凭一块盘突然罢工,业务照常跑,换上新盘就能自动重建,总容量是较小一块盘的容量,写入性能基本没提升。
- JBOD:准确说叫串联模式,系统把两块盘看作一个整体,第一块写满再写第二块,不提供冗余,也不提升性能,适合用来存放冷数据或监控录像。
从决策逻辑看,行业共识认为“服务器数据永远比硬件值钱”,所以除非你确定自己能在瞬间恢复备份且愿意接受停机,否则RAID 1就是唯一理性选择。
2块盘做RAID1还是RAID0:关键看业务能不能丢半小时数据
这是百度上关于服务器2块盘怎么做RD最常见的疑问句式。绝大多数场景最后都选了RAID 1,原因有三点。
重建成本极低,盘挂了以后,换一块同型号的盘(不必同批次),RAID控制器会自动做镜像复制,全过程业务几乎不受影响,而RAID 0盘挂了,需要从备份恢复,工作时间损失按小时计算。
写性能并非所有业务的瓶颈,数据库、ERP这类应用真正卡脖子的是随机读写延迟,RAID 1虽然不带条带化,但相比单盘在读取时能从两块盘同时拿数据,理论读性能接近翻倍,应付几十人的小公司业务完全够用。
RAID 0并非毫无市场。如果服务器只承担缓存层、临时渲染节点、CDN边缘节点,这些数据丢了能自动从源头拉取,且使用方明确要求高吞吐,那RAID 0确实是经济的选择。强制自己回答一个问题:假如这块盘明天坏了,我是否接受业务停顿且数据重新生成? 回答得干脆RAID 0,犹豫一秒RAID 1。
实战对比:两款主流阵列卡的表现
| 场景 | 戴尔PERC H740P(2盘RAID1) | 软件MDADM(2盘RAID1) |
|---|---|---|
| 读性能 | 提升明显,有缓存加速 | 略有提升,依赖CPU |
| 写性能 | 单盘水平,但响应稳定 | 单盘水平,偶尔系统中断影响I/O |
| 扩容方式 | 替换大容量盘后重建 | 替换大容量盘后mdadm –grow |
| 掉电保护 | 有缓存电池保数据 | 无,依赖文件系统Journal |
系统层更实用的替代:RAID1配LVM
如果你手头服务器只有2个盘,但又觉得RAID1浪费了一半空间,这组配置是目前最实用的方案,兼顾安全和灵活。
- 两块盘先建立RAID1,得到一块镜像卷。
- 在这块卷上创建物理卷,加入卷组。
- 卷组里划分逻辑卷,分配时不需要用满,留下未分配空间。
- 以后某天发现空间吃紧,用
lvextend -L +50G /dev/vg0/data实时扩容,无需停机。
通过这套组合,你既享受了镜像安全,又避免一锤子买卖把容量全分死,比单纯做RAID1再建分区灵活得多。
服务器2块盘raid配置步骤:硬件卡与软RAID实操
有不少搜索“服务器2块盘raid配置步骤”的用户卡在BIOS界面动弹不得,这里把硬件阵列卡和软RAID两条路分别走一遍。
硬件阵列卡配置流程(以戴尔PERC、浪潮RAID卡为例)
- 开机按
Ctrl+R(LSI芯片卡)或F2进入PERC BIOS(具体看引导界面提示)。 - 在VD Mgmt(虚拟磁盘管理)菜单中按
F2选择Create New VD。 - RAID Level(阵列级别)下拉框里选择RAID-1。
- 在右侧磁盘列表中,按空格把两块物理盘选为成员盘。
- 设置条带大小,RAID1下保持默认64KB即可,无需纠结。
- 初始化策略选Fast Init(快速初始化),后台就能装系统了。
- 退出并保存,回到启动设备首选项,把虚拟磁盘设为Boot Device。
Linux下软RAID(MDADM)流程
现在新装机用户使用mdadm这类工具做利旧的情况常见,步骤如下。
# 安装工具,前提是两块盘已经分区为fd类型
yum install -y mdadm
# 创建RAID1
mdadm --create /dev/md0 --level=1 --raid-devices=2 /dev/sdb1 /dev/sdc1
# 查看同步进度
cat /proc/mdstat
# 生成配置文件,重启生效
mdadm --detail --scan >> /etc/mdadm.conf
Windows Server这边更简单,用存储空间功能即可实现类似效果,需要了解的是,系统盘做软RAID时Data盘和系统盘拆开更有利于故障恢复,这是很多人踩过的坑。
服务器硬盘2块做RAID之外:更务实的折中方案
不是所有人都有余力给服务器买两块新盘,部分场景下,把现有两块盘孤立使用、依靠应用层备份反而比组RAID更从容。
比如一台跑着Nginx静态站或开发测试环境的服务器,没有宕机惩罚,此时方案可以变成:
- 系统盘独立,搭配普通SSD跑数据库。
- 数据盘独立,用
rsync --delete定时同步到另一块盘或NAS。 - 每两天做一次增量备份,冷备文件保留7天。
这一套方案没有RAID的坏块透明修复能力,但胜在逻辑简单、盘位清零、利用率100%,对于租金预算紧的用户来说,用空间换省心,效果立竿见影,在北上广深机房托管场景下,往往运维人手不足,这类简化配置的维护成本比RAID1还低,也属于常见做法。
什么时候必须加钱买第三块盘
以下信号出现时,2盘RAID1确实扛不住了,建议直接上第三块:
- 数据库日志文件大小已经是单盘容量的三成以上。
- 半夜报警发现RAID降级,却找不到扩容或重建的窗口期。
- 备用盘缺失,阵列裸奔超过两周。
- 需要同时跑虚拟机、备份任务和文件共享。
业内专家指出,等故障发生再考虑扩容的是运维事故,而不是技术方案,建议趁双十一或企业采购季,把第三块盘列入固定资产预算。
常见问题速查
2块盘能不能做RAID 5?
不能,RAID5至少需要3块物理盘,其校验分布式存放的原理决定了盘数下限就是3,2块盘强行做RAID5的结果是硬件卡直接报错,根本没有可选项,网上某些教程用回写缓存模拟RAID5的效果,那属于软件虚拟化层技术,与阵列控制器无关,不建议作为生产环境参考。
两块不同容量的硬盘做RAID1,总容量怎么算?
总容量以较小盘为准,比如一块2TB和一块4TB做RAID1,最终可用容量是2TB,剩余2TB的容量在RAID卷之外不可见,除非后续把2TB换成4TB完成重建后卷才会扩展,做之前先确认两块盘型号相近、转速一致,避免写性能被慢盘拖底。
RAID 1重建期间服务器需要停机吗?
不需要,热插拔硬盘支持在线拔出故障盘、插入新盘,阵列卡会自动把新盘识别为重建盘,整个过程读写业务不中断,唯一能察觉的是性能短暂下降,因为重建需要占用磁盘I/O,但如果服务器本身CPU和磁盘负载长期超过80%,建议把重建优先级调低,错开业务高峰期。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/799852.html