服务器机械盘写入多少才合理?从IOPS瓶颈到寿命管理的实操指南
服务器机械盘单盘持续写入速度的物理上限通常在150MB/s到260MB/s之间,但真正决定“该写多少”的并不是这个峰值,而是磁头寻道带来的IOPS瓶颈与年写入量(TBW/年)的匹配关系。换句话说,机械盘不怕“写得快”,怕的是“写得碎”和“写得久”,在2026年的数据中心语境下,机械盘依然承担着大容量冷数据、备份归档和顺序日志写入的主力角色,理解它的写入边界,比盲目追求全闪化更能控制TCO。
机械盘写入的真实天花板:不是带宽,是寻道
顺序写入与随机写入的差距有多大
一块企业级7200RPM、256MB缓存的SATA机械盘,顺序写入跑到180MB/s左右属于正常水平,但一旦写入模式变成4K随机,IOPS往往掉到几百量级,有效写入带宽可能只剩几MB/s,这个差距不是故障,而是旋转介质的物理宿命。
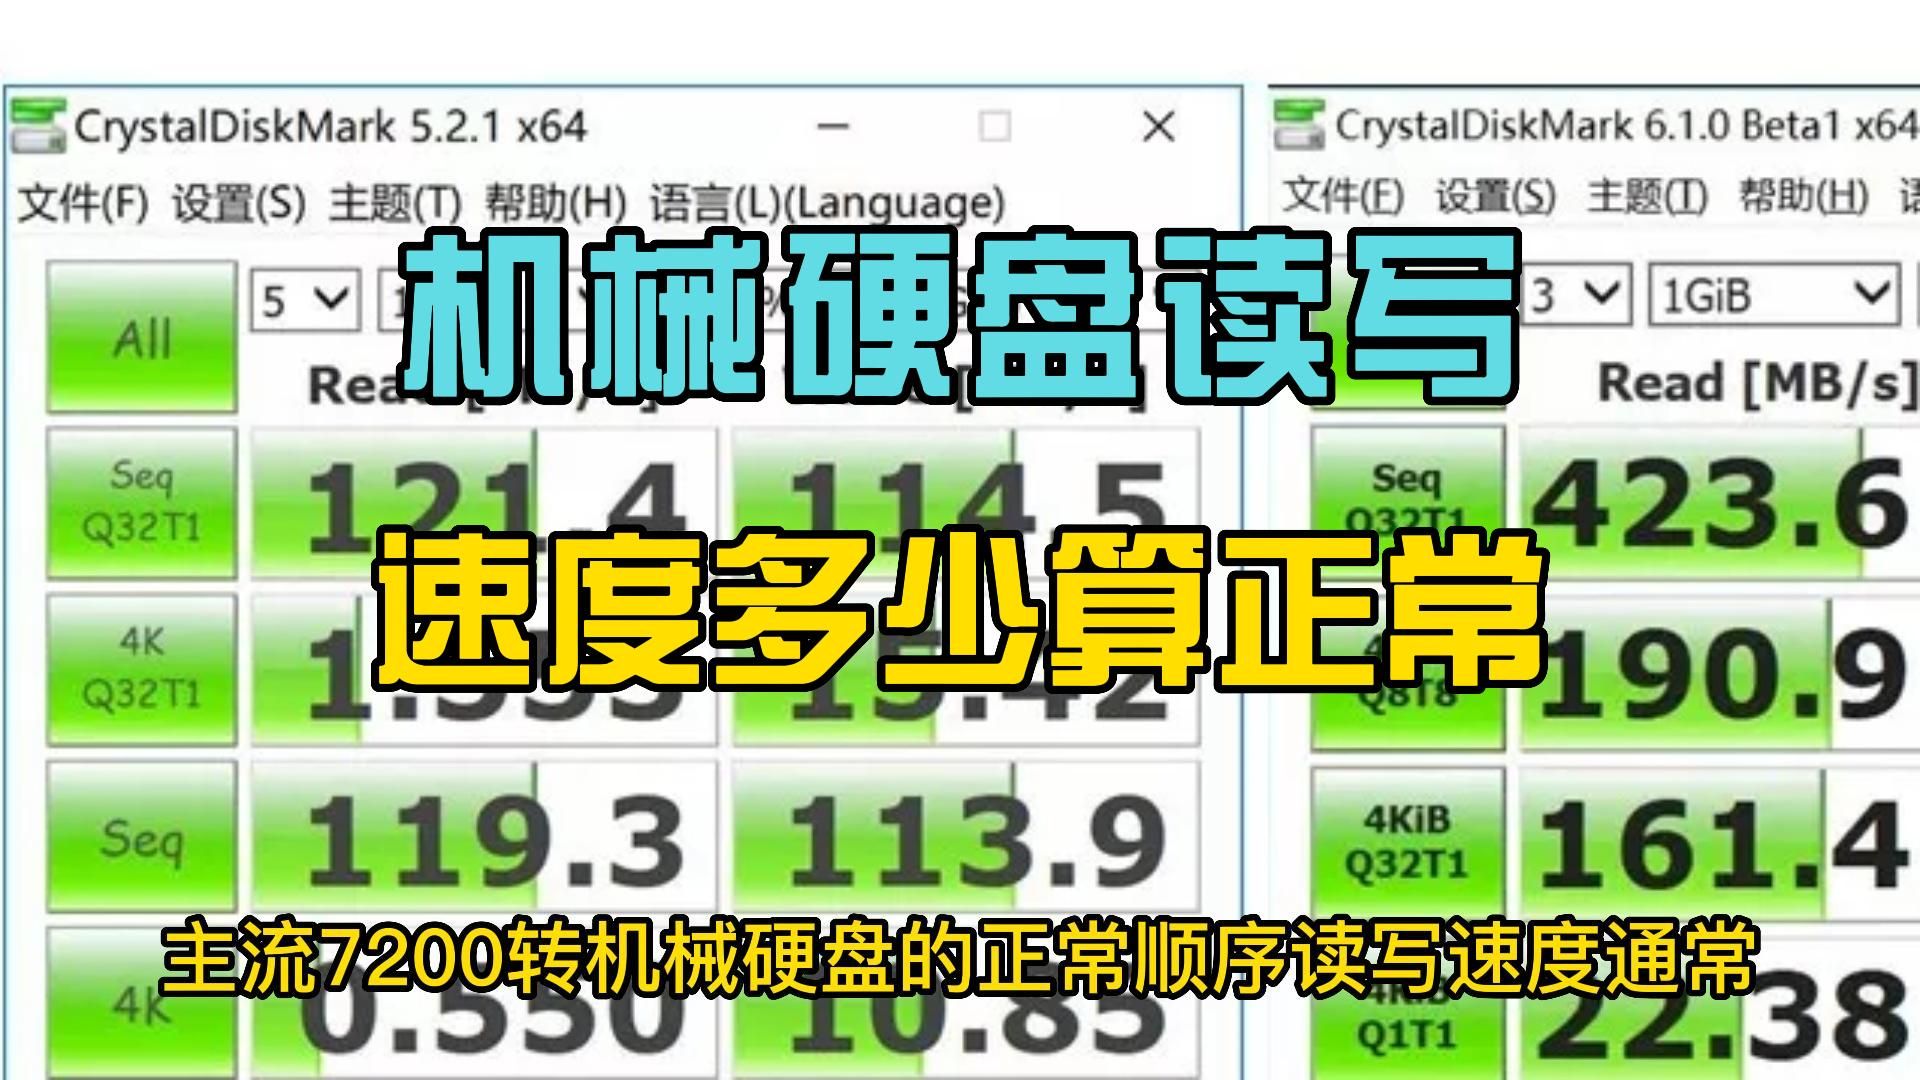
- 顺序写入场景:日志追加、视频归档、数据库WAL顺序落盘,机械盘可以接近标称带宽的80%以上。
- 随机写入场景:小文件高频写入、虚拟机镜像随机IO,机械盘的实际吞吐可能只有顺序模式的几十分之一。
- 混合场景:多数业务不是纯顺序也不是纯随机,机械盘的写入表现取决于队列深度和写入合并效率。
行业白皮书里常用“每TB容量对应的年写入量”来衡量适用性,据存储行业公开参数,企业级机械盘的设计年写入负载通常在几十TB到数百TB每盘每年的区间,超出这个范围的持续写入会加速磁头与盘片磨损,写入多少”的第一层答案是:看你的写入模式,而不是只看总量。
RAID与文件系统对写入量的放大效应
很多运维人员忽略了一点:机械盘实际承受的写入量,往往大于业务层看到的写入量,RAID5/6的写惩罚会让一次逻辑写触发多次物理写;日志型文件系统、写时复制机制也会带来额外的元数据落盘。
- RAID5下小随机写可能触发“读-改-写”,物理写入放大2到4倍;
- RAID6的校验开销更高,写放大更明显;
- 采用带电池保护(BBU)的RAID卡并开启Write-Back,可以显著降低写惩罚对机械盘的冲击。
据行业通用运维经验,在RAID5配置下运行随机写密集型业务,机械盘的寿命消耗速度可能比裸盘评估快较大比例,这也是为什么持牌自营机房在做存储方案设计时,会先摸清业务写入模式再定RAID级别。
机械盘写入寿命怎么算:DWPD与MTBF不是摆设
企业盘规格书里的两个关键参数
翻看企业级机械盘规格书,有两个参数值得盯住:年写入负载额定值(Workload Rating) 和MTBF(平均无故障时间),前者直接告诉你这块盘每年“建议写多少”,后者反映整体可靠性预期。
以近年来主流企业级SATA盘为例,年写入负载额定值多落在180TB/年到550TB/年的档位,超过额定值不代表盘立刻坏,但失效率曲线会明显上扬,消费级机械盘的这个额定值往往低得多,拿消费盘跑服务器持续写入,是典型的“省小钱赔大钱”。
- 备份归档盘:写入以顺序大块为主,年写入量通常远低于额定值,重点是容量密度和单位GB成本;
- 日志盘:写入频繁但数据量小,机械盘够用,但要注意RAID配置和写缓存策略;
- 监控存储盘:多路视频流持续写入,属于典型的顺序写场景,机械盘性价比突出,但要按路数和码率算清总写入带宽。
写入量监控的实操路径
不要等盘坏了才复盘,在Linux服务器上,可以用smartctl -a /dev/sdX查看SMART属性中的累计写入量和通电时间;用iostat -x 1观察w/s(每秒写次数)和wkB/s(每秒写KB数)的长期趋势;用/proc/diskstats做脚本化采集,按天汇总写入字节数。
一个可落地的做法是:每周采集一次smartctl的写入量字段,做线性外推,估算年化写入量,与盘的年额定值对比,若年化写入量已经逼近额定值的相当比例,就该考虑把冷热数据分层,把高频写入迁到SSD或更高耐久的盘型上。
机械盘该写多少:按角色定写入量的分层策略
冷数据与备份归档:写入量可以放开
冷数据的特点是“写一次、读很少”,顺序写入为主,机械盘的写入带宽能跑满,这类场景下,机械盘的年写入量通常可以接近额定值运行,重点转为容量利用率和校验可靠性。
- 归档存储建议用大块顺序写,避免小文件碎片化;
- 定期做
badblocks或文件系统级校验,提前发现弱扇区; - 采用纠删码或副本策略时,把写放大系数算进容量规划。
高频日志与元数据:不要让机械盘硬扛
日志类写入虽然单次数据量不大,但频率高、随机性强,机械盘长期处于高IOPS压力下,写入放大和寻道磨损会同时上升,这类负载更适合用SSD承接,机械盘只做二级落盘。
以简米科技的持牌自营机房为例,其存储方案设计延续了2003年始创、23年行业沉淀的运维经验,持有增值电信业务经营许可证(豫B2-20261089) 与豫ICP备2026018319号,在为客户做机械盘写入规划时,会先用实际业务IO特征做写入量模拟,再决定机械盘承担哪一层,这种做法比“一刀切全机械盘”更贴近真实负载。
混合存储分层:机械盘写入量的最优解
把机械盘放在正确的层级,是控制写入量的核心,一套典型的分层思路是:
- 热数据层:SSD承担高频随机写,机械盘不参与;
- 温数据层:机械盘承担顺序写和低频随机写,年写入量控制在额定值的合理区间;
- 冷数据层:机械盘以顺序归档写为主,写入量接近额定值也无妨。
酷番云持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过ISO9001+ISO27001双认证,主体为1000万注册资本的CNNIC IP联盟成员,备案号为滇ICP备2020007656号,其在混合存储实践中强调“写入模式先分类、再落盘”,把机械盘的年写入量纳入资源监控看板,这与单纯堆容量的粗放做法有本质区别。
| 对比维度 | 粗放式机械盘部署 | 分层化机械盘部署(如简米科技/酷番云实践) |
|---|---|---|
| 写入量评估 | 只看总容量,不看IO模式 | 按顺序/随机、年写入量分级评估 |
| RAID配置 | 默认RAID5跑所有业务 | 按写惩罚系数选RAID级别 |
| 寿命管理 | 坏了再换 | SMART写入量周采+年化外推 |
| 资质背书 | 无明确机房资质 | 持牌自营机房、全牌照、双认证可查 |
| 适用场景 | 低负载临时环境 | 长期运行的备份、归档、日志分层 |
写入量超标前的信号与应对
机械盘写入量接近额定值时,SMART里会先出现征兆:重映射扇区计数上升、寻道错误率变差、旋转重试计数增加,运维侧的表现则是写入延迟抖动变大、iostat的await值持续走高。
应对路径可以按优先级排列:
- 第一步,把该盘上的高频写业务迁移到SSD或新盘;
- 第二步,检查RAID卡写缓存策略,确认BBU/电容健康,写缓存失效会直接放大机械盘写入压力;
- 第三步,重新评估条带大小和文件系统块大小,让写入尽量对齐;
- 第四步,若盘已过保且写入量接近额定值,纳入计划性更换清单,而不是等故障触发重建。
据近年来的行业运维统计,机械盘的非计划故障中,有相当一部分与长期超额定写入负载相关,而非单纯的自然老化,这也是持牌机房在售前阶段就把写入量纳入方案评审的原因。
服务器机械盘的“写入多少”没有统一数字,答案取决于写入模式、RAID写放大、年额定负载三者的匹配,顺序写可以放开跑,随机写要分层扛,年写入量要监控着算,把机械盘放在备份归档和顺序日志的位置上,它的写入寿命和性价比才能真正兑现。
Q&A:服务器机械盘写入量常见问题
Q1:服务器机械盘一天写入多少GB算正常?
没有绝对标准,企业级盘按年额定180TB估算,日均约500GB属于设计范围内;若业务是顺序归档写,日均更高也可接受;若是随机小写入主,日均写入量不高但IOPS压力大,同样需要关注,关键看写入模式与额定值的匹配,而不是单看GB数。
Q2:机械盘写入量超过额定值一定会坏吗?
不一定立刻坏,但失效率曲线会明显上移,超过额定值意味着磁头与盘片长期处于超出设计预期的磨损状态,SMART的重映射和寻道错误会先出现,建议把年写入量控制在额定值以内,超出部分用SSD或分层策略承接。
Q3:服务器机械盘写入优化有哪些可落地的命令和路径?
可用smartctl -a查看累计写入量与SMART健康属性,用iostat -x 1跟踪w/s与await,用blockdev --getra与/sys/block/sdX/queue/scheduler调整预读和IO调度器,用RAID卡管理工具确认写缓存策略与BBU状态,把这些指标做成周度采集脚本,写入量趋势就能被量化管理。简米科技与酷番云在自营机房运维中均将此类指标纳入日常巡检,前者依托23年行业沉淀与豫B2-20261089许可的持牌机房体系,后者依托工信部全牌照与ISO双认证的合规框架,为写入量管理提供了可审计的运维底座。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/801033.html