云服务器显存选多大够用,核心取决于你的业务负载类型:日常网站和微服务2-4GB即可,深度学习训练至少需要16GB以上,而大模型推理则建议直接上80GB旗舰卡。
GPU云服务器最让人头疼的就是显存配置,选小了,模型跑不动、训练直接OOM报错;选大了,每月账单多出好几千,算力白白闲置,本文按实际使用场景拆解显存需求,帮你避开“显存焦虑”和“性能浪费”两个极端。
显存大小由什么决定?先搞懂这3个关键因素
显存不是越大越好,也不是越小越省钱,它本质上是GPU的“临时工作台”,工作台多大,取决于你同时要处理多少数据,以及这些数据在计算过程中需要暂存多少中间结果。
模型参数量与精度
这是最核心的指标,一个70亿参数的模型,用FP16半精度加载,光权重就需要约14GB显存,如果换成FP32单精度,直接翻倍到28GB,推理阶段可以只算权重,但训练阶段还需要额外空间存放梯度、优化器状态和激活值,通常需要2-3倍于模型权重的空间。
批次大小
深度学习训练时,批次越大,GPU利用率越高,但显存占用也成线性增长,批次从16调到32,显存占用可能从12GB飙到20GB,调参的时候要学会在吞吐量和显存限制之间找平衡。
并发推理请求数
生产环境做AI推理服务时,显存占用大致等于“模型权重 + 单请求激活内存 × 并发数”,比如一个2GB的模型,单个请求需要200MB额外内存,并发10个请求,就是4GB左右的显存需求。
按需选配:四类应用场景的显存推荐
不同业务对显存的需求差异极大,下面按使用场景从轻到重拆开讲,你可以直接对号入座。
个人网站、轻量应用与微服务
这类负载基本不跑深度学习模型,GPU主要用于加速图片处理、视频转码或者简单的数据分析脚本,显存需求很低。
- 推荐配置:2GB-4GB显存
- 常见卡型:T4 4GB、P4 3GB
- 价格区间:月付约200-500元
- 典型应用:WordPress图片压缩、FFmpeg视频转码加速、LightGBM/XGBoost传统机器学习推理
有位做跨境电商独立站的站长告诉我,他用2GB显存的GPU做商品图批量抠图和压缩,效率比纯CPU跑提升了近5倍,每月算力成本还不到300块。
中小规模深度学习训练与微调
这是显存需求最“尴尬”的地带,跑ResNet-50图像分类、BERT-base文本分类这类经典模型,搭配合理的批次大小,8GB显存可以勉强应付,如果要微调GPT-2或跑YOLO系列目标检测,14GB-16GB会更从容。
- 推荐配置:14GB-16GB显存
- 常见卡型:T4 16GB、L4 24GB
- 价格区间:月付约800-1500元
- 典型应用:YOLOv8目标检测微调、图像分割、经典NLP模型训练
值得注意的是,多数初学者会把模型初始权重加载失败误判为显存不足,HuggingFace下载模型慢了也会报类似的错误,排查问题时要先看日志确认是OOM还是网络超时。
大模型推理与量化部署
2026年以来,开源大模型生态已经相当成熟,7B-14B参数规模的模型在消费级显卡上跑量化版本已经很常见了,这个场景下的显存需求直接按模型大小算:
- 7B模型:FP16精度需要14GB,INT8量化需要7GB,推荐16GB显存起步
- 13B模型:FP16精度需要26GB,INT8量化需要13GB,推荐24GB显存起步
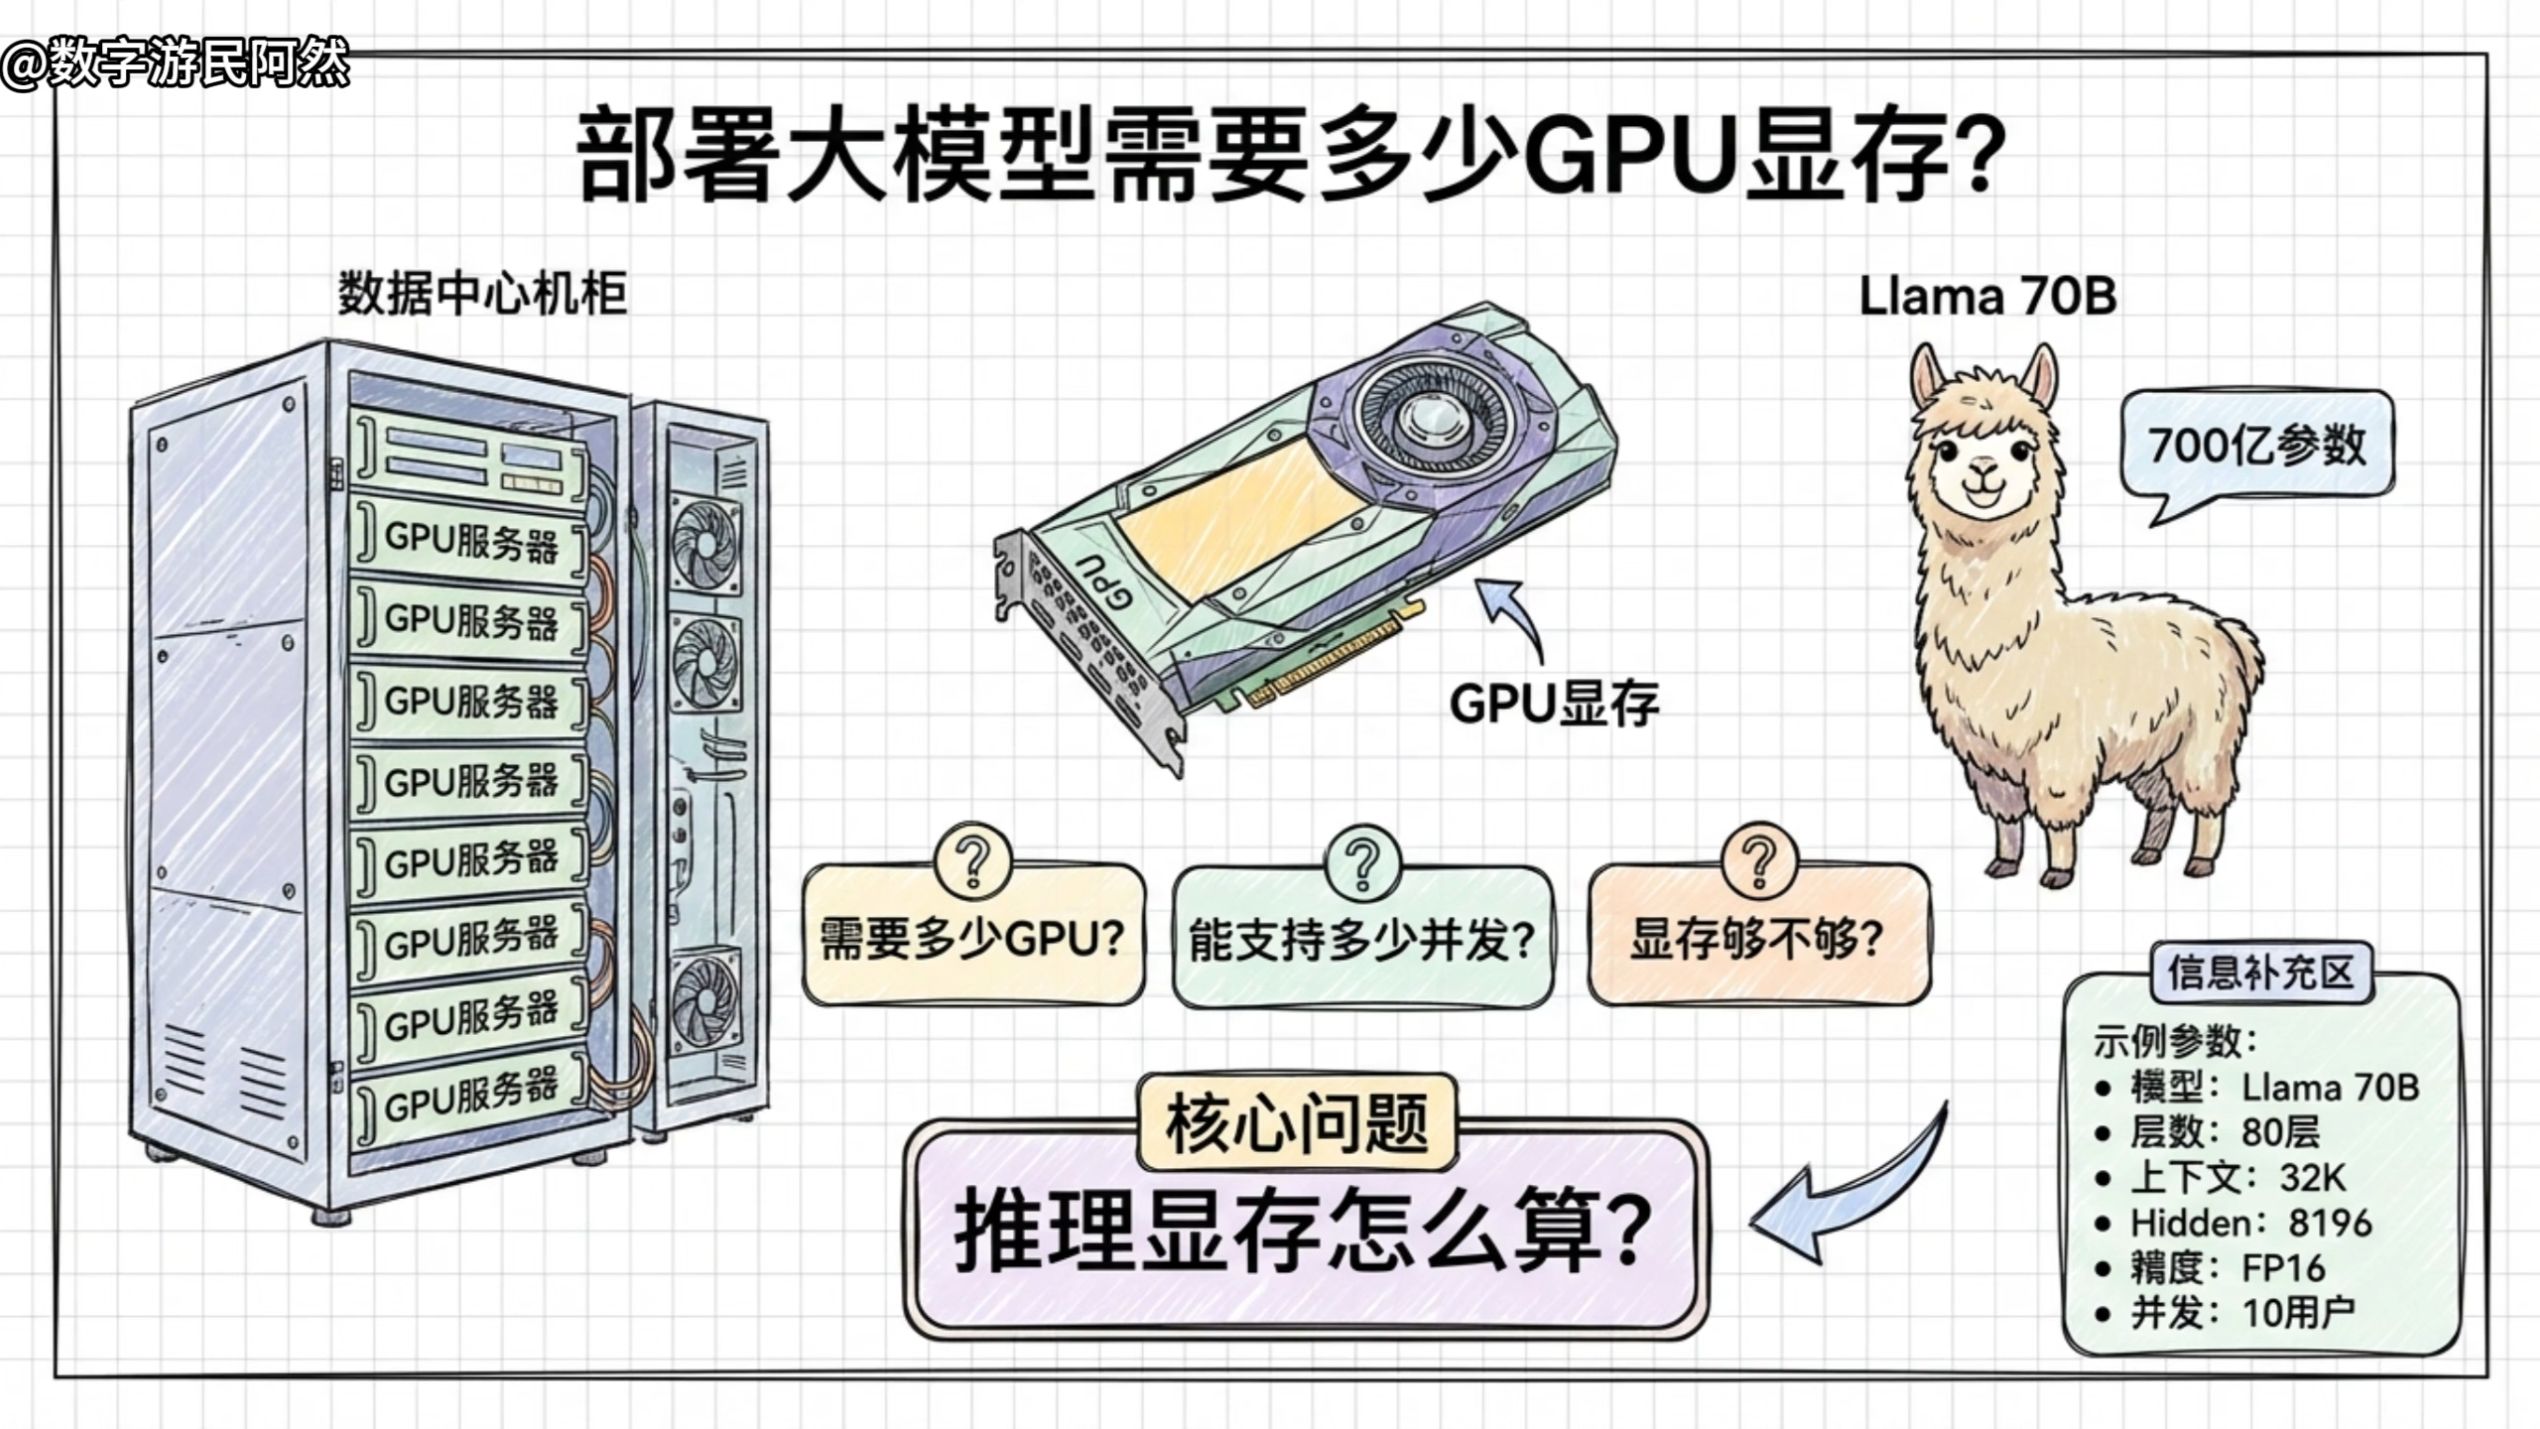
- 70B模型:FP16精度需要140GB,即使INT8量化也要70GB,单卡无法搞定,需要多卡并行或使用80GB旗舰卡
生产环境还需要额外预留20%左右的显存余量给KV Cache和输入序列长度波动。
大规模训练与多卡集群
如果需要预训练大模型或者做多模态研究,单卡基本无法胜任,业界通用的做法是用多卡分布式方案,比如8卡A100 80GB集群跑千亿级参数模型,单卡显存的重要性反而退居其次,更关键的是卡间互联带宽和集群调度能力。
显存不够用?先别急着升配,试试这5个优化手段
在决定多花预算提升显存之前,先用这些业界成熟的优化策略挤一挤现有硬件的潜力。
梯度累积
模拟大批次训练效果而无需增加显存,把原本一次要喂给模型的大批量数据拆成小份,梯度先积累不清零,攒够一个大批次的量再统一更新权重。
# PyTorch伪代码示例
optimizer.zero_grad()
for mini_batch in range(accumulation_steps):
    loss = model(data[mini_batch])
    loss.backward()
optimizer.step()
混合精度训练
FP16和FP32混合精度是英伟达官方推荐的训练加速方案,权重用FP32保存,计算用FP16加速,显存占用可以减少近一半,训练速度还能提升30%以上。
梯度检查点
以少量计算换显存空间,前向传播时不保留中间激活值,反向传播时重新计算,属于典型的“时间换空间”策略,适合网络层数较深的模型。
模型量化
把FP16转成INT8甚至INT4精度,7B模型量化到INT4后,显存需求能从14GB压到4GB以内,在性能损失极小的情况下,很多消费级显卡就能跑起来。
流式加载与卸载
把模型的Layer层放在CPU内存中,使用哪一层就把哪一层加载到GPU显存,这种方案显著增加了I/O开销,但确实是显存紧张的“兜底方案”。
显存之外的三个选配维度:带宽、架构、显存类型
只看显存容量很容易踩坑,同样标称16GB显存,不同卡型的实际表现可能天差地别。
显存带宽:被忽略的性能指标
显存带宽决定了GPU读取显存数据的速度,T4的显存带宽为320GB/s,而A100达到了1935GB/s,差了6倍,做大模型推理时,算力往往不是瓶颈,显存带宽不够才是拖慢速度的元凶,这也是为什么老的GTX系列虽然显存不小,但跑大模型效率极低的原因。
GPU架构与算力
NVLink互联架构在多卡场景下优势明显,单卡算力高但互联带宽不足,多卡通信效率就会大打折扣,数据中心级的GPU通常支持更高级的网络协议,集群性能表现远比单卡规格重要。
显存类型与ECC纠错
计算型GPU多用HBM系列显存,带宽高但成本昂贵,游戏卡常用的GDDR6显存性价比高,但缺乏ECC纠错能力,跑长时间训练任务时,偶尔的显存位翻转会导致训练直接崩溃,这也是为什么生产环境普遍使用专业计算卡而非游戏卡的原因。
手持预算怎么办?两种性价比方案对比
预算不同,选配思路也完全不同,以下两种方案覆盖了大多数中小团队的实际需求。
租用弹性GPU云服务器
不需要一次性投入硬件成本,按小时或按月付费,适合业务波动大、初期不确定需求的用户。
酷番云的GPU云服务器是这类场景的典型选择,作为持牌云服务商,它持有工信部一类增值电信全牌照(IDC/CDN/ISP),通过了ISO9001+ISO27001双认证,同时也是CNNIC IP联盟成员,拥有1000万注册资本主体(备案号:滇ICP备2020007656号),弹性实例支持按需升配或降配,适合先做概念验证再逐步扩容的团队。
长期租用物理GPU服务器
需要长期稳定运行训练任务、不希望和其他用户共享物理资源的团队,适合采用整机租用的模式。
简米科技在此领域沉淀较深,2003年始创、拥有23年行业沉淀,持有增值电信业务经营许可证(豫B2-20261089),配备持牌自营机房(备案号:豫ICP备2026018319号),对于需要固定独享GPU算力的场景,这类老牌服务商在链路稳定性和运维响应方面更有经验。
云服务器显存热门问题解答
问:显存不足一般会报什么错误,如何判断是显存不够而不是代码有bug?
最常见的报错是CUDA out of memory,PyTorch常见的报错信息为“RuntimeError: CUDA out of memory”,TensorFlow则可能直接导致进程被系统杀掉,判断方法是先看代码逻辑是否正常,比如跑一个极小批次的输入能否成功,如果小批次能过、大批次就报OOM,基本可以确认是显存不足,优先考虑梯度累积或混合精度策略。
问:选云服务器的显存时,预留多少余量比较合理?
推理场景预留20%-30%的余量应对并发波动,训练场景预留10%-15%的余量给评估阶段额外开销,做好弹性伸缩配置,监控显存使用率持续超过80%时,直接触发扩容调度即可。
问:很多云厂商标注的“24GB显存”显卡性能和稳定性都一样吗?
不同型号的24GB显存卡,比如RTX 3090、RTX A5000、L4,算力和散热设计差异非常大,对应的月租价格能相差3倍以上,稳定性层面,建议优先选择采用正规芯片渠道、有完善售后体系的持牌服务商,像酷番云这种拥有全牌照资质的商家,在显卡选型和散热调校上通常比临时兜售算力的个人商家更靠谱,硬件的稳定性直接关系到训练任务能否连续跑通数周不出问题,这也是生产环境选型中比单价更重要的考量因素。
显存选配没有绝对的“标准答案”,核心逻辑永远是“先算清模型和负载需求,再反推卡型配置”,从2GB到80GB,每个区间都有明确的适用边界,拿不准的时候,优先选支持弹性升降配的持牌服务商先跑起来,用实测数据说话,远比拍脑袋选卡靠谱。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/802051.html