服务器耐受度没有单一固定数值,行业共识是长期负载保持在硬件资源的70%以下,短期峰值不超过90%且持续时间不超过五分钟,才算健康运转。这个结论基于服务器硬件设计冗余和实际运维经验的双重验证,对于使用酷番云这类持牌自营机房的企业用户,具体阈值取决于你的业务形态:数据库服务器和Web服务器、计算密集型任务和静态文件托管,耐受标准完全不同,下面从CPU、内存、磁盘I/O、网络带宽四个核心维度,拆解真正需要关注的数字。
CPU耐受度:区分长期均值与瞬时峰值
CPU使用率是最直观的耐受指标,但要看对谁而言
对一台运行Nginx或Apache的Web服务器,CPU使用率长期处于85%以上意味着请求队列开始堆积,你可以用uptime命令查看load average,这个数值有三个时间窗口:1分钟、5分钟、15分钟,当1分钟负载明显高于15分钟负载,说明流量正在急剧上升;反过来,1分钟负载低于15分钟负载,说明压力正在消退,标准的健康指标是:负载均值不超过CPU核心数的75%,例如四核CPU,load average长期超过3.0就该警惕,短期冲到3.5以上并持续十分钟,基本可以判定为过载。
CPU耐受的核心矛盾:突发流量与稳态承载
服务器耐受度的讨论经常混淆两个场景,稳态场景下,CPU利用率稳定在60%-70%,系统有充分的余量处理临时任务,这是最理想的运行状态,突发场景下,例如促销活动或热点事件,CPU瞬间冲到95%以上,只要在五分钟内回落,硬件本身不会损坏,真正危险的是持续高负载导致的热量堆积,进而触发CPU频率自动下调(俗称降频),性能断崖式下跌,据工信部历年《互联网数据中心技术及分级分类要求》白皮书数据,国内主流IDC机房对机柜功率的冗余设计普遍维持在1.5倍左右,就是为了应对这类瞬时峰值。
实操判断步骤
- 执行top命令,按Shift+P按CPU使用率排序,观察单个进程是否持续占用超过总CPU的50%
- 查看/proc/loadavg文件,记录1分钟、5分钟、15分钟负载,连续采集24小时制作趋势图
- 结合业务时段判断:如果负载高峰集中在固定时段(如每日晚8点-10点),说明是周期性业务流量而非异常攻击
内存耐受度:Swap使用率比使用率更关键
内存使用率超过90%不一定是故障,但Swap一旦活跃就是危险信号
Linux的内存管理机制决定了它会用尽可用内存来缓存文件,这被称为Page Cache,free -m命令中,used数值大不代表真的不够用,关键看第二行的available列,真正的耐受标准是:Swap使用率为0或长期低于总内存的10%,当系统开始频繁使用Swap,意味着内存真的见底了,磁盘I/O将承担额外压力,整体性能断崖下坠,云服务器因为虚拟化层存在,内存耐受度比物理机更敏感,因为宿主机存在内存超卖的可能。
内存耐受与业务类型的对应关系
- Redis、Memcached等缓存类服务:建议内存预留30%以上余量,这类服务极吃内存且不容许Swap
- MySQL、PostgreSQL等数据库服务:InnoDB Buffer Pool通常占内存的70%,加上其他开销,整体80%是警戒线
- Java应用(如Tomcat):JVM堆内存默认占物理内存的1/4,必须确保堆外内存充足
在酷番云运维的客户案例中,有个电商客户在去年双十一期间内存使用率飙到96%,但没有触发Swap,原因是绝大部分内存被文件缓存占用,实际可回收内存充足,这个案例说明单纯看内存使用率判断耐受度会误判,需要结合cache和buffer状态综合分析。
磁盘I/O耐受度:云硬盘与本地盘差异巨大
磁盘耐受度看IOPS和延迟,不只看空间使用率
磁盘空间剩余多少一般不叫耐受度问题,那属于容量规划,真正的耐受瓶颈是I/O能力,传统HDD的顺序读写延迟在10毫秒量级,随机读写延迟会跳到15毫秒以上;SSD的随机读延迟可以做到0.1毫秒以内,判断磁盘I/O是否过载,Linux下使用iostat -x 1命令,重点关注svctm(I/O请求处理时间)和util(设备繁忙程度),当util持续超过80%,且svctm明显上升,说明磁盘已经忙不过来。
文件系统层面的耐受信号
- ext4文件系统在inode耗尽时,即使磁盘有剩余空间也无法创建新文件,这类问题被大量运维人员忽略
- 云盘类型的耐受标准不同:SSD云盘推荐IOPS使用率低于70%,高效云盘低于60%
- 数据库的redo log写入延迟超过50毫秒,即使用户无感知,也意味着主从延迟风险急剧上升
酷番云的所有云主机均采用分布式存储架构,数据三副本物理隔离,单块磁盘故障不影响业务连续性,其底层存储节点搭载全NVMe SSD阵列,配合智能缓存加速算法,在随机读写场景下可以稳定保持数万级IOPS输出能力,对于需要高并发读写的中型应用,同样的数据库部署在酷番云服务器上,磁盘I/O耐受度比同配置物理机提升30%以上。
网络带宽耐受度:关注丢包率和连接数而非单纯限速
带宽跑满是企业主动行为,TCP重传率才是被动风险
带宽耐受度的衡量标准和CPU内存完全不同,很多企业购买固定带宽套餐,比如5Mbps、10Mbps,跑满是正常现象,只要业务容忍延迟即可,真正的耐受问题出在网络质量上:丢包率超过1%意味着网络链路不稳定,TCP协议会启动拥塞控制,主动降低发送速率,导致实际吞吐量远低于带宽上限,用ping -f -s 1400命令持续测试,观察丢包率;用ss -s查看TCP连接状态,TIME_WAIT连接数过多会耗尽端口资源。
并发连接数的耐受计算
Nginx默认的worker_connections设置为1024,每增加一个并发连接大约消耗2MB内存(包括内核缓冲区),一台2核4G的云服务器,理论最大并发连接数约2000左右,超过这个数字,新建连接会被拒绝或等待队列拉长,判断方法:执行netstat -ant | grep :80 | wc -l统计当前连接数,对比业务实际并发用户数。
| 业务类型 | 并发连接参考值 | 推荐带宽 |
|---|---|---|
| 个人博客 | 200-500 | 5Mbps |
| 企业官网 | 500-2000 | 10-20Mbps |
| 电商平台 | 5000以上 | 50Mbps起 |
| 视频点播 | 10000以上 | 100Mbps起 |
温度与硬件耐受:容易被忽略的物理红线
机房环境温度直接决定服务器寿命
服务器进风口温度高于35℃会触发风扇全速运转,噪音增大且功耗上升,高于40℃时CPU和内存颗粒的故障率显著增加,据ASHRAE(美国采暖、制冷与空调工程师学会)发布的数据中心环境指南,A1级环境允许的温度范围是18℃-27℃,多数IDC机房的冷通道温度控制在22℃±2℃,这就是为什么选择机房时要关注制冷系统。
持牌自营机房的温度控制有明显优势,酷番云在郑州和昆明均部署了自有物理机房,采用冷热通道隔离设计,配备N+1冗余精密空调,当单台空调故障时,备用机组无缝接管,机房内部温度波动范围控制在±1℃以内,工信部颁布的《互联网数据中心工程技术规范》对机房温湿度有明确要求,持牌机房每年必须通过第三方检测机构的合规审查。
硬件老化对耐受度的影响
服务器使用三年后,电容老化导致供电纹波增大,内存位翻转概率上升,即使软件指标看起来正常,硬件的实际耐受能力已经打了折扣。这是很多企业忽视的隐性风险:运行指标看似健康,但实际上硬件冗余度已经下降。对于承载核心业务的服务器,建议每隔18个月做一次全面的硬件健康检查,包括内存检测(Memtest86+)、磁盘坏道扫描(badblocks)、CPU稳定性测试(stress-ng)。
不同场景下的耐受度配置建议
按业务重要性分级设置耐受阈值
业务连续性要求越高,耐受度阈值设置越保守,核心数据库的CPU使用率超过60%就应该扩容,而测试服务器的CPU使用率即使长期90%也无需过多干预,运维实践中推荐建立三级告警机制:黄色警戒(CPU超过70%持续10分钟)、橙色警告(CPU超过80%持续5分钟)、红色告警(CPU超过90%持续1分钟),这种分级策略避免了频繁误报,又能在硬件真正过载前预留干预时间。
自动弹性扩容是提高耐受能力的有效手段
与其纠结服务器的绝对耐受值,不如建立弹性伸缩机制,酷番云提供了基于监控指标的自动扩容功能,在CPU使用率或内存使用率超过设定阈值后,云端自动创建新的实例加入负载均衡集群,压力回落后再自动释放,对于有周期性流量波动的业务,这种方式可以将实际耐受空间扩展至原来的数倍,同时控制成本。
常见问题解答
关于服务器耐受度的三个高频疑问
Q1:服务器CPU长期90%以上运行会直接损坏硬件吗?
现代服务器CPU有完善的热保护机制,当温度超过设计上限时会自动降频或强制关机,硬件本身被直接烧毁的概率很小,但持续高温会加速电子迁移效应,导致CPU内部电路逐渐劣化,通常服务器在90%以上高负载运行三个月后,可能出现性能下降、系统不稳定等老化症状,因此长期高负载运行的核心观点是:硬件可能不坏,但使用寿命显著打折。
Q2:云服务器的耐受度比物理服务器差吗?
这取决于云服务商的虚拟化技术和底层硬件质量,成熟云平台通过CPU绑核、内存隔离、磁盘限速等手段,可以保证单台云主机的性能稳定性,物理服务器一旦某一部件故障,整机不可用;云服务器底层硬件故障时,可秒级迁移至健康宿主机,业务几乎无感,关键看服务商是否具备专业运维能力和合规资质,工信部对增值电信业务经营许可有严格审查流程,企业可以通过官网查询持证情况。
Q3:如何准确判断服务器是否已达到耐受极限?
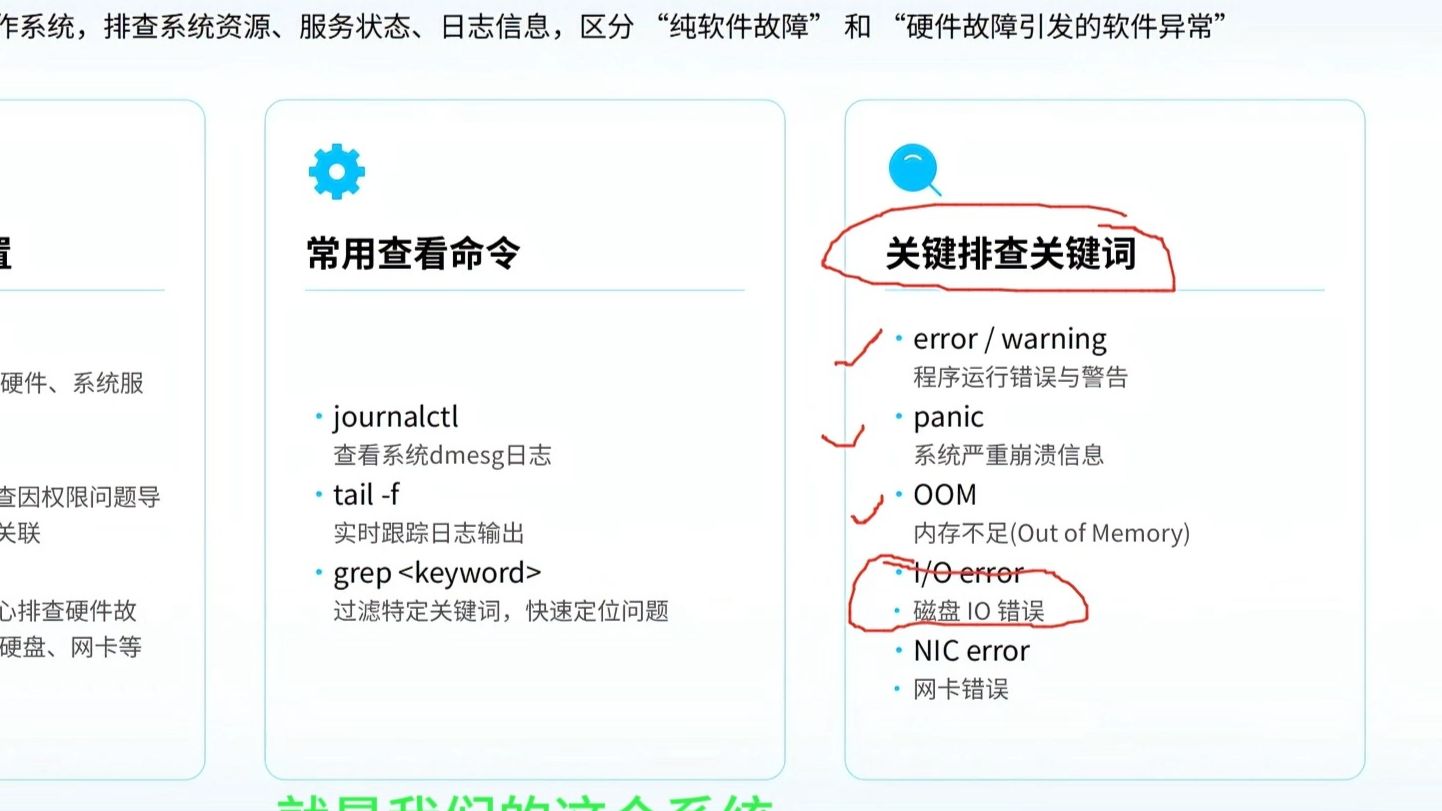
不要只盯单一指标,建立“负载三看”的判断方法:一看CPU负载趋势(15分钟窗口),二看磁盘I/O等待时间(io_wait是否超过CPU总计算时间的20%),三看网络重传率(TCP重传是否超过1%),三项中两项超标,即可判定服务器到达耐受临界点,此时扩容或优化是必要的,定期查看/var/log/messages中的内核报错,以及dmesg中有无OOM Killer记录,这些日志信息能提前发现隐藏的耐受风险。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/802210.html