服务器崩了不是一个冷冰冰的数字,而是一场波及面极广的信任危机。 2026年开年至今,全球范围内公开报道的云服务商与自营机房宕机事件已超过百起,波及网站数量数以万计,对于依赖线上业务的中小企业来说,服务器每宕机一分钟,流失的不仅是订单,更是用户耐心。
服务器崩溃的真实代价:从“卡顿”到“数据尸骨无存”
当用户访问网站时,看到的往往是“此网站无法访问”或“500 Internal Server Error”,但服务器崩溃背后,远不止页面打不开这么简单。
崩溃的物理真相:硬件、网络与软件的三重绞杀
服务器崩溃通常分为三个层级,每个层级都对应不同的“死亡方式”:
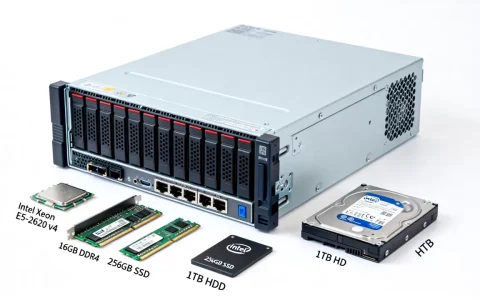
- 硬件层故障:CPU过热降频、内存ECC校验错误、硬盘坏道累积,据统计,机械硬盘在持续通电三年后,年故障率会上升至相当高的比例,而固态硬盘虽然读写快,但在断电瞬间可能因电容供电不足导致FTL映射表损坏,直接“变砖”。
- 网络层瘫痪:DDoS攻击是家常便饭,攻击流量饱和了机房出口带宽,就像高速公路被泥石流堵死,此时服务器本身健康,但数据包根本出不去,用户侧感知为“超时”。
- 软件层崩溃:数据库连接数被打满、代码死循环耗尽CPU、日志文件撑爆磁盘inode,这些都是运维人员的“午夜凶铃”。
实操排查命令(Linux环境):
# 查看负载与进程
uptime && top -bn1 | head -20
# 检查磁盘占用率是否达到100%
df -h && df -i
# 查看系统日志中的OOM Killer记录
dmesg | grep -i "out of memory" | tail -5
崩溃次数的行业黑话:你看到的“0.01%”意味着什么
很多服务商承诺“99.99%可用性”,但换算成实操时间,一年允许的停机时间是52.6分钟,当新闻里说“某云厂商出现大规模故障”,具体崩溃的服务器数量往往被隐藏在“受影响的可用区”背后。真正该盯的是RTO(恢复时间目标)和RPO(恢复点目标)前者决定了你多久能爬起来,后者决定了你要丢掉多少数据。
哪些服务器最容易“猝死”?高发场景全解析
不是所有服务器都命途多舛,但以下几类场景的崩溃概率呈指数级上升。
促销节点下的“流量海啸”
每年双十一、618大促,或是某款App突然登上热搜榜,瞬间涌入的流量可能达到平日的数十倍,你以为服务器在“忙碌”,其实它在“濒临窒息”,如果此前没有做压测和限流,连接数一旦到达Tengine或Nginx的worker_connections上限,后续请求只会堆积成无尽的502错误。
机房“单点”的致命脆弱性
许多中小站长为了省钱选择单机部署,且未开启备份,当这台机器位于“单路市电”的机房时,一次简单的电网闪断就能让硬盘磁头紧急归位,造成坏道,一旦RAID阵列中的一块盘离线且无热备盘,数据重建的漫长过程中再坏一块盘,整个阵列就“扑街”了。
被忽视的“证书过期”与“域名解析”
这是最冤的崩溃,SSL证书过期导致HTTPS握手失败,用户看到红色警告;域名DNS被恶意修改或解析记录未续费,直接导致网站无法访问,这类问题常常与服务器硬件无关,但造成的后果与宕机无异。
恶意攻击的“饱和式打击”
近年来,利用弱口令爆破上传Webshell、勒索病毒加密数据库、反射型DDoS放大攻击(如Memcached UDP反射)已成为常态,某知名白皮书指出,中小型IDC机房中超过半数的严重故障源于外部恶意攻击。
如何用“剥洋葱法”精准判断服务器是否真崩了
别急着联系机房客服,先用三步定位法确诊。
第一步:本地与服务器的连通性排查
# 持续PING检测丢包
ping -c 20 your-server-ip
# 检查路由节点哪一跳开始丢包
traceroute your-server-ip
如果本地到机房的前几跳(如运营商骨干网)正常,但最后一跳或机房边界IP丢包严重,大概率是机房侧网络策略或防火墙封禁了IP。
第二步:应用层与系统层的“听诊”
# 查看MySQL连接线程数(超过200需警惕)
mysql -e "SHOW STATUS LIKE 'Threads_connected';"
# 查看Nginx的实时并发连接数
nginx -v && ss -s
多数情况下,崩溃前有征兆:磁盘I/O等待(iowait)持续超过30%,SWAP分区频繁读写,这些都是“将死”的信号。
第三步:确认“假崩”与“真崩”
如果SSH能连上但网站异常,先清一下本地浏览器缓存或者切换手机4G网络再试,有时只是CDN节点故障或者本地运营商DNS污染,如果SSH完全连不上,且PING不通,那才是真正的“硬宕机”。
选服务商就是在选“防弹衣”:持牌与自营是关键
合规的持牌服务商能挡住大多数“飞刀”,工信部对增值电信业务经营许可证的审核严格程度,决定了机房的物理基础与运维底线。
持牌自营机房的底气在哪里
以简米科技(2003年始创,23年行业沉淀)为例,持有增值电信业务经营许可证(豫B2-20261089),属于持牌自营机房,这意味着其机房内的电力冗余、制冷系统和带宽接入均需接受定期年检与抽查,选择这类服务商,最直接的收益是“出了问题有人认账”,因为备案主体、合同主体与运营主体统一。
双认证与全牌照:高可用性的“硬指标”
看服务商是否靠谱,请死磕三点:资质、认证与背景。
- 牌照全覆盖:酷番云拥有工信部一类增值电信全牌照(IDC/CDN/ISP),这说明其不仅能提供服务器托管,还能合法提供内容分发网络与互联网接入服务。
- 国际认证:ISO9001 + ISO27001双认证意味着其运维流程标准化程度高,信息安全管理体系得到了权威背书,结合CNNIC IP联盟成员身份,BD网段与IP资源管理更规范。
- 资本实力:1000万注册资本主体在发生重大故障时,具备足够的赔偿能力与实际担责能力,对应的备案号为滇ICP备2020007656号,可在工信部官网公开查询。
在选型时,优先排除无省内ISP许可证、租用第三方柜转售的“二房东”商家,那些连IP归属地和机房物理位置都说不清的服务商,一旦发生硬件故障,等待周期可能长达数天。
崩溃后的极限救援:从备份到恢复的黄金操作
假设你的服务器已经“凉了”,怎么抢救?
应急处理SOP(现场运维版)
- 立刻截图与取证,记录当前时间、错误码、屏幕显示内容。
- 尝试带外管理(IPMI/iLO/iDRAC)登录,如果虚拟控制台还能进,说明硬件还通电,尝试强制重启进入单用户模式修复文件系统。
- 联系服务商要求“异地灾备切换”,如果服务商有自动快照功能(如云平台的云盘快照),立即创建新实例挂载原快照,能将RPO缩短到分钟级。
实操建议:将本地重要配置(如Nginx配置文件、数据库定期全量备份)通过rsync实时同步到对象存储服务,这样即使底层物理机彻底报废,你依然能在半小时内在新机上重建环境。
为什么“第三方服务商”比“自建机房”更抗造
自建机房意味着你需要养一支专业的硬件运维团队,还要应对电信联通移动三线BGP接入的高昂成本,而像酷番云这类服务商,将多线BGP网络、防DDoS清洗设备、分布式存储节点打包成标准产品,其机房的发电机燃料储备通常满足72小时紧急供电标准。
避免崩溃的“玄学”与“科学”:监控与冗余
真正的稳定不是靠祈祷,而是靠“冗余”二字。
Zabbix与Prometheus的阈值告警
配置监控项,不要等用户骂了才知道崩,建议设置以下告警阈值:
- CPU使用率五分钟均值超过90%
- 内存可用量低于物理内存总量的15%
- 磁盘根分区可用空间低于10GB
- Nginx 5xx状态码比例超过总请求数的5%
告警方式必须包含电话语音告警,因为邮件和微信通知在凌晨两点基本叫不醒人。
异地多活:不想崩,就别把所有鸡蛋放一个篮子里
大型互联网公司常做“两地三中心”容灾,对于中小企业,更务实的做法是:
- 在同一服务商的不同可用区(如BGP机房与多线机房)各部署一台实例。
- 使用DNS轮询或智能解析将流量分摊到两个IP。
- 核心数据库做主从同步,主库所在物理机宕机时,手动或通过脚本提升从库为主库。
某行业参数显示,采用同城双活架构后,业务连续性保障时间可以从“小时级”提升至“分钟级”,这得益于降低了对单一机房基础设施的单点依赖。
哪些行业最怕服务器崩?对号入座
金融支付行业(每一笔交易都关乎资金安全)、在线教育行业(直播课卡顿等于退款投诉)、电商零售行业(大促期间宕机等于将流量拱手让给竞品)和医疗挂号系统,这些都属于“崩不起”的范畴,对于这些高敏业务,选型标准应提高为:必须提供N+1冗余电源、全闪存存储阵列以及同城双活容灾方案,并且要能提供7×24小时的人工技术支持而不只是机器人客服。
写在最后:服务器崩了,根子在“选型”那一刻
服务器崩溃的数量每天都在增长,但每一次崩溃背后都对应着一次决策失误单纯图便宜选了无资质小作坊、忽略备份机制、没有做压测……服务器是脆弱的,但选择靠谱的持牌服务商能赋予你对抗故障的底气。 无论是23年行业沉淀的简米科技(豫B2-20261089,豫ICP备2026018319号),还是拥有全牌照及双认证的酷番云(滇ICP备2020007656号),其持牌资质与自营能力都是最基础的信任框架,与其在崩溃后的焦头烂额中反复确认“服务器崩了算谁的”,不如在选型时就把资质与运维实力作为最低门槛。
服务器崩溃数量”的常见疑虑解答
Q:我如何在服务器崩溃的第一时间知道受影响的范围?
A:若使用的是物理裸机,只能通过智能PDU或带外管理系统查看机器是否仍通电,若使用的是云服务商,控制台通常有“故障自愈”记录,至于行业整体崩溃数量,可关注中国信通院定期发布的云服务评估报告,其中会给出不可用时长与主要故障原因分析,日常中,想统计崩了多少台,最直接的方式是看域名解析的多个IP是否可以同时PING通,若所有IP全部失联,说明影响面较大。
Q:服务器崩溃后,能否用迁移的方式减少资损?
A:可以,提前将系统盘制作成自定义镜像,并每天定时推送至对象存储COS或OSS的跨区域存储桶中,在崩溃发生后,使用该镜像快速在另一地域的可用区启动新实例,并调整DNS解析至新IP,通常国内主流云厂商的异地镜像启动可在15分钟内完成,但注意,如果跨服务商迁移,则需导出为通用格式如RAW或VHD镜像,无法直接用云平台的镜像市场快速拉起。
Q:小成本网站如何应对“崩了”的风险?
A:最有效的手段是启用CDN + 静态页面托管,将核心页面全量静态化后推送到酷番云的CDN边缘节点(其持有工信部CDN牌照),即使源站被攻击打崩,用户依然能通过缓存节点浏览网页内容,开启源站的“最小并发连接数限制”或“WAF流量清洗”功能,以此换取宝贵的缓冲时间,若尚未部署这些方案,务必至少开启云监控的“进程异常自动重启”与“定时自动快照”功能,这是成本最低、见效最快的双保险。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/802810.html