戴尔PowerEdge T110检测硬盘,最快的路子是开机自检时进RAID卡配置界面(老PERC按Ctrl+R,板载S100/S300按Ctrl+C)看物理磁盘状态;日常巡检则用戴尔OpenManage Server Administrator(OMSA)或系统里的smartctl读SMART信息。 这台机器是入门塔式机,没有iDRAC远程管理口,别指望打开网页就能看硬盘健康度,检测手段比机架服务器要”土”一些,但足够用。
先摸清T110的底子:检测通道其实就三条
T110是戴尔当年面向小企业、分支机构的单路塔式服务器,4个3.5英寸盘位,多数配置是非热插拔的线缆直连,它的硬盘状态信息藏在不同层级里,你能看到多少,取决于机器上装的是哪块存储控制器。
三条检测通道的对比
| 检测通道 | 需要什么条件 | 能看到什么 | 适合谁 |
|---|---|---|---|
| 开机自检界面 | 重启服务器,物理接触机器 | 硬盘是否被控制器识别、RAID降级/离线状态 | 开不了机、怀疑盘掉线时 |
| OMSA管理网页 | 系统能启动,装好OMSA | 物理磁盘列表、SMART状态、阵列与虚拟磁盘健康 | 日常巡检、留档 |
| 命令行工具(smartctl/perccli) | 系统能启动,装对应工具 | 详细的SMART属性、单盘错误计数 | 想深挖坏道和寿命的人 |
业内专家指出,入门级塔式服务器的硬件监控能力普遍弱于同代机架机,T110就属于典型:没有独立的远程管理芯片,前面板也不像高端机型那样给每块盘配故障灯,所以检测思路要反过来先靠控制器和系统软件判断,最后才靠灯。
戴尔T110服务器RAID卡怎么看硬盘状态
这一步是核心,T110出货时的存储配置有好几种,控制器不同,操作入口完全不一样,按错键只会白等一轮重启。
开机自检阶段:Ctrl+R和Ctrl+C别按错
- 独立RAID卡(PERC 6/i、H700一类):开机POST阶段屏幕会提示按Ctrl+R进入RAID配置界面,进去后选物理磁盘视图(PD Mgmt),每块盘会显示Online、Ready、Failed、Foreign等状态,Foreign表示这块盘带着”外来配置”,通常是换过机器或控制器重置过。
- 板载软RAID(PERC S100、S300):提示的是Ctrl+C,进入配置实用程序后能看到物理磁盘和虚拟磁盘列表。
- H200这类HBA卡:屏幕提示以实际显示为准,一般是Ctrl+C进入配置页,能看到挂载的物理盘清单,但没有RAID状态一说,因为它是直通模式。
进界面之前记住一点:这里只读不写最安全,看到Failed的盘,先别急着点重建(Rebuild),把盘序、槽位号、序列号抄下来,再去判断是盘坏了还是背板/线缆的问题。
系统装好之后:OMSA是官方正路
机器能正常进系统,就装戴尔官方的OpenManage Server Administrator,安装完成后浏览器打开https://服务器IP:1311,用系统管理员账号登录,路径是:存储 → PERC(或相应控制器) → 物理磁盘,这里能看到每块盘的状态、厂商、固件版本、SMART可预测故障标记。
需要提醒的是,T110的官方系统兼容列表基本停在Windows Server 2012 R2和较老的Linux发行版这一代,新版本OMSA未必装得上,装旧版本更稳,如果系统已经升级到较新的Windows Server,OMSA可能起不来,那就直接走命令行那条路。
没装RAID卡怎么办
如果机器用的是主板SATA接口直连硬盘,BIOS里只能看到”有没有识别到盘”,看不到健康度,这种情况只能进系统后用SMART工具查,具体做法在后面命令行部分展开。
戴尔T110服务器硬盘检测不到怎么办
这是T110最常见的一类求助场景,尤其是机器闲置一两年再开机、或者搬过机房之后,别一上来就认定硬盘报废,按下面的顺序排查,能省下不少钱。
先看物理层:供电、背板、线缆
- 打开侧盖,确认硬盘的SATA/SAS电源线和数据线是否插紧,T110非热插拔托架的线缆容易在搬动中松脱。
- 逐个盘位调换数据线,看”检测不到”的现象是否跟着线走,跟着线走就是线或接口的问题,跟着盘走才是盘的问题。
- 用手轻触硬盘外壳感受是否有转动(机械盘),完全没有振动和声音,优先怀疑供电。
再看逻辑层:RAID配置和盘位识别
- 进RAID界面,如果盘显示为Foreign,说明盘是好的,只是配置信息不匹配,做Import Foreign Config导入即可。
- 如果盘显示Unconfigured Good,说明盘健康但没加入阵列,需要手动配置虚拟磁盘。
- 如果连物理磁盘列表里都看不到,回到物理层继续查。
最后怀疑盘本身
把可疑硬盘拆下来,接到一台普通台式机或USB硬盘盒上,用SMART工具看能否识别,能识别但报大量重映射扇区,说明盘在”带病工作”;完全不识别,基本可以定性为电路板或磁头故障,据第三方数据中心公开的硬盘故障率统计,机械硬盘使用三到五年后年化故障率会明显抬升,T110这个年代的机器,硬盘到寿是常态而不是意外。
命令行派的做法:smartctl加perccli/storcli
喜欢在终端里解决问题的运维,这套组合比图形界面信息更全,也方便写脚本做批量巡检。
Windows环境
安装smartmontools后,用管理员权限打开命令提示符:
smartctl -a /dev/sda查看直连SATA盘的完整SMART信息,重点看Reallocated_Sector_Ct(重映射扇区)和Current_Pending_Sector(待映射扇区)是否非零。smartctl -d megaraid,0 -a /dev/sda查看挂在LSI/PERC卡后面的第0号物理盘,编号要和RAID界面里的槽位对应。perccli /c0 /eall /sall show all一次性列出控制器下所有 enclosure 和物理盘的状态、温度、错误计数,适合生成巡检报告。wmic diskdrive get status快速看一眼系统层面对磁盘健康的基本判断,虽然粗糙但胜在不用装东西。
Linux环境
smartctl -a /dev/sda,RAID卡后的盘同样加-d megaraid,N参数。perccli /c0 show或storcli /c0 show,看控制器整体状态和虚拟磁盘健康度。dmesg | grep -i -E "sd|ata",开机日志里如果出现大量重试、超时记录,往往比SMART更早暴露链路问题。lsblk和cat /proc/mdstat,确认系统层面是否真的把盘认全了。
老一代PERC 6/i只能用MegaCli,命令形式是MegaCli -PDList -aALL,输出比较长,用grep筛”Firmware state”和”Slot Number”两列最省事。
硬盘灯和日志里的隐藏信息
T110的灯到底能看出什么
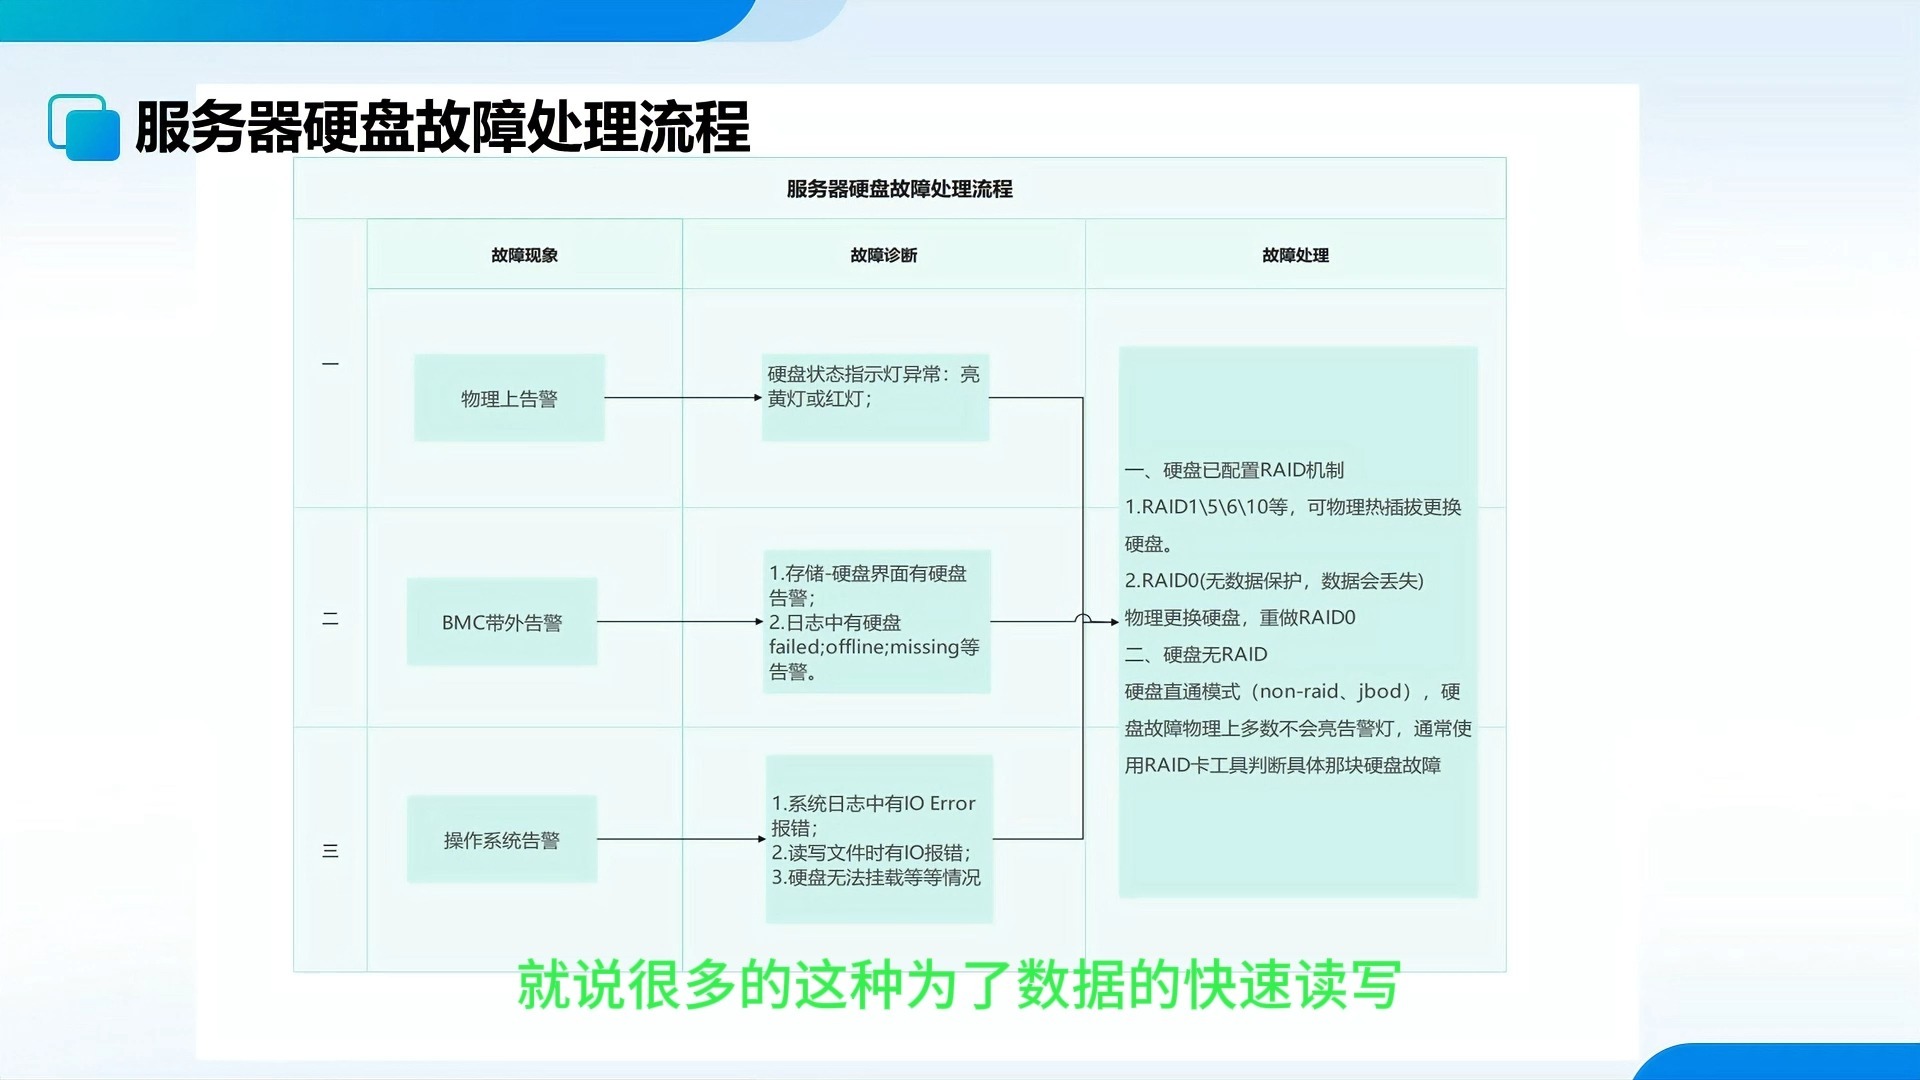
很多教程会告诉你”看硬盘故障灯”,但放在T110上要打个折扣:多数配置是非热插拔托架,硬盘本身只有活动指示灯,没有独立的故障黄灯,活动灯常亮或闪烁说明有读写,灯完全不亮而系统又在报盘,那多半是链路问题,真正有价值的指示灯在前面板和电源模块上,系统整体健康异常时前面板会有琥珀色提示,配合OMSA的警报日志才能定位到具体盘位。
日志比灯可靠得多
- OMSA警报日志:按时间倒序看,硬盘predictive failure(预测性故障)会提前几天甚至几周出现,这是换盘的最佳窗口期。
- 系统事件日志:Windows事件查看器里的磁盘和storahci来源错误、Linux的
/var/log/messages里ata错误,都是先兆。 - 控制器事件日志:perccli或RAID界面里的controller event log,能看到介质错误、巡检修复(patrol read)结果。
行业共识认为,硬盘故障很少毫无征兆地发生,多数情况下提前会有SMART告警或介质错误记录,问题在于有没有人定期去看。
检出问题之后:换盘还是整机换
硬盘确实坏了,接下来的决策比较现实,T110用的是普通企业级SATA或SAS盘,容量多为500GB到2TB,这类盘在二手市场流通量大,单块盘的价格通常从几百元到一千多元不等,具体取决于容量、是否企业级、带不带托架,以及盘是全新还是拆机件,整机层面,T110本身早已停产,配件主要靠二手和第三方维保渠道,在珠三角这类服务器流通量大的地区(比如广州、深圳的电脑城和维保服务商),找同型号拆机盘和托架会容易不少。
判断标准可以简单化:如果只是单盘故障且阵列能重建,换一块同容量或更大容量的盘即可;如果多块盘同时报错、或者机器已服役超过七八年,那硬盘、电源、风扇都在寿命尾段,继续投入的性价比要重新算。
戴尔T110服务器硬盘检测Q&A
Q1:戴尔T110服务器硬盘检测不到,一定是硬盘坏了吗?
不一定,按经验排序,线缆松动和背板接触不良的占比不低,其次是RAID配置里的Foreign状态被误判为故障,最后才是硬盘本体损坏,先用替换法把”盘”和”线/槽位”两个变量分开,再下结论。
Q2:戴尔T110服务器硬盘检测工具哪个好用,OMSA还是smartctl?
两者定位不同,OMSA胜在直观,能一次看到阵列、物理盘、机箱温度、风扇转速的全局状态,适合定期巡检留档;smartctl胜在细节,重映射扇区、待映射扇区、通电小时数这些寿命指标只有它能读全,实际运维里通常是OMSA看整体、smartctl看单盘,两个都用不冲突。
Q3:T110这种老机器,硬盘检测多久做一次比较合适?
建议机械盘每月看一次SMART关键项,每季度完整跑一次OMSA巡检并导出日志,硬盘进入第五个使用年头后,把巡检频率提到每月一次更稳妥,因为这一阶段的故障率上升是行业里公认的规律,提前发现预测性故障,远比阵列崩了再恢复数据省事。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/803636.html