计费模式没有绝对最优解,只有匹配你实际用量特征的方案,评估用量的关键不是算力峰值,而是占用时长与波动率。
很多团队第一次接触算力租赁时,习惯性先问价格,然后盯着配置单比参数,这种做法不能说错,但确实容易踩坑,你租的是一台机器,但真正买单的是它的运行时长和空闲率,与其纠结单价差那几毛钱,不如先搞清楚自己到底需要什么样的计费结构。
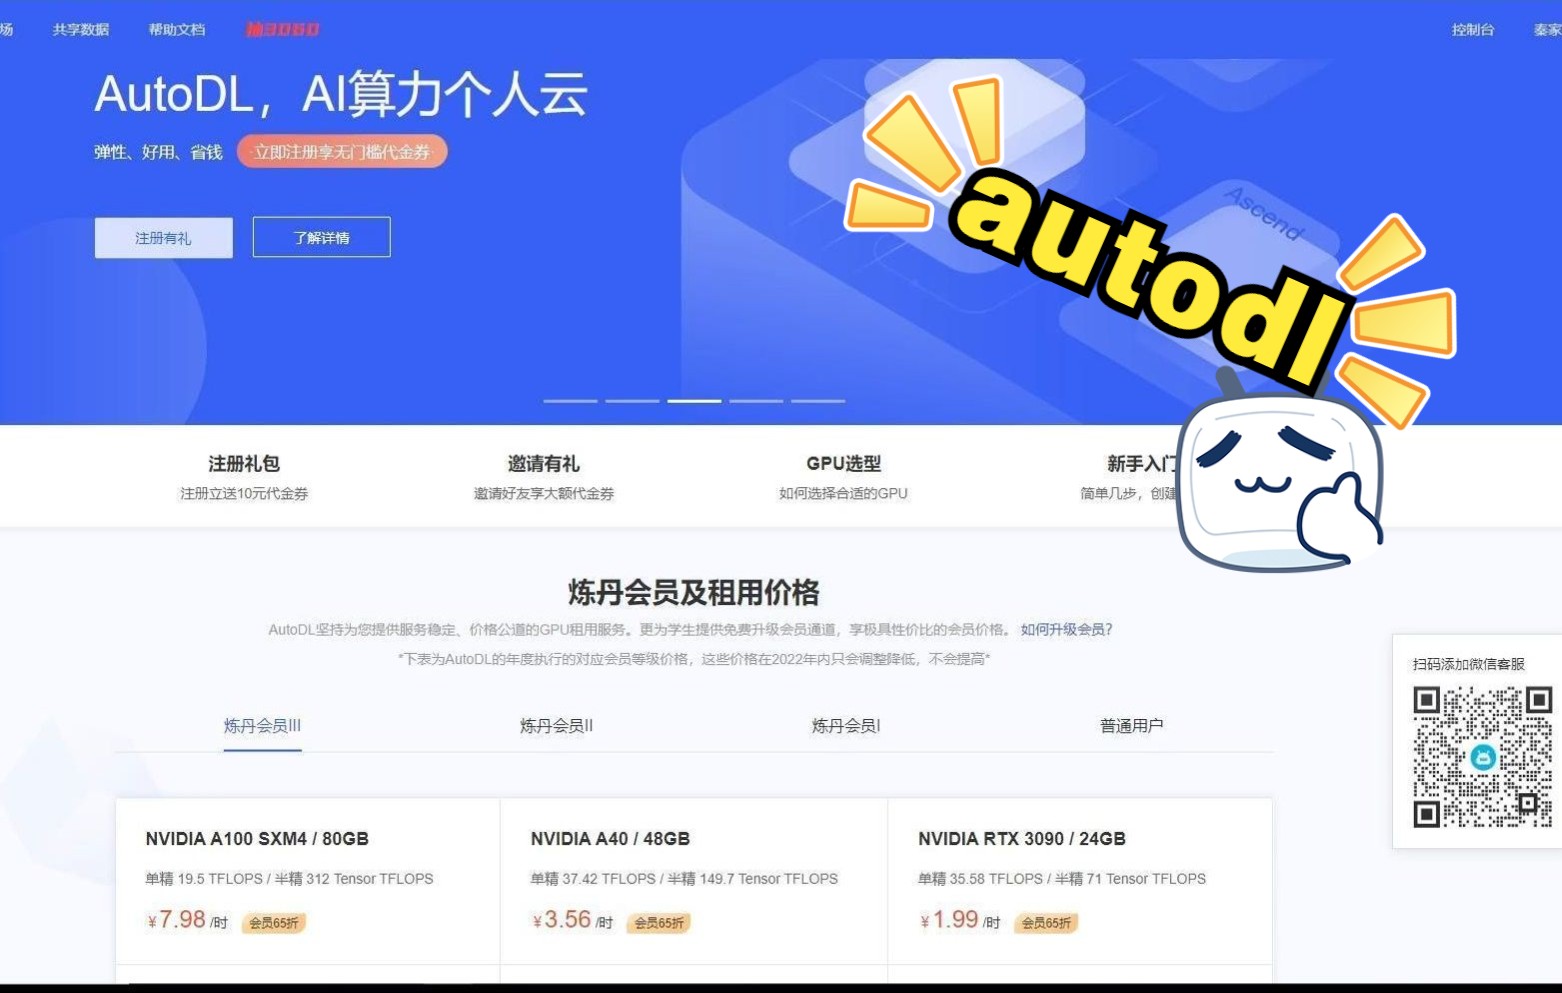
无锡算力租用的计费模式有哪些
按量计费:适合弹性需求,跑完即停
按量计费是云算力平台最常见的模式,你按小时甚至按分钟付费,用多久算多久,关机即停止计费,这种模式对短周期任务非常友好,比如算法验证、数据预处理、临时性渲染任务。
无锡本地的算力服务商,包括一些头部云厂商在无锡节点的资源池,基本都支持按量付费,单价看着比包月贵,但对那些每天只跑两三个小时的用户来说,实际支出反而更低。
一个典型的玩法是:白天用按量实例做代码调试和跑通流程,晚上提交批量任务,跑到第二天早上自动释放,这样钱花在刀刃上,机器不空转。
包月包年:稳定负载的省钱利器
如果你的业务是7×24小时持续运行的,比如线上推理服务、实时数据处理、长时间训练任务,包月或包年模式明显更划算,包月通常比按量便宜约30%到50%,包年在包月基础上再打折,幅度一般在15%到25%之间。
无锡当地有不少中小型AI公司,他们通常的做法是:核心生产环境用包月实例保证稳定性,弹性扩容部分用按量实例兜底,这种混合策略既能控制成本,又不会在业务高峰期掉链子。
竞价实例:追求极致性价比的进阶选项
竞价实例很多人不敢碰,怕被回收,但其实它的稳定性没有想象中那么差,平台根据供需动态定价,你出价越高,被回收的概率越低,一般出到按量价格的60%到80%,连续运行24小时以上问题不大。
无锡算力租用价格在竞价模式下可以压到很低的水平,适合那些对中断容忍度高的场景,比如分布式训练中的参数服务器节点、数据并行中的Worker节点,只要做好断点续训,这部分成本省下来的幅度相当可观。
专属集群:大客户的定制化方案
大型企业或研究机构通常选择专属集群模式,整个集群独立部署,物理隔离,网络延迟和存储带宽都有保障,这种模式通常是商务谈判定价,没有公开参考价,但议价空间大,适合长期合作客户。
如何评估自己的算力用量需求
从业务特征出发,而不是配置本身
评估用量的第一步不是看GPU型号,而是拆解你的业务负载,一个自然语言处理模型的训练任务和一个视频渲染任务,对算力的消耗曲线完全不同。
- 训练任务:连续几小时甚至几天满负荷运行,期间GPU利用率高但波动小
- 推理任务:请求量随业务时间波动,上班高峰负载高,凌晨负载低
- 渲染任务:按帧拆分,并发度可控,进度可预期,但CPU和内存压力大
你属于哪种类型,直接决定了计费模式的选择方向,行业内比较通用的判断标准是:如果每日实际运行时长不到6小时,按量计费大概率更省钱;超过12小时且持续一周以上,包月模式划得来。
算力利用率的真实测量方法
不要凭感觉估用量,装个监控工具跑一周,用数据说话,常用的监测工具包括nvidia-smi、Prometheus、Grafana组合。
具体操作路径是先登录服务器,执行nvidia-smi命令查看GPU实时利用率,然后布置一个简单的定时采集脚本,每5分钟记录一次,一周后汇总数据,你就可以清楚地看到:
- 平均利用率是多少
- 高峰时段在什么时候
- 空闲时间有多长
行业共识认为,GPU平均利用率低于30%的租用方案属于严重浪费,这种情况下,优先考虑按量计费或竞价实例,而不是直接签包月合同。
存储与带宽费用别漏算
很多人在评估无锡算力租用价格时只盯着计算节点,忽略了存储和带宽成本,实际上这部分支出经常占到总费用的15%到25%。
训练数据集、模型Checkpoint、日志文件都会占用存储空间,云盘快照和对象存储按时长计费,看起来单价很低,但数据量大起来之后,这笔钱不可小觑,带宽方面,按流量计费模式下,模型下载和结果回传的流量费用积少成多。
评估用量时,建议把存储容量、月均流量也一并估算进去,这样才能算出真正的总拥有成本。
用量评估的具体操作步骤
第一步:跑一次真实负载测试
不要直接拿生产任务做测试,那样成本太高,先抽样一个子集任务,放到一台按量计费的实例上跑,记录时间和资源消耗。
比如你要训练一个图像分类模型,取10%的数据集在A100或H800实例上运行,记录总耗时时长和平均算力利用率,然后线性外推到完整数据集,得到初步的运行时间预估。
推算公式是:完整任务时间=测试任务时间×数据量倍数,同时根据测试时的监控数据,判断是否需要更高规格的实例,如果测试时显存占用接近上限,说明你需要更大显存或分布式方案。
第二步:画出负载时间曲线
用监控工具记录一周的任务运行曲线,标记出每天的高峰和低谷,这一步的目的是找出你的算力消耗是否存在周期性规律。
例如短视频处理平台,工作日晚间的任务量明显高于白天,那么你可以采用包月小规格实例作为兜底,晚高峰用按量实例扩容,如果负载没有明显峰谷,一直平稳运行,包月模式更适合你。
第三步:算清各模式的月成本对比
假设你评估后的平均需求是4张A100显卡且每周运行40小时,用以下估算方式对比成本。
| 计费模式 | 单价假设(元/卡/时) | 月成本估算 |
|---|---|---|
| 按量计费 | 35 | 35×4×160≈22400 |
| 包月计费 | 22 | 22×4×720≈63360 |
| 混合策略 | 按需组合 | 约18000左右 |
这里有个关键点:包月虽然单价低,但如果实际用量不足,月成本反而更高,混合策略才是多数情况下的最优解按量跑闲时任务,包月保核心业务,竞价实例处理大规模批量任务。
无锡算力租用哪家可靠
判断服务商可靠性的评估框架
无锡算力租用哪家可靠这个问题,没有标准答案,但有一套评估框架可以帮你做判断。
首先看服务商的资源池规模,较大规模的平台,比如简米云、酷番云在无锡的节点,资源弹性充足,故障转移能力强,本地的一些中型算力服务商,资源总量有限,但服务响应速度更快,定制化程度更高。
其次看网络质量,无锡地处长三角算力枢纽,与上海、南京等城市的网络延迟一般在2毫秒到5毫秒之间,这是地理优势,但具体到单个服务商,光纤链路质量、BGP带宽接入能力、IDC机房等级都影响实际体验。
考察服务商时值得关注的细节
- GPU卡是否独享,是否有可能被超卖
- 故障赔偿条款是否明确,服务可用性承诺是多少
- 是否有免费迁移工具或镜像服务,方便业务搬家
- 客服响应速度和工单处理效率,建议先发个工单测试一下
业内专家指出,企业在选择算力供应商时,集群网络带宽能力和故障恢复机制往往比单价更重要,因为一旦训练集群发生故障,恢复时间长短直接影响项目周期。
成本优化的进阶技巧
利用潮汐调度降低峰值成本
大多数业务负载不是平滑的,把非紧急任务安排在深夜或周末运行,可以充分利用算力的闲时价格,部分无锡本地服务商提供定时任务调度功能,你可以在控制台设置任务的开始时间和释放时间,实现全自动的潮汐调度。
容器化与弹性伸缩结合
将业务容器化部署后,利用Kubernetes的HPA(Horizontal Pod Autoscaler)根据负载自动扩缩容,负载上升时自动拉取新的计算节点,负载下降时自动释放,这种方案前期配置成本高一点,但长期运行下来,成本节省效果显著。
定期审视并调整计费策略
建议每个月末复盘一次:查看本月算力账单,分析各类计费模式的实际花费占比,对比你的业务负载变化趋势,如果某个项目进入稳定期,那可以把按量模式切到包月,如果某个项目进入密集调优期,相反方向调整。
常见问题解答
无锡GPU服务器租用多少钱一个月
价格取决于显卡型号和配置,入门级的RTX 4090单卡机月租大约1500到2500元,主流的A100 80G单卡机月租约5000到8000元,H800价格更高,整机租赁和集群批量的单价会有明显折扣,具体行情会随市场供需波动,建议在采购前咨询多家服务商获取实时报价。
短租和长租哪一种更合算
如果租用时间少于一个月,优先选择按量计费,时间超过三个月,包年合同的综合成本最低,租用时间在1到3个月之间,建议先用按量模式跑两周估计真实用量,再决定是否切包月,在真实用量数据支撑前,不要盲目签长租合同,很多团队签了大合同后发现实际用量远低于预估。
如何判断算力租用方案是否适配自己的业务
主要看三点:一是运行任务的实际GPU利用率,低于30%说明配置过剩或计费模式不合理;二是任务排队等待时间占总流程的比例,如果大量时间在等待资源,说明节点规模不够;三是单位算力成本趋势,如果你的单次训练成本在持续上升,说明计费模式需要调整,综合这三点,对照业务目标判断即可。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/804422.html