苏州药企做分子模拟选GPU服务器,核心结论是:优先锁定NVIDIA A800/H800,显存不低于40GB,同时必须根据具体模拟软件(如Amber、GROMACS、OpenMM)的官方测试数据反向匹配CPU、内存与卡数。
苏州药企分子模拟GPU服务器怎么选:先看算力需求的特殊性
药企的分子模拟和高校科研课题组不一样,每天跑的任务类型更集中,但容错率极低,苏州作为生物医药产业重镇,园区内做小分子药物设计的Biotech公司,几乎都在跑同一种循环:先做靶点蛋白的同源建模,再跑分子动力学平衡,最后做自由能微扰计算,这三个步骤对GPU的胃口完全不同。
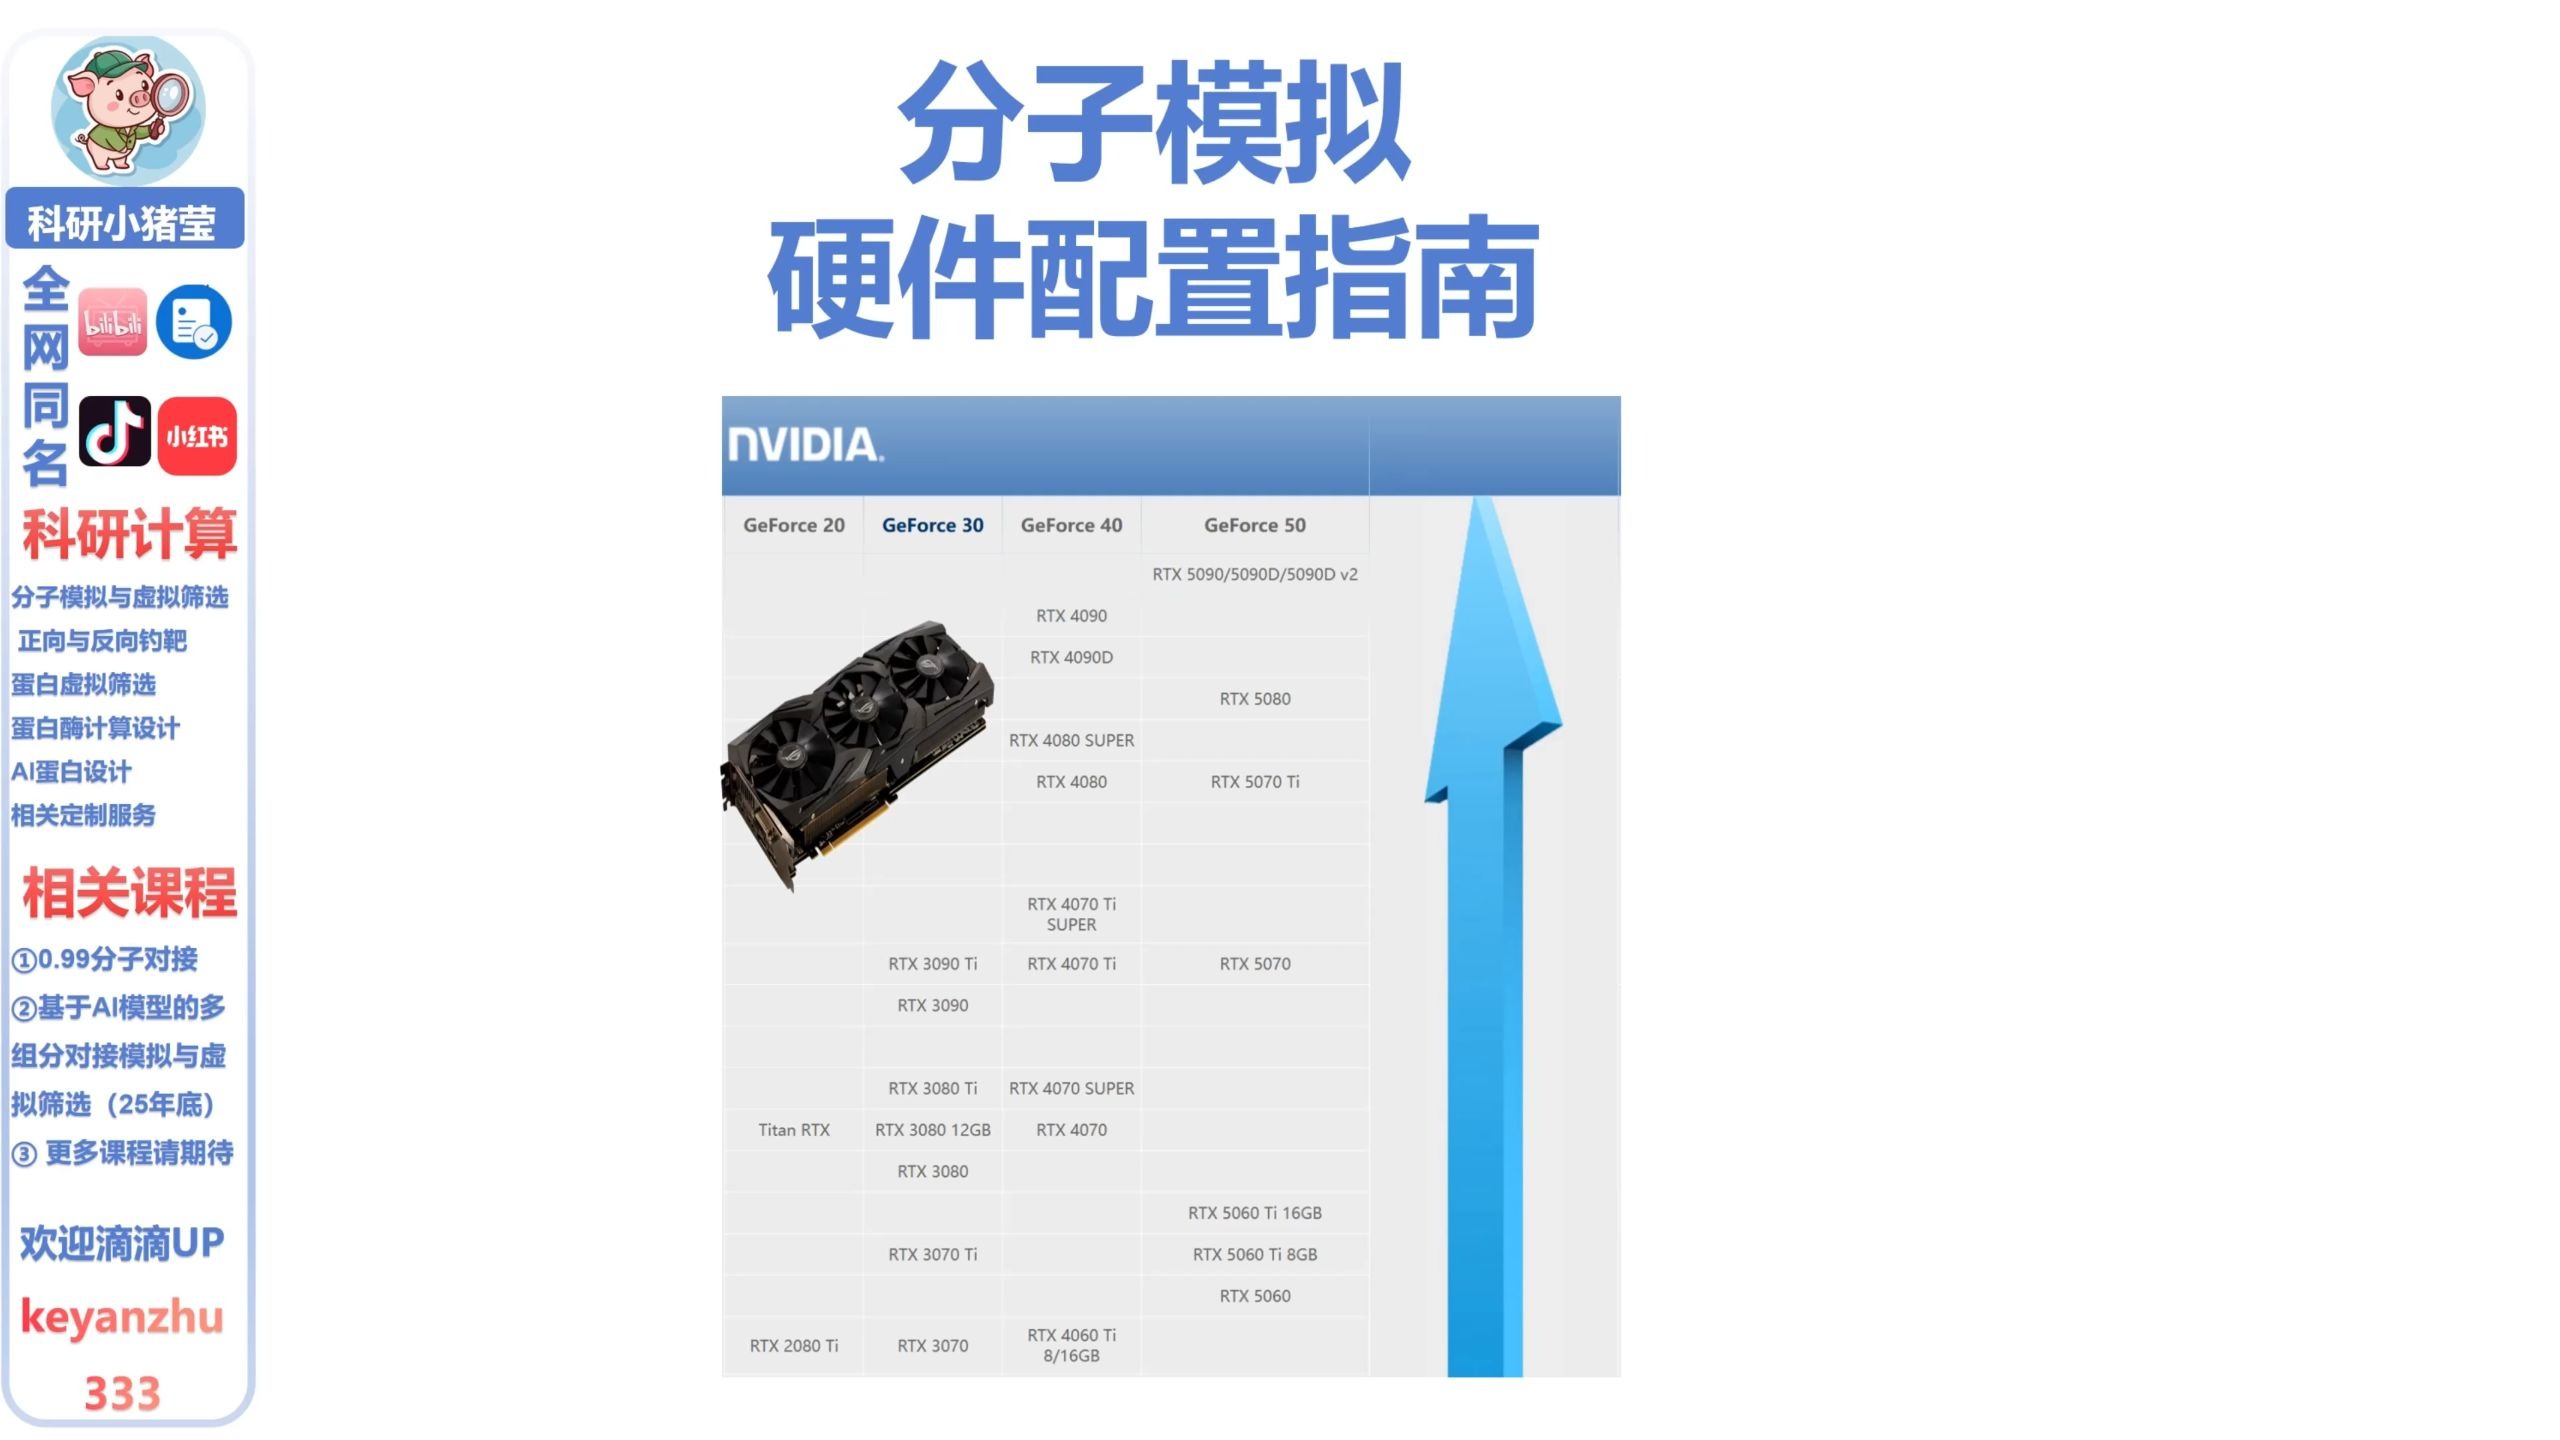
分子动力学模拟吃的是双精度与显存带宽
GROMACS和Amber这类经典分子动力学软件,是苏州药企最常用的工具,它们对GPU的利用有几个硬指标:
- 双精度浮点性能不能太弱,行业共识认为,做自由能微扰计算时,如果GPU单精度算力虚高但双精度缺失,计算结果在长时间尺度上会出现漂移,NVIDIA的A800双精度峰值约为9.7 TFLOPS,这比消费级RTX 4090的0.1 TFLOPS高出近两个数量级。
- 显存带宽决定模拟速度,一个包含约10万原子的体系,每纳秒模拟会占用几GB显存,A800的HBM2e显存带宽约2TB/s,而RTX 4090的GDDR6X带宽约1TB/s,五年前苏州园区某药企曾用8张RTX 3090跑FEP计算,结果发现吞吐量反而比4张A100低了约30%,原因就是显存带宽卡脖子。
虚拟筛选与AlphaFold类任务更依赖显存容量
如果你是做激酶抑制剂或PROTAC的,会经常跑大规模虚拟筛选,此时GPU显存容量直接决定单批次能塞进多少分子构象,80GB显存的A800可以一次并行处理约2000个配体的小规模对接;如果降到40GB,就得拆成两批,多出的I/O等待时间在长流程中很吃亏。
苏州药企挑选GPU服务器的三类场景与四个硬指标
针对苏州本地药企的不同规模,选型逻辑完全不同,初创Biotech、CRO服务公司、已上市Pharma的预算和使用模式差异极大。
初创团队(预算低于30万)
团队可能就5-8个计算化学家,主要用Amber跑几个热门靶点的MD模拟,此时不必盲目追A800。两张RTX 4090组一个小集群是性价比极高的起步方案,前提是只做单精度为主的用途,或者明确知道自己在跑的是粗粒化模拟,但要注意,如果将来计划做FEP或需要复现论文里用A100跑的数据,4090的驱动和CUDA兼容性在部分科研软件上会报错。
成长型CRO(预算约50万-120万)
帮药企做外包计算服务,可靠性排在第一位,业内专家指出,当客户看你计算报告时,会直接问“用的什么GPU跑的”,A800/H800是默认的信任背书。建议选用2-4张A800(80GB)搭配双路Intel Xeon Platinum 8480+ CPU,CPU核心数量不能省,因为GROMACS在并行效率上严重依赖CPU与GPU之间的负载平衡。
成熟Pharma(预算150万以上)
需要同时支撑MD、FEP、虚拟筛选、反向找靶等多个流程,通常一步到位上8卡A800/H800节点,并且预留NVLink桥接,NVLink的点对点通信带宽是600GB/s,远超PCIe 5.0的128GB/s,做大规模自由能微扰时,数据交互频繁,不桥接会导致GPU空转。
四个硬指标逐一对照
| 指标 | A800 80GB | RTX 4090 | 性价比分析 |
|---|---|---|---|
| 双精度算力 | 约9.7 TFLOPS | 约0.1 TFLOPS | 做FEP必备 |
| 显存带宽 | 约2 TB/s | 约1 TB/s | 影响MD跑速 |
| 显存容量 | 80GB | 24GB | 影响批量任务量 |
| 软件官方支持 | 几乎所有分子模拟软件都官方支持 | 部分软件不支持或需要补丁 | 验证成本高 |
苏州药企专用GPU服务器的软件生态匹配
硬件参数可以查表,但真正决定药企体验的是软件适配,在苏州几个生物医药产业园里,计算化学工程师之间流传一句话:“卡买得再好,跑不起Amber照样白搭。”
分子动力学模拟的硬性依赖
看看苏州药企最常用的三个软件在GPU上的表现差异,能帮你避开很多坑:
- GROMACS:通过OpenMM和GPU加速效果极好,但和所有模拟软件一样,它在消费级显卡上存在“隐性限制”官方在较新的版本中只对CUDA计算能力达到8.0的卡做全功能验证,RTX 4080/4090没问题,但部分旧款的A系列在特定PME算法上会静默失败。
- NAMD:对双精度要求极高,用RTX 4090跑NAMD,会因双精度被严重裁剪而报错。A800跑NAMD的经典James实验体系,比纯CPU节点快约10倍。
- OpenMM:最灵活但也要看CUDA版本,如果你在Ubuntu 20.04上装OpenMM,配A800驱动需要CUDA 11.8以上,但某些老代码在11.6下编译更好,这种细节问题在实际部署时最耗费时间。
深度学习与分子模拟混合场景
如今很多苏州药企在做分子生成模型或ADMET预测时,也需要用到Transformer架构,但GPU在分子模拟和深度学习之间,不只是加速卡,还承担着不同的任务模型。建议药企在采购时直接问供应商“这卡能跑PyTorch和GROMACS双场景吗”,通常A800/H800是两者通吃的,而如果团队常借助云上的API做蛋白结构预测,本地GPU反而不是关键。
苏州药企GPU服务器的采购路径与价格参照
药企采购和买游戏电脑不同,要的是稳定性和可追溯的验收标准,在苏州本地,最稳妥的办法是先确定渠道,再谈配置。
采购前先做三个优先级排序
- 第一,明确你未来12个月内要跑的最大的体系是多大? 比如一个膜蛋白加配体大概会有20万原子,如果这是终点,那4卡A800就足够,如果是想朝细胞尺度模拟前进,得考虑48GB以上显存的卡,这会影响预算。
- 第二,确认软件许可是否绑定硬件。 有些分子模拟软件的许可证按节点收费,如果一个节点有两颗CPU和八块GPU,价格会上升一个量级,把软件和硬件一起列入采购清单,往往能省更多。
- 第三,充分考虑散热与功耗的TCO成本。 A800的最大功耗是400W,4张卡满载加上CPU整机功耗大约在3.5kW,苏州厂房或写字楼的数据机房自然冷却条件有限,液冷是更靠谱的选择,一个常见的计算误区是,很多药企觉得“买卡贵,电费便宜”,但实际上在38℃的高温天,因散热压不住导致的GPU降频损失,远比电费更昂贵。
苏州本地服务商是否能做定制?
在苏州昆山、工业园区聚集了不少服务器OEM厂商,他们提供的GPU服务器价格通常会比戴尔、浪潮等原厂便宜10%-15%,但在BIOS和散热设计上存在差异。建议采购时要求供应商提供至少10家药企客户的装机验证案例,尤其要看他们是否测试过Amber的全流程,如果可能,直接在园区约一次上门测试,用你自己的蛋白体系跑24小时,看温度稳定性和功耗曲线,苏州本地的快速响应和上门服务,是外地采购相比而言的明显短板。
至于GPU服务器价格,近年来市场波动较大,A800整机(4卡)的市场均价大致在45万-70万区间,H800更高,如果是采购整机,可以从以下三个维度来压价:
- 问清楚是否包含三年上门服务与快速更换备件;
- 问清楚散热方案是风冷还是液冷,液冷整机的成本增加约3万-5万。
- 问清楚是否提供高性能并行文件系统的搭建设计,因为分子模拟的轨迹文件往往很大,本地计算节点和存储节点之间的网络带宽决定了写盘速度。
苏州药企GPU服务器怎么挑的最终建议
如果只能给一条结论,那就是不要先看价格,先看你要跑的软件在目标GPU上的实测性能,在苏州买GPU服务器,多花一点时间做预处理,比急着买来吃灰强得多,苏州园区有大量做药物计算的公司,你可以通过同行直接问到最真实的跑分数据,比看任何厂商的白皮书都靠谱。
关于苏州药企选GPU服务器的常见问题
苏州药企做分子模拟,GPU服务器预算大概多少?
预算主要取决于你要跑什么业务,一张A800 80GB显卡市场价约十二三万,一台2卡的主机加上高速存储和网络,总价在30万-40万之间,如果只是做小型的短时程动力学模拟,一张RTX 4090的整机五六万块就能起步,但长远看,做药物研发的确定性,比省下的预算更重要。
为什么苏州药企做分子模拟时,显卡选型不能只看显存大小?
因为分子模拟的瓶颈常常不只是“显存能装下多少数据”,而是计算精度和软件适配性,消费级显卡虽然显存也能做到32GB以上,但双精度峰值和ECC显存纠错能力的缺失,会导致长时间模拟出现误差积累,这不是显存容量能解决的。
苏州药企有必要上H800或A800这类高端显卡吗?
如果团队已经验证了主要工作负载能在消费级显卡上跑通,预算也有限,可以先用RTX 4090,但只要涉及到FEP、自由能微扰、需要发高档次论文或向药监局提交计算报告的场景,A800/H800几乎成了行业底线。说白了,计算结果的权威性依赖于硬件的专业程度,这就直接决定了GPU服务器怎么选才不踩坑。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/804651.html