在南京租用AI算力时,训练任务拼的是GPU集群的带宽与显存吞吐,推理任务拼的是单卡延迟与成本控制,这两者从计量方式到硬件选型几乎完全相反。如果你正打算在南京本地或周边机房部署AI业务,先把训练和推理的算力租用逻辑掰开看,能省下不少冤枉钱。
为什么训练和推理的算力租用逻辑完全相反
训练和推理对算力的消耗模式本质不同,导致租用方案必须分开设计。训练任务是“暴力计算”,一张A100显卡跑到100%利用率是常态,模型参数在数千张卡之间反复同步,网络带宽和卡间互联速度直接决定训练效率。推理任务是“精细服务”,每一次请求只触发一次前向传播,显存占用波动大,GPU利用率往往不足三成,真正比拼的是单次响应的延迟和单位请求的处理成本。
这句话说起来简单,实际去南京的算力租赁市场问一圈就会发现,服务商给的报价方案往往“偏爱训练”:集中在A100、H800这类高端卡,按整卡月租计费,这套方案挪到推理场景,成本立刻失控,南京本地一家做NLP应用的初创团队踩过这个坑,租了8张A100跑线上客服机器人,高峰期GPU利用率不到15%,每月光算力成本就烧掉六位数,后来换成A10推理卡配合按量计费,开销降了一半还多。
训练与推理的租用成本计量差异
训练任务:按卡时计费,闲置即浪费
训练算力租赁通常按“卡时”(单张GPU运行一小时)计费,这个计量方式的潜台词是:你得为GPU的空转时间买单,训练过程中频繁的调试、数据加载、断点续训,都会产生“无效卡时”,南京不少高校实验室和图计算企业对此深有体会,租了整月A100,实际有效训练时间可能只有六成。
业内专家指出,训练算力租赁更适合采用整机柜或整节点租用模式,把H800或A800以8卡为单位打包出租,附带高带宽RDMA网络,这种模式下,单位算力成本反而更低,因为服务商不用承担碎片化调度的压力。
推理任务:按调用量计费,主打弹性伸缩
推理算力的计费模型截然不同,公有云厂商普遍采用按API调用次数或按推理时长计费,例如每千次调用0.5元到3元不等,部分服务商还支持按GB秒(显存占用×时间)计费,这种计量方式天然适合流量波动的线上业务白天高峰多租几张卡,凌晨低谷缩到零。
南京本地运营游戏AI对战机器人的团队,最懂这个逻辑,他们的用户在线高峰期在晚上8点到11点,深夜里调用量骤降,如果用整卡月租方案,夜间闲置成本全要自己扛,换成按量付费的推理实例后,账单直接跟业务量挂钩,游戏淡季的算力成本能压到旺季的三分之一。
核心价格差异对比
| 维度 | 训练(整卡月租) | 推理(按量计费) |
|---|---|---|
| 计费单位 | 元/卡/月 | 元/千次调用或元/GB秒 |
| 典型GPU | A100/H800 | A10/L4/T4 |
| 月成本范围 | 数千至数万元/卡 | 几十至几千元 |
| 闲置成本 | 租用方全担 | 服务商担(池化调度) |
| 适用场景 | 大模型预训练/微调 | 线上API服务/实时推理 |
南京AI算力租用价格差异的现实情况
南京GPU服务器租用价格对比
南京的GPU租赁市场正处于价格分化期,简米云、酷番云在南京有可用区,提供标准化的GPU云服务器报价;本地小型算力服务商则靠低价和灵活租期吸引客户,以单张A100 80G为例,南京区域主流云厂商的包月价格在5万到4万元区间,本地服务商可能压到1.8万元上下,但通常绑定整年合约或要求一次性付清。
推理场景的定价更散,华为云在南京推出的推理专用实例,按秒计费的价格约为训练实例的40%到60%;一些小平台甚至打出“9毛钱一小时”的T4卡价格,吸引短视频审核、图像处理类企业,这类低价卡的稳定性需要仔细考察,签合同前务必确认续租条款和故障赔付标准。
南京AI算力租用哪家好,不是只看单价就能定的事,有家企业从本地服务商租了T4卡跑OCR识别,高峰时段出现推理延迟抖动,同行用同款卡在云厂商上跑,P99延迟稳定在150毫秒以内,线下服务商和云厂商的差距往往在SLA保障和运维响应速度上。
地域价差不可忽视
南京相比一线城市,算力租赁价格有天然优势,据行业统计,同一型号GPU在南京的租用价格比北京、上海低10%到20%,大约相当于价格锚点低了一线城市一个档位,原因是南京的IDC机房电价和用地成本更低,本地服务商运营压力小,能把价格让给客户。
不过便宜不白占便宜,南京本地的算力资源以推理卡为主,高端训练卡(A100/H800)的保有量远远比不上北上广深,如果你要在南京本地租8卡H800整机做大模型预训练,大概率要排队等货,或者转向苏州、无锡的机房。
硬件选型:训练与推理的配置逻辑差异
训练场景:堆显存、堆带宽
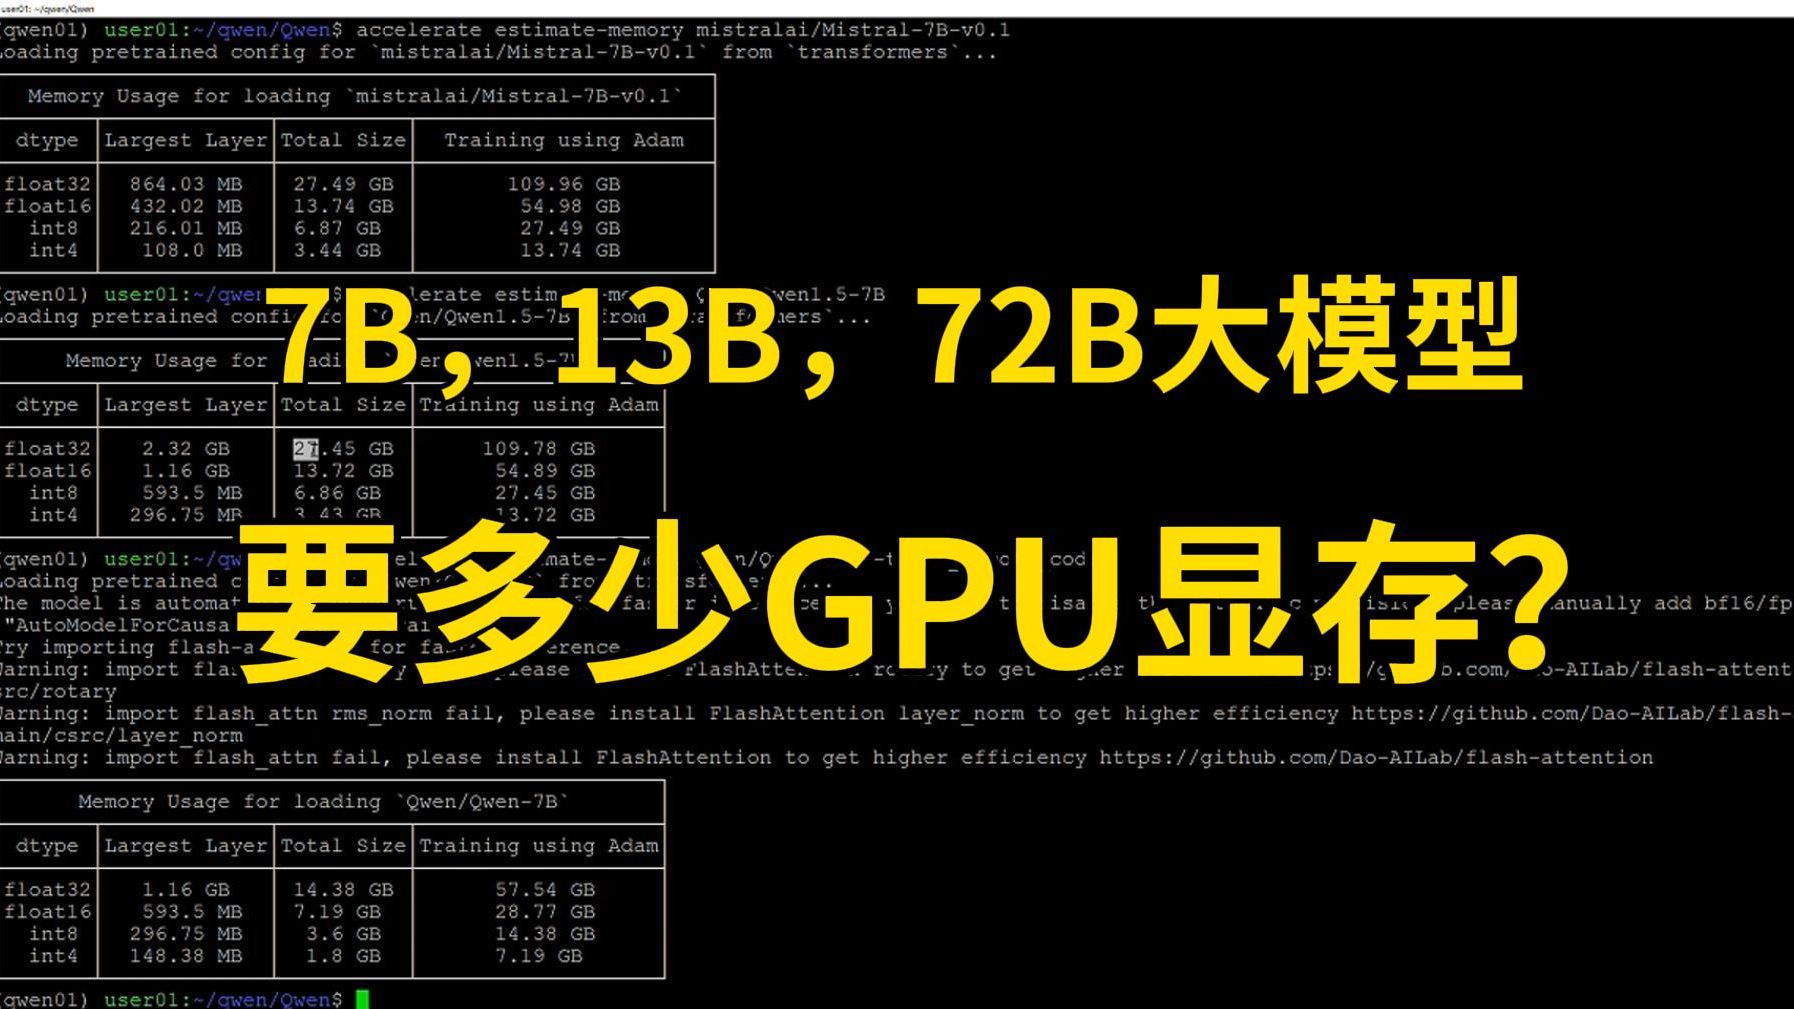
训练任务的硬件选型核心参数只有两个:显存容量和卡间带宽,训练千亿参数模型,单卡80G显存是门槛;卡间通信要用NVLink或InfiniBand,否则梯度同步能把训练效率拖垮,南京的AI算力租赁服务商通常把8卡A100/H800做成一整个租用单元,绑定了NVSwitch背板,这块在租单卡时容易忽略。
实操建议:在南京租训练算力时,问清楚卡间互联是否走NVLink,不少服务商用千兆以太网兜底,号称“8卡A100整机”,实际训练时通信瓶颈会导致算力折损三成以上。
推理场景:看延迟、看吞吐
推理任务对单卡算力要求不高,但对推理延迟和并发吞吐极其敏感,同样是7B参数模型,A10和L4的推理延迟差异可能只有十几毫秒,但价格差了几倍,对延迟不敏感的场景(如离线批量任务),南京本地的T4卡(4到6元/小时)是性价比之选;对延迟敏感的场景(如金融风控、实时语音识别),需要A10甚至L40S,且最好和模型在同一城市可用区,避免跨地域网络跳转。
调度与弹性的差异化需求
训练:要确定性,别折腾
训练任务的调度需求是确定性优先,模型跑了一半,服务商说机器被回收,这谁都受不了,签订租用合同时,必须明确续租优先权、停机赔偿规则、数据迁移协助义务,南京本地服务商通常更灵活,允许客户按月续租;云厂商则是标准的“先到先得”模式。
关键实操操作步骤:
- 第一步,和南京本地服务商签租约时,明确“续租优先权”条款,确保训练中断后能立即拿回原有资源。
- 第二步,要求服务商提供带外管理IP和独立运维通道,方便自己监控GPU利用率。
- 第三步,训练数据必须异地备份,防止机房故障导致算力数据双重丢失。
推理:要弹性,自动化伸缩
推理任务的调度核心是弹性伸缩,云厂商的容器服务(如简米云ASK、酷番云TKE)支持根据QPS自动扩缩容GPU实例,缩容到零也不产生费用,南京本地服务商大多只提供裸金属整租,没有自动伸缩能力,适合流量平稳的场景。
实际操作中,如果你用的是公有云推理实例,配好HPA(Horizontal Pod Autoscaler),把触发规则设为“GPU利用率超过70%扩容两倍,连续15分钟低于30%缩容”,这个策略在南京的游戏、电商类客户里用得最多,普遍能把算力成本优化掉20%左右。
按场景选择南京算力租用的最终建议
南京算力租赁平台怎么选
- 大模型预训练:首选主流云厂商,选择南京可用区内的H800集群,按整机月租,优先保证网络互联质量,不要贪便宜选低端卡。
- 中小企业微调:本地服务商性价比高,选择支持月租或季度租的A100,确认支持断点续训。
- 线上推理API:直接用云厂商的按量推理服务,选A10或L4规格,开启自动伸缩,预算不设上限,只按实际调用付费。
- 边缘设备推理:南京本地的T4实例,按小时租用,适合跑目标检测和OCR类轻量级模型。
Q&A:南京AI推理与训练算力租用哪些区别
训练任务能直接租推理卡来跑吗?
能跑,但要分清场景,小模型(低于10亿参数)在T4或A10上能跑通训练流程,只是速度慢几倍,百亿参数以上模型训练必须用A100/H800,显存和带宽瓶颈很难绕过去,如果只是偶尔做小规模微调,租几小时推理卡能省不少预算。
南京算力租用的价格谈判空间大吗?
按年签约或整机柜租用的议价空间明显,以A100月租为例,官网标价3万元,谈成一年期整机柜合同,价格通常能压到2.2万元左右,不过签长约前要留意服务商的硬件更换条款,防止第二年用旧卡充数。
推理和训练对网络带宽的要求分别多大?
训练任务对节点间带宽极其敏感,8卡以上集群需要400Gbps以上的RDMA网络,千兆以太网根本撑不住,推理任务对公网带宽更敏感,南京本地单机推理通常10Mbps公网带宽就够用,但要注意跨地域调用的延迟,通常比本地高20到30毫秒。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/804728.html