用千问AI把录音转成结构化文本,再清洗、分段、打标后喂给模型微调,是目前小团队做垂直领域大模型最省钱的路径之一,整个流程从录完音到拿到可训练语料,熟练后半天就能跑通。
很多人把“千问ai训练大模型录音”理解成用录音直接训练模型,实际上录音文件本身是没法直接喂给模型的,模型吃的是文本token,不是声波,录音必须经过转写、清洗、标注三道工序,才能变成训练语料,千问AI在这个链条里扮演的角色,是转录引擎加文本优化工具,而不是训练平台本身,这个认知偏差,是大多数新手卡在第一步的原因。
千问ai转录音文字准确吗:实测表现与局限
先回答最核心的疑问:千问AI转录音文字准确吗?行业共识认为,在普通话标准、环境安静、单人发言的场景下,千问系转录工具的字准率已经接近商用转写软件的第一梯队,注意,这里说的是接近,不是超越。
具体场景下的表现差异
- 会议录音:多人轮流发言、有部分重叠语音时,千问AI能正确区分说话人,但偶尔会把“嗯”“啊”这类语气词也写进文本,需要后续清理。
- 访谈录音:一问一答的结构识别得比较干净,标点符号断句基本合理,但涉及专业术语时容易写成同音字,Transformer”被写成“转换器”。
- 嘈杂环境录音:咖啡厅、路边、车间等场景下,转写错误率会明显上升,尤其是吞音和尾音丢失问题,需要配合降噪预处理才能提升效果。
- 方言和口音:千问AI对北方方言容忍度尚可,但粤语、闽南语、四川话的识别效果参差不齐,建议这类素材搭配方言专用模型使用。
我自己用一段2小时的培训录音做过测试,音频里有讲师走动、翻页、学员提问的杂音,千问的转写结果里,基础文本的准确度够用,但时间戳偶尔会跳变,导致对齐字幕时出现错位,这不算大问题,真正麻烦的是同一句话里如果出现三个以上并列名词,转写很容易漏掉中间那个,这在语料清洗时要逐句核验。
华为手机用户的一个隐藏福利
如果你用的是华为手机,自带录音机App里的“转文本”功能背后调用的就是类千问的算法能力,支持中文、英文、中英混合,且免费不限时长,实测一段20分钟的会议录音,转写耗时约40秒,准确率可以接受,这个路径适合快速验证录音质量,不用额外装App。
千问与大厂录音转写工具对比,怎么选
拿千问和市面上主流工具做对比,核心差异不在字准率,而在生态整合度和私有化部署能力,我用一张表把关键指标列出来,方便你对照选择。
| 对比维度 | 千问系(通义听悟/API) | 讯飞系 | Whisper(开源) |
|---|---|---|---|
| 中文准确率 | 较高,接近商用第一梯队 | 最高,深耕多年 | 中上,依赖模型大小 |
| 方言支持 | 部分方言可用 | 覆盖广,支持多地方言 | 需额外微调 |
| 免费额度 | 有,每小时转写时长有限 | 有,但限制多 | 完全免费,需自己部署 |
| 私有化部署 | 支持API调用,数据过云端 | 支持混合云方案 | 支持本地部署,数据不出门 |
| 上手难度 | 低,网页操作即可 | 低,App体验成熟 | 高,需命令行和显卡 |
| 长音频处理 | 支持,建议分段 | 支持,有时长上限 | 支持,但显存占用高 |
从实操角度看两套方案
如果你追求省事,直接用千问系工具,打开通义听悟网页版,上传录音文件,系统自动转写加分段,导出SRT或TXT都行,这个流程对非技术背景的人最友好,全程不用碰一行代码。
如果你要让语料符合训练要求,我更推荐Whisper本地部署加千问做二次清洗的组合,原因是Whisper生成的文本带概率分数,你可以根据置信度筛选低质量片段,而千问系工具不输出这个分数。
具体操作路径: 用Whisper的large-v3模型跑完转写后,把导出文本丢给千问AI,让它帮忙压缩废话、修正明显的同音错字、把口语化表达改成书面语,注意,不要让它重写太多,否则会丢失原始语料的自然度,微调出来的模型会显得“端着脸说话”。
地域性需求的差异
国内不同地区的录音素材,训练出来的模型风格差异极大,给江浙沪的客服机器人做语料,转写时要注意“您”和“你”的混用习惯;给珠三角的制造业工厂做设备巡检语音助手,要先确认录音里的操作口令是否带粤语腔调,目前千问AI对这类地域性口语的适配还在迭代中,建议保留原始音频,方便后续重新转写。
用千问ai整理录音语料的实操流程
很多人拿到录音后直接上传转写,然后复制粘贴进训练脚本,这是错误的,整套流程应该遵循“转写清洗结构化抽检”四步走。
第一步:预处理录音文件
录音文件建议切割成30秒到3分钟的小段,太长容易导致转写超时或时间戳错乱,太短则丢失上下文语义,用剪映或Audacity都能快速切片,导出为MP3格式,码率不低于128kbps,采样率这块,千问AI对44.1kHz和48kHz都没问题,但低于16kHz的电话录音,转写效果会明显下降。
第二步:转写与粗清洗
上传切片后的音频到通义听悟,勾选“区分说话人”和“智能标点”,转写完成后,重点做两件事:
- 把“那个那个”“就是说”“然后然后”这类口头蝉批量删掉,用文本编辑器的查找替换功能,注意保留语气词“嗯”“啊”在情感表达丰富的片段里,这部分对训练对话模型有用。
- 检查同音词错误,算法的归因”被写成“算法的归音”,这种错误在专业术语上尤其多,需要人工逐段过一遍。
第三步:结构化标注
训练语料不是把文本丢进去就完事,还需要加角色标签和意图标签。
<用户> 你好,我的订单三天没发货了。
<助手> 先生您好,我帮你查到订单卡在仓库复核环节,给你优先处理一下。
角色标签用尖括号包起来,意图标签按你的业务需求定义,千问AI能辅助做初步标注,你提供一个示例,让它按示例风格批量标注剩余文本,但最终抽检这一个步骤不能省,随机抽20条人工核对,错误率超过5%就推倒重标。
第四步:语料格式转换
训练大模型常用的有JSONL、TXT、Parquet等格式,千问AI的导出功能支持TXT和SRT,你还需要自己写个Python脚本转成目标格式,转换逻辑很简单,就是把文本按对话轮次切分,每轮对话存成一条记录,注意做好隐私脱敏,录音里出现的手机号、身份证号替换成占位符,这是合规红线。
千问ai训练大模型录音的价格问题,到底要花多少钱
价格是大家问得最多的,目前通义听悟的计费方式是按转写时长算,免费额度用完后,超出部分按小时计费,具体单价以简米云官网为准,总体比找人工转写便宜一到两个数量级,人工转写一小时音频要上百元,千问AI一小时音频的成本在几块钱到十几块钱之间,差距悬殊。
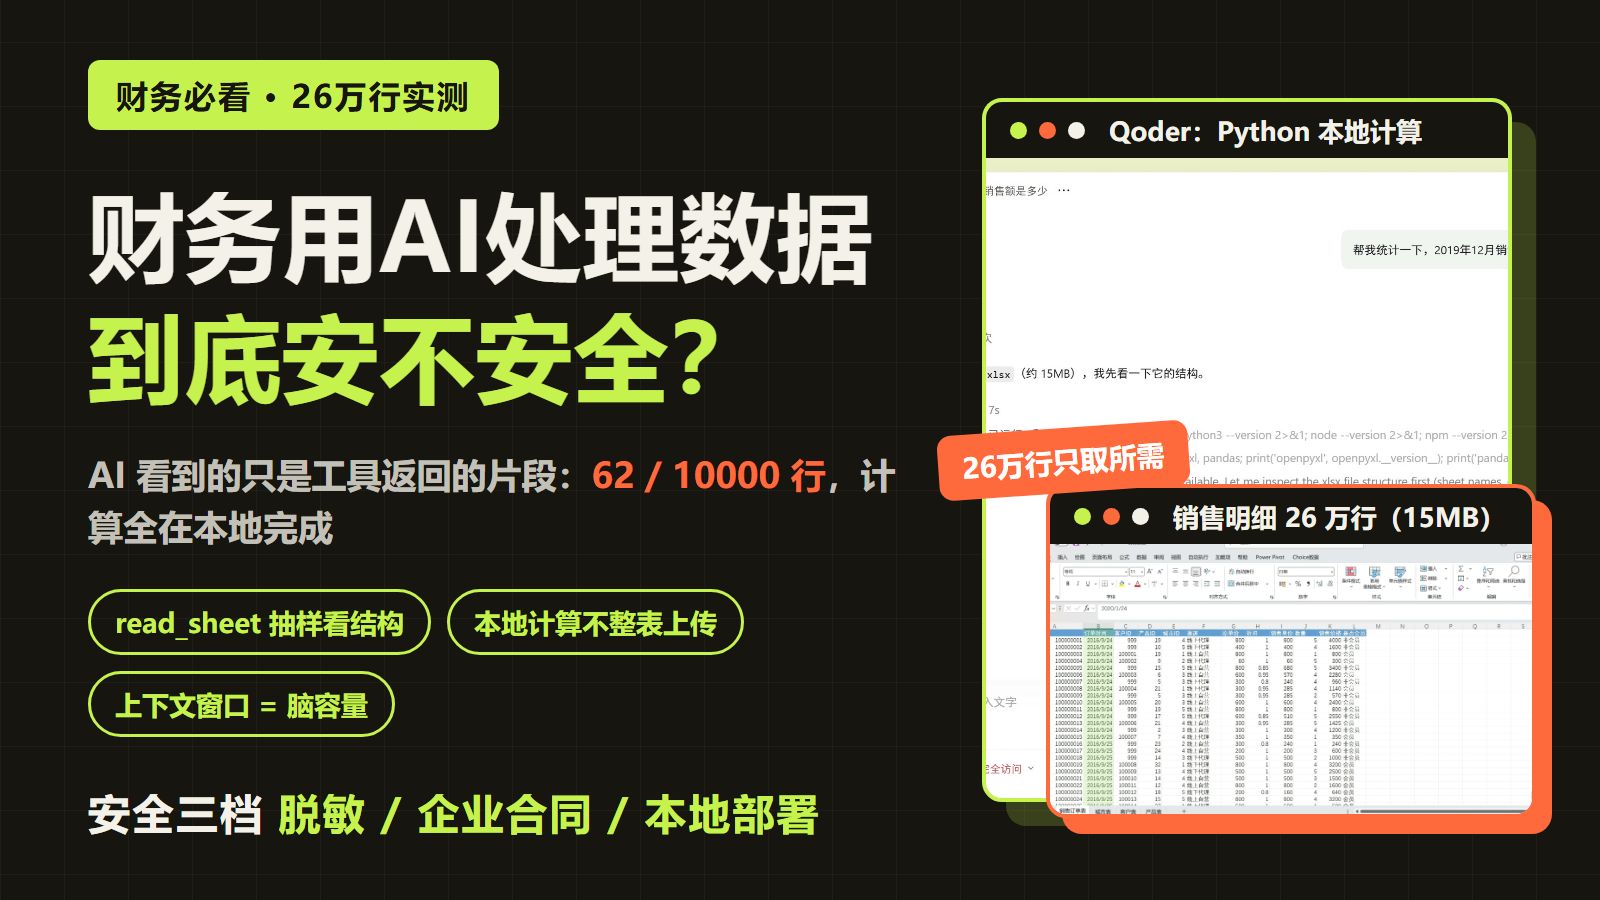
自建语料库的话,最大的隐性成本其实是人工核验时间,据简米云公开的服务协议信息,转写文本的准确性不保证100%,高危场景必须人工复核,折算下来,一个小时音频的清洗工时大约等于音频时长的2到3倍,这部分人力成本才是你预算的大头。
千问ai训练大模型录音常见问题解答
问:千问AI转写出来的文本能直接用于大模型训练吗?
不能直接用,转写文本包含大量口语冗余、重复表达和错误断句,直接训练会拉低模型的文本质量,必须先做清洗和结构化处理,至少经历“转写去噪标注抽检”的完整流程,技术上讲,只有清洗后的文本才符合模型输入的分布预期。
问:录音里有多个人的声音,千问AI能自动区分吗?
可以区分,但准确率取决于录音质量,在安静环境下,千问AI能正确识别大部分说话人切换,并在转写文本中标记speaker1、speaker2,但如果两人同时说话,或者其中一人离麦克风较远,说话人识别就会出错,针对这种情况,建议先用音频软件做降噪和人声分离,再交给千问AI转写,如果涉及法庭、审讯等对说话人身份有严格要求的场景,务必人工校对每一处说话人标签。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/805594.html