一文读懂大模型的技术栈的技术实现,大模型技术栈有哪些

大模型技术栈的技术实现,本质上是一个从数据输入到模型推理的端到端工程化过程,其核心逻辑在于通过海量数据预训练获取通识能力,再经由指令微调与人类偏好对齐激发特定任务能力,最终依托高性能计算架构实现规模化服务。这一技术栈并非单一算法的突破,而是数据工程、算法架构、训练优化与推理部署四大核心支柱的系统性融合。
一文读懂大模型的技术栈的技术实现

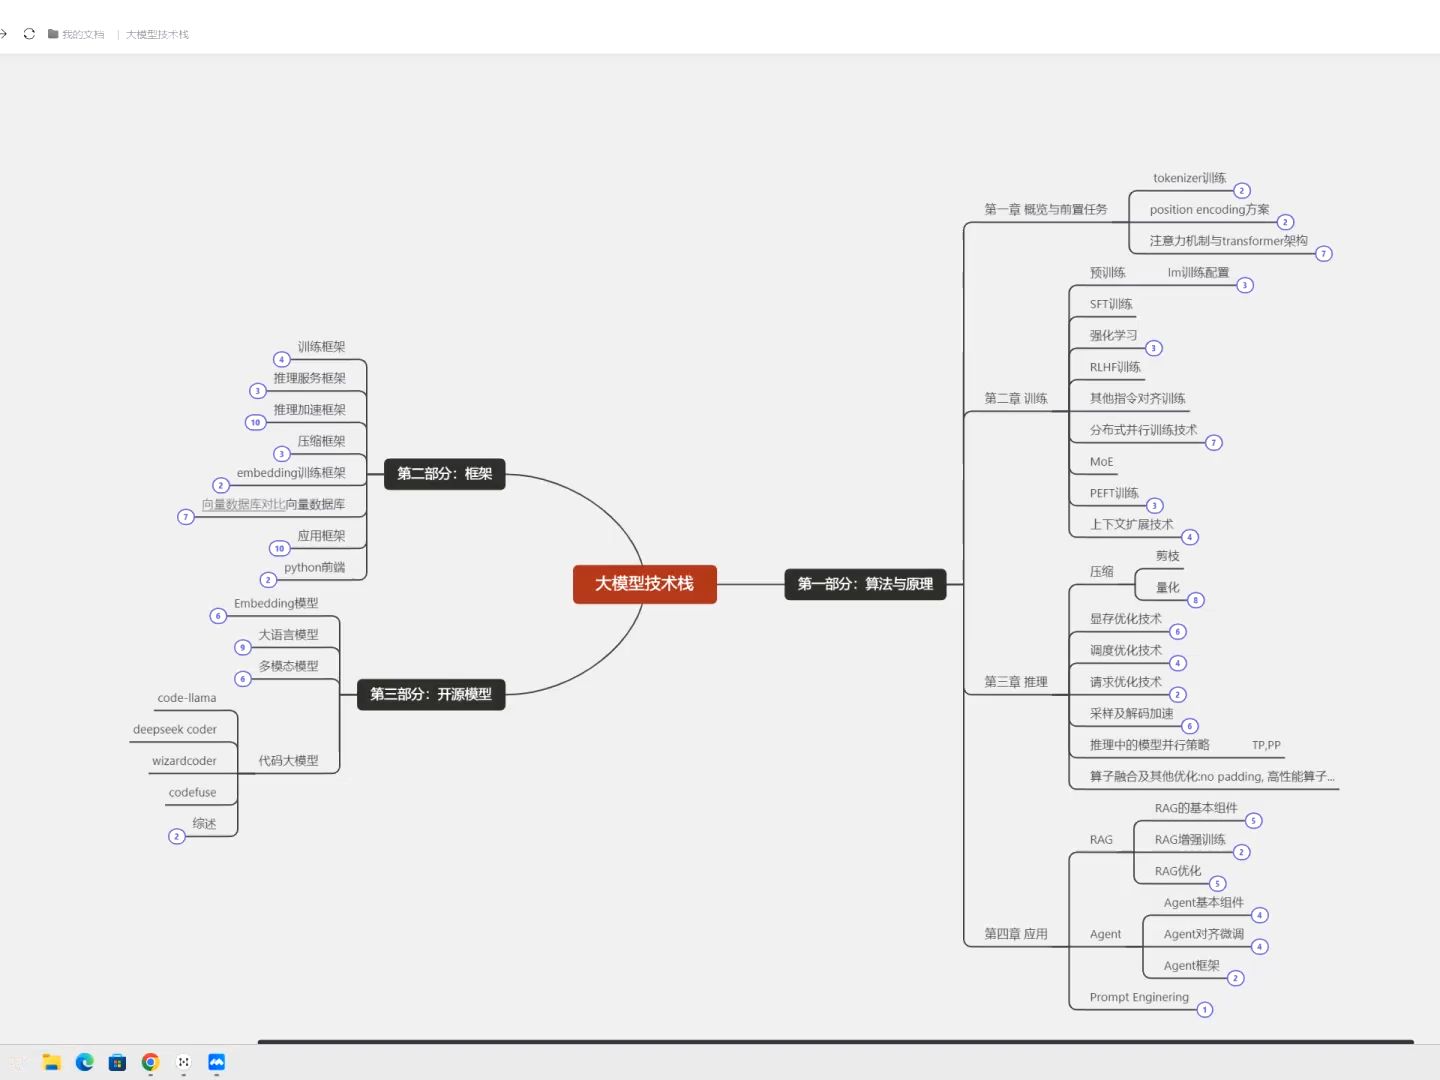
大模型技术栈-全览
加载中
大模型技术栈-全览

底座构建:数据工程与预处理

高质量数据是大模型能力的基石,数据工程占据了技术实现约70%的工作量。

  1. 数据采集与清洗:大模型训练数据通常涵盖网页文本、书籍、代码、论文等多源异构数据。核心在于去重、去噪与隐私清洗,技术团队需采用MinHash、SimHash等算法进行大规模去重,利用正则表达式和分类模型过滤低质量文本,确保输入数据的纯净度。
  2. 分词器训练:分词是将原始文本转化为模型可理解向量的关键步骤,目前主流采用BPE(Byte Pair Encoding)或Unigram算法。优秀的分词器能在压缩序列长度与保持词汇语义完整性之间取得平衡,直接影响模型的训练效率与推理速度。
  3. 数据配比:不同类型数据的配比决定了模型的“性格”与能力边界,增加代码数据比例可显著提升模型的逻辑推理能力,而高质量指令数据则能增强模型的指令遵循能力。

核心架构:Transformer及其演进

模型架构是大模型技术栈的“心脏”,决定了模型的天花板。

  1. Transformer架构统治地位:目前绝大多数大模型均基于Transformer架构,其核心是自注意力机制,能够并行处理序列数据并捕捉长距离依赖关系。
  2. Decoder-Only架构成为主流:在GPT系列成功后,Decoder-Only(仅解码器)架构因其在大规模文本生成任务中的优越性能,逐渐取代了Encoder-Decoder架构,成为生成式大模型的首选。
  3. 位置编码与注意力优化:为解决长文本限制,技术实现上引入了RoPE(旋转位置编码)、ALiBi等相对位置编码方案,为降低计算复杂度,FlashAttention技术通过优化显存访问机制,在不牺牲精度的情况下大幅提升了训练速度,成为当前标配。

训练优化:预训练与后训练的接力
一文读懂大模型的技术栈的技术实现

训练过程分为预训练与后训练两个阶段,前者赋予知识,后者赋予能力。

  1. 大规模分布式预训练:这是算力消耗最大的阶段,技术难点在于3D并行策略(数据并行、张量并行、流水线并行)的合理配置,利用ZeRO优化器显存优化技术,可以在有限显存资源下训练千亿参数模型,预训练目标通常是预测下一个Token,通过海量数据让模型习得世界知识。
  2. 有监督微调(SFT):预训练模型虽具备知识,但不擅长对话,SFT阶段通过构建高质量的“指令-回答”对,打破模型“续写”惯性,激发其“问答”能力,此阶段数据质量远比数量重要,少量高质量指令数据即可显著提升模型效果。
  3. 人类偏好对齐(RLHF/DPO):为解决模型回答不安全、不遵循人类意图的问题,引入了基于人类反馈的强化学习。直接偏好优化(DPO)因无需训练奖励模型、流程更简化,正逐渐取代传统的PPO算法,成为高效对齐的主流方案。

推理部署:性能与成本的博弈

模型训练完成后,如何高效、低成本地部署上线是技术实现的最后一环。

  1. 模型量化技术:为降低显存占用,通常将FP16(16位浮点数)模型量化为INT8甚至INT4(4位整数)。AWQ、GPTQ等量化算法能在极小精度损失下,将显存需求减半,使大模型能在消费级显卡上运行。
  2. 推理加速引擎:KV Cache(键值缓存)是推理加速的核心技术,通过缓存已计算出的Key和Value矩阵,避免重复计算,结合PagedAttention技术(如vLLM框架),可有效管理显存碎片,将推理吞吐量提升数倍。
  3. 显存优化与服务化:利用连续批处理策略,动态调整Batch Size,最大化GPU利用率,技术团队通常通过Triton或Ray Serve构建服务集群,实现高并发下的稳定响应。

一文读懂大模型的技术栈的技术实现,关键在于理解这并非单一技术的突进,而是系统工程学的极致体现,从数据清洗的严谨到架构设计的精妙,再到训练策略的优化与推理部署的极致压榨,每一环都至关重要。未来的技术演进将更侧重于降低算力门槛、提升长文本处理能力以及实现更高效的端侧部署。


相关问答模块
一文读懂大模型的技术栈的技术实现

大模型训练中,SFT(有监督微调)和RLHF(人类反馈强化学习)有什么本质区别?

SFT主要解决的是“指令遵循”问题,通过给模型展示正确的问答范例,让模型学会模仿人类的回答格式和逻辑,属于行为克隆;而RLHF解决的是“价值观对齐”问题,通过训练一个奖励模型来打分,引导模型生成更符合人类偏好(如更安全、更有用、更真实)的回答,属于价值引导。SFT决定了模型能不能好好说话,RLHF决定了模型说得是否符合人类心意。

为什么现在大模型推理都在强调KV Cache技术?

在生成式大模型的推理过程中,生成下一个Token需要依赖之前所有的Token信息,如果不使用KV Cache,每生成一个新Token都需要重新计算之前所有Token的Key和Value矩阵,计算量巨大且重复。KV Cache通过空间换时间的策略,将计算结果缓存下来,避免了重复计算,从而将推理复杂度从O(n²)降低,极大提升了生成速度,是大模型实时响应的关键技术。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/80562.html

赞 (0)
大模型如何接入本地文档?本地知识库搭建教程
上一篇 2026年3月10日 21:28
新加坡机房住宅IP怎么样,新加坡原生IP有什么优势
下一篇 2026年3月10日 21:37

相关推荐

  • 服务器和虚拟主机是不是一回事,有什么区别?

    服务器和虚拟主机不是一回事,它们本质上是两种不同的资源分配方式,简单说,服务器是一台独立的物理机器,而虚拟主机只是这台机器上划分出来的一个共享空间,服务器和虚拟主机到底有什么区别很多人刚接触网站时,会把这两个概念混为一谈,服务器指的是完整的物理硬件或云实例,拥有独立的CPU、内存、硬盘和操作系统,你能完全掌控它……

    2026年8月11日
    700
  • Cloudflare CDN怎么配置才能有效加速网站?Cloudflare CDN免费加速教程与设置指南

    Cloudflare CDN 是全球领先的边缘计算与内容分发网络服务商,通过其遍布全球的 Anycast 网络、Argo 智能路由技术以及集成的边缘安全防护,为企业提供极速的内容加载、强大的 DDoS 防护及降低源站带宽成本的综合解决方案,核心技术架构与性能优势全球 Anycast 网络布局Cloudflare……

    2026年7月14日
    1200
  • 大模型成本评估方法有哪些?从业者说出大实话

    显性的算力支出仅仅是冰山一角,隐性的数据清洗成本、人才维护成本以及试错风险成本,往往占据项目总投入的60%以上,却最容易被企业忽视,真正的成本评估,必须从单一的硬件采购视角,转向全生命周期的TCO(总拥有成本)核算,否则模型上线之日,就是项目亏损之时, 算力成本:不仅要看采购价,更要看实际利用率很多企业在评估大……

    2026年3月22日
    13600
  • 七牛cdn免费是真的吗?七牛云存储免费额度怎么用

    七牛云CDN在2026年依然提供基础免费额度,适合个人开发者、静态网站及轻量级业务使用,但需注意流量超出后的计费策略及功能限制,随着Web 3.0和移动互联网的深入发展,内容分发网络(CDN)已成为保障网站访问速度和稳定性的基础设施,对于许多初创团队、独立开发者以及小型企业而言,成本控制是技术选型的首要考量,七……

    2026年6月21日
    2600
  • 国内呼叫中心外包公司哪家好,收费标准是多少?

    在当前竞争激烈的商业环境中,企业若想实现降本增效与业务增长的平衡,将非核心业务进行专业化外包已成为战略共识,对于客户服务与营销支持而言,选择优质的合作伙伴不仅是成本的节约,更是品牌形象的延伸,国内呼叫中心外包行业已从单纯的人力堆叠,演进为集AI智能技术、全渠道运营及精细化数据分析于一体的综合服务体系, 企业通过……

    2026年2月23日
    15200
  • 美国104cdn是什么?104cdn域名解析怎么设置

    美国104cdn通过优化全球节点调度与静态资源加速,能显著提升海外业务访问速度并降低服务器负载,是出海企业解决跨国延迟问题的核心基础设施,在数字化浪潮席卷全球的今天,企业出海不再仅仅是将网站搬到海外,更是要让全球用户获得如同本地访问般的流畅体验,对于许多面向北美市场的企业而言,网络延迟、加载缓慢以及服务器稳定性……

    2026年6月24日
    3300
  • 给学生讲大模型难吗?如何通俗易懂给学生讲大模型

    大模型并非高不可攀的黑盒技术,其本质是“概率预测”与“海量数据”的结合,理解它的逻辑比学习一门编程语言更直观,给学生讲大模型,核心在于剥离复杂的数学公式,用生活化的案例拆解其工作原理,让学生明白这不仅是技术的飞跃,更是思维方式的迭代, 只要掌握“预测下一个字”和“海量阅读”这两个关键点,就能看懂大模型的底层逻辑……

    2026年3月12日
    17000
  • 深度解析ai大模型应用面试的实际应用价值,ai大模型应用面试难吗?

    AI大模型应用面试的核心价值在于精准筛选具备实战落地能力的复合型人才,有效降低企业试错成本,并推动业务智能化转型的实际成功率,在当前人工智能技术从实验室走向产业落地的关键期,面试环节不再仅仅是理论知识的考核,而是成为了检验候选人能否将大模型技术转化为商业价值的关键过滤器,通过深度解析ai大模型应用面试的实际应用……

    2026年3月15日
    11700
  • 中国股票CDN加速,中国股票CDN加速怎么配置

    CDN加速中国股票交易的核心在于通过边缘节点降低网络延迟,确保行情数据毫秒级同步,但需注意合规性,仅支持合法持牌机构的交易接入,严禁非法配资或内幕交易数据服务,在2026年的数字金融生态中,网络基础设施的稳定性直接决定了高频交易与散户体验的边界,中国股票市场作为全球流动性最强的市场之一,其对低延迟、高并发的网络……

    2026年6月30日
    2900
  • incapsula cdn面板怎么登录,incapsula cdn

    Incapsula CDN面板是Imperva(现属Thales集团)旗下的一站式网络安全与性能优化控制台,通过集成WAF、DDoS防护及全球边缘加速,能显著提升网站加载速度并拦截恶意流量,适合对高并发访问和敏感数据保护有强需求的中型至大型企业,Incapsula CDN面板的核心架构与功能解析边缘节点与智能路……

    2026年6月14日
    2700

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注