服务器诊断码种类繁多,但日常运维和故障排查中最核心的只有两类:HTTP状态码(如404、500)和服务器系统层诊断码(如Windows事件ID、Linux退出码)。 这两类构成了服务器“自述病情”的主要语言,读懂它们就能解决绝大多数服务器异常问题。
下面直接进入正题,看看实际工作中高频出现的诊断码到底有哪些,以及它们分别代表什么含义。
服务器诊断码有哪些分类
从运维视角看,服务器诊断码并非单一体系,而是分层存在的,行业共识认为,互联网用户能感知到的故障,约80%最终都表现为HTTP状态码异常;而运维人员在服务器本机排查时,接触更多的是操作系统和中间件生成的日志诊断码。
HTTP状态码:面向客户端的第一道信号
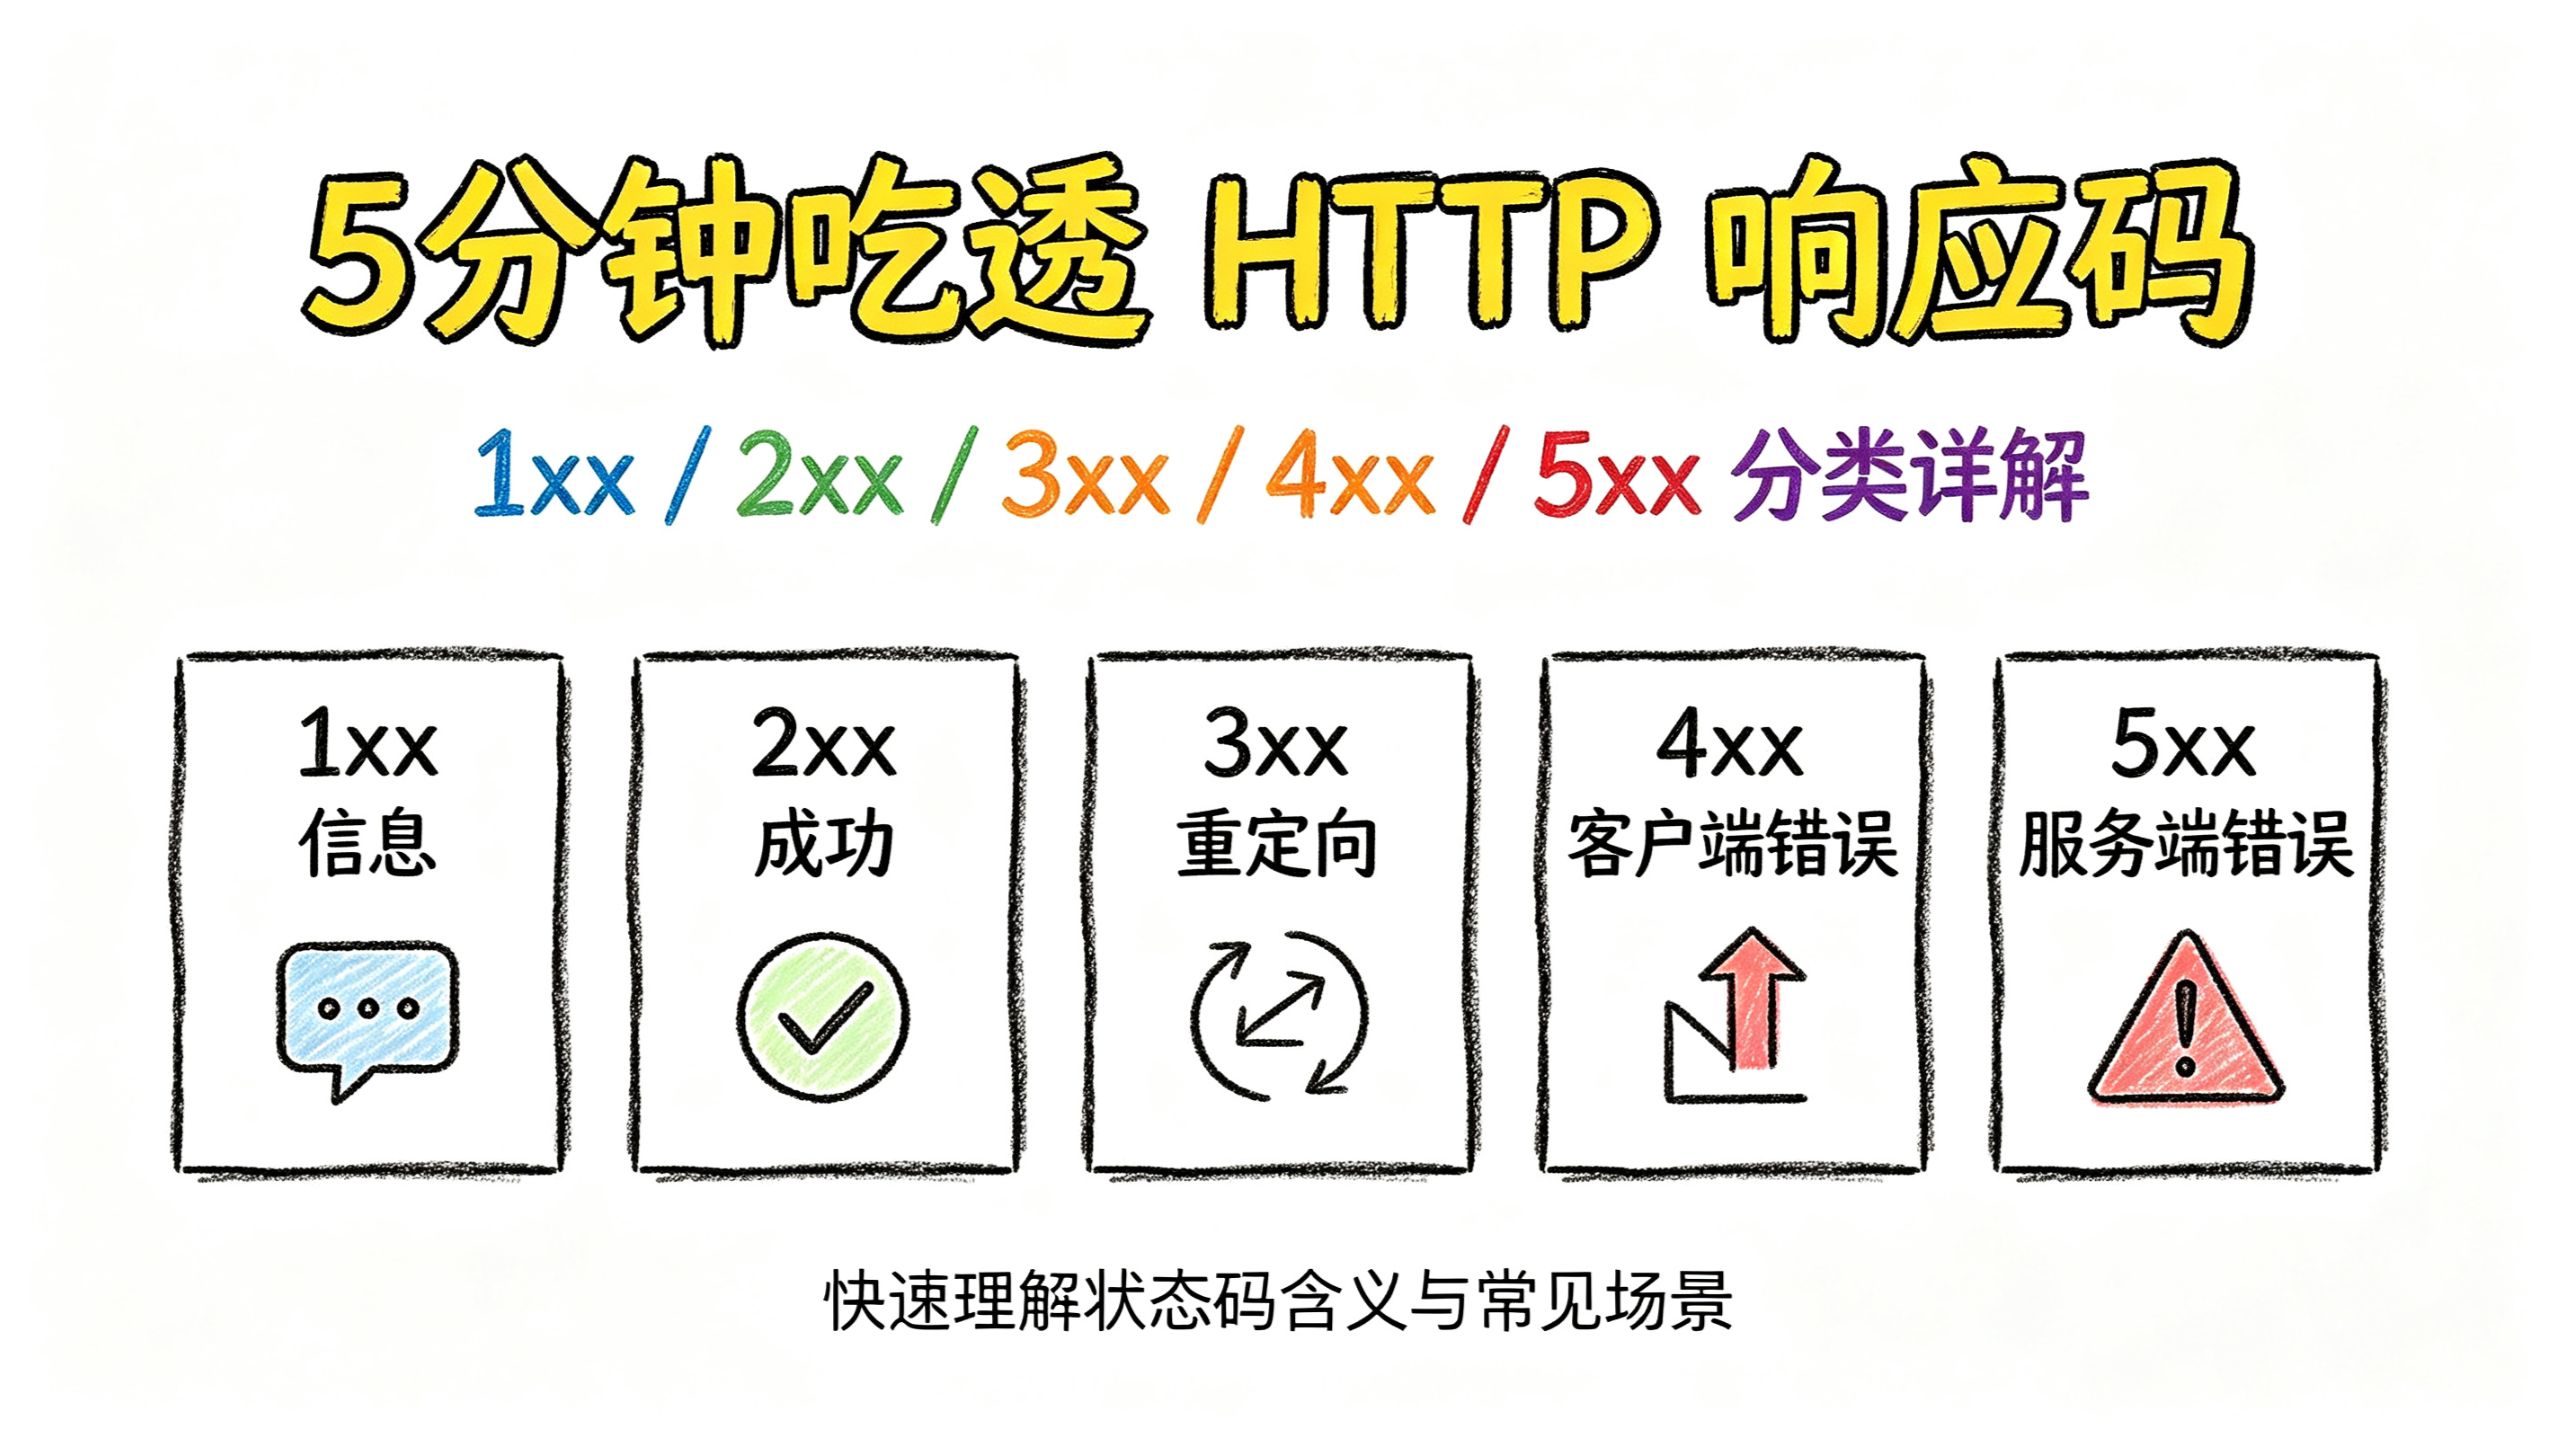
这是最直观的服务器“口头禅”,分为五大类:
- 1xx 信息响应:服务器已接收请求,继续处理中,日常极少直接暴露给用户。
- 2xx 成功信号:最常见的是200 OK,代表一切正常,还有204 No Content表示响应无主体。
- 3xx 重定向:301永久迁移、302临时跳转,以及导致死循环的304 Not Modified(浏览器缓存命中)。
- 4xx 客户端错误:这是站长和用户最常碰到的。403禁止访问、404页面不存在,还有容易被忽视的429请求过多(触发限流)。
- 5xx 服务端错误:500内部错误、502网关错误、503服务不可用,服务器表示“我撑不住了”。
系统与中间件诊断码:服务器内部的“体检指标”
这部分隐藏在屏幕背后,但对排查故障至关重要:
- Linux退出码:脚本或程序执行后返回的状态码,0代表成功,非0值(如1、127)分别代表通用错误和命令不存在。
- Windows事件ID:系统日志中每个事件的唯一编号,例如事件ID 6006表示系统正常关机,事件ID 41代表非正常断电重启。
服务器诊断码怎么查:实操三步走
知道有哪些码之后,更关键的是怎么快速查到它们,按以下路径操作,几分钟内就能定位问题。
第一步:查HTTP响应的原始返回码
别只看浏览器页面,那往往是被框架包装过的,直接在命令行验证:
- Linux/macOS:使用
curl -I https://你的域名命令,返回的第一行就是状态码及含义。 - Windows:使用
Invoke-WebRequest https://你的域名后查看StatusCode属性。
第二步:定位服务日志中的错误码
绝大多数应用会把错误码写入日志文件。
- Nginx:日志路径通常在
/var/log/nginx/error.log,搜索关键字error或critical。 - Tomcat:位于
/usr/local/tomcat/logs/catalina.out,重点关注包含Exception或Error的行。 - Windows系统:打开“事件查看器”,展开“Windows日志”下的“系统”和“应用程序”,筛选“错误”级别即可看到红色显眼的诊断码。
第三步:验证系统资源层诊断码
有时候应用没报错,但服务就是卡死,用dmesg -T命令查看内核日志,若有Out of memory或Killed process字样,说明系统内存耗尽的诊断码已经触发,需要检查是否有进程内存泄漏。
服务器诊断码常见故障场景实战
光知道数字含义还不够,结合具体场景才能快速止血,这里拆解两个高频痛点。
网站突然打不开,页面显示500错误
这是最典型的服务器内部故障,排查顺序建议由简入繁:
- 检查PHP或Java进程是否存活:
ps aux | grep php或jps。 - 查看磁盘空间是否写满:
df -h,若使用率100%,直接导致无法写入临时文件而报500。 - 调高日志级别并复现,看堆栈信息中的具体报错行。
- 通常修复权限或重启应用进程即可解决,因为多数情况下500错误源于进程僵死而非代码缺陷。
出现大量404错误,但页面文件确实存在
这种情况多半不是文件丢失,而是URL重写规则冲突,例如Nginx的try_files指令配置错误,导致所有请求先去匹配伪静态规则,匹配失败后直接返回404而不是去找index.php,解决办法是检查并修正nginx.conf中location块的try_files参数。
服务器诊断码与常用工具对比
为了让大家少走弯路,这里整理了一份主流排查工具清单,按敏感度和使用场景区分:
| 工具名称 | 适用诊断码类型 | 核心用途 | 上手难度 |
|---|---|---|---|
| curl | HTTP状态码 | 直接查看响应头和状态,支持模拟各种请求方法 | 低 |
| Postman | HTTP状态码 | 图形化调试接口,便于构造带参数的请求 | 低 |
| Linux journalctl | 系统日志诊断码 | 查询systemd服务的详细启动和崩溃日志 | 中 |
| Windows性能监视器 | 事件ID/性能计数 | 追踪CPU、内存计数器,关联特定事件码 | 高 |
| Wireshark | 网络协议层 | 抓包分析TCP握手失败码,定位网络黑洞 | 高 |
选择建议:如果你主要排查网站访问问题,用curl就够了;如果是服务器莫名其妙重启,重点看Windows事件ID或Linux的journalctl -k内核日志。
服务器诊断码排查的进阶逻辑
新手往往看到错误码就急着去搜解决方案,但老运维会先做一步:区分当前错误是由“流量”还是“代码”引起。
- 如果是瞬时高并发导致的502或503,优先考虑调整FPM进程数、开启负载均衡。
- 如果是偶发性的500,则大概率是代码层面存在未捕获的异常,比如调用了不存在的函数或数据库连接池耗尽。
业内专家指出,把关注点从“这个码是什么意思”转移到“这个码出现的触发条件是什么”,才能从被动救火转为主动预防,建议根据常见的诊断码预先编写监控脚本,设置告警阈值,让机器帮你盯着。
服务器诊断码相关问题解答
问:服务器诊断码有哪些是必须背下来的?
答:至少有六个必须烂熟于心:200(成功)、301(永久跳转)、403(无权限)、404(找不到)、500(服务器内部错误)、503(服务不可用),特别是404和500,前者往往是用户输错地址,后者则是服务器代码或配置出了问题,需立刻查看后端日志。
问:遇到服务器诊断码403,一般是什么原因?
答:原因有两种可能,一是确实是文件目录权限设置不当,例如网站根目录权限被错误设置为600,二是服务器防火墙或安全组规则拦截了源IP,排查时先用ls -l查看文件权限,正常人可读应至少为644,目录为755,若权限无误,再检查云控制台的安全组入站规则是否放行了对应端口。
问:如何区分服务器诊断码中的401和403?
答:401是“未认证”,意味着服务器不知道你是谁,需要提供账号密码才能继续访问,通常配合登录弹窗出现,403是“已认证但被拒绝”,服务器认识你,但不允许你访问这个特定资源,举个例子,用普通用户登录服务器后尝试访问root用户的家目录,系统会返回403而非401。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/806575.html