AI大模型正在重塑生物信息学的分析范式,从序列比对到蛋白质结构预测,过去需要数周的计算任务如今压缩到小时级,这让普通课题组也能触及顶尖机构的科研能力。基于近年来行业公开的技术进展和工具生态,这篇内容把核心逻辑、操作路径和选型问题一次讲透,直接给你能落地的判断依据。
AI大模型生物信息学分析工具到底怎么选
选工具是入局的第一道坎,市面上声称接入大模型的生信平台不少,但多数只是套壳聊天机器人,真正能干的也就那几个方向:基因序列特征提取、蛋白质结构预测、单细胞数据降维解释、变异位点致病性注释,行业共识认为,判断工具是否合格,就看它能否把生物语义理解对比如区分“enhancer”在不同物种里的调控逻辑差异。
实操选型清单:
- 序列分析场景:优先看支持DNABERT、DNAGPT这类专门预训练模型的平台,百度的文心生物大模型也在做类似落地,国内访问更快
- 结构预测场景:AlphaFold2是底线,但要注意它的预测置信度pLDDT值怎么解读,不能只拿图
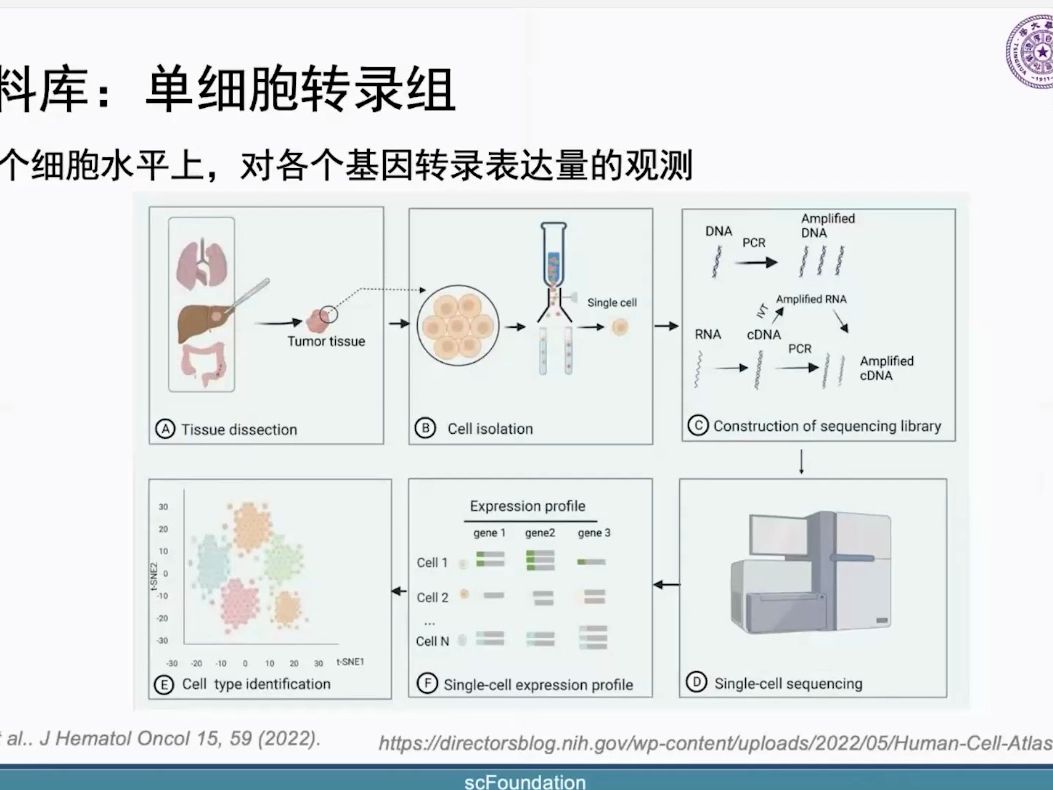
- 单细胞分析场景:别迷信大模型做聚类,它更适合做细胞类型注释的辅助判断,核心降维还得靠Scanpy标准流程
- 本地部署场景:如果数据敏感不能上云,考虑用QLoRA微调一个7B量级的开源模型,硬件成本约在数万元级别
AI大模型生物信息学入门需要准备什么基础
零基础也能上手,但前提是你得补几个关键认知,生物信息学的本质是把生物学问题转译成计算问题,大模型只是加速了这个转译过程,并没有取消转译这道工序,你不必精通Linux内核,但数据库概念、Python基础语法、生物学中心法则这三个底盘得有。
三个月入门路径参考:
- 第一个月:搞懂FASTA、FASTQ、BAM三种文件格式,再用在线版工具做一次RNA-seq差异基因分析
- 第二个月:跑通Kaggle上的单细胞数据集,用huggingface上的生物领域模型做embedding提取
- 第三个月:尝试用LangChain把NCBI的API封装成大模型可调用的工具,做一个简单的基因功能问答机器人
大模型在生物信息学里的进阶应用场景分析
基础应用之外,真正有科研价值的是那些大模型能做得比传统算法更细腻的事,多组学数据整合是当前最热的战场,以往做转录组和蛋白组的关联分析,靠统计方法找重叠通路,噪音大、解释弱,现在用多模态大模型把基因表达谱、蛋白互作网络、代谢物浓度放在同一个向量空间里对齐,能发现过去被平均化掩盖的亚群特征。
三个值得长期投入的方向:
- 药物重定向的语义挖掘:大模型读文献不只是做关键词匹配,而是理解分子机制的因果链条,预测现有药物对新型适应症的结合潜力
- 罕见变异的功能注释:传统SIFT、PolyPhen等工具对非经典剪接位点的预测准确率有限,大模型能捕捉更长范围的序列上下文特征
- 空间转录组的数据补全:Spot级别的基因表达有大量缺失值,生成式模型可以基于邻居信息和形态学特征做合理插补
AI大模型做生信分析如何自己部署
自己动手部署一套可用的环境,没有想象中那么可怕,建议从Anaconda加Jupyter Lab起步,按下面步骤操作,每一步都有明确产出可验证。
部署步骤实操:
- 创建虚拟环境,指定Python版本为3.10,避免依赖冲突
- 安装PyTorch时注意CUDA版本匹配,用
nvidia-smi查看驱动支持的CUDA版本 - 从HuggingFace拉取一个轻量级模型,比如
InstaDeepAI/nucleotide-transformer-2.5b-multi-species - 用transformers库加载模型,对一段已知基因序列做embedding提取,比较不同物种同源基因的向量距离
- 参考官方文档,在你的数据上做一遍PEFT微调,LoRA配置里
r=8就够起步,不用贪大
这五步跑通,你就建立了对模型行为的直觉,之后再看任何高大上的生信大模型框架,都能拆解出它的数据管线、模型架构和训练策略。
AI大模型生物信息学工具成本和算力需求分析
成本是绕不开的现实问题,别被云厂商的“大模型+生信”套餐唬住,先算清三笔账:训练账、推理账、数据清洗账,训练账是一次性投入,推理账是长期成本,数据清洗账最容易被忽略却最耗时。
不同预算层次的配置建议:
- 个人科研探索:预算几千元级别,用Google Colab的A100按需付费,或者国内平台的免费额度跑小规模数据
- 中型课题组:预算数万元级别,租赁一台A800或L40S服务器,微调7B模型足够支撑日常分析
- 机构级平台:预算几十万级别,考虑组建多卡集群并行训练,数据存储用并行文件系统
行价参考:国内主流云平台上,单卡A100的租赁价格约每小时几十元,一个中小规模单细胞项目的推理成本在百元量级。
AI大模型生物信息学分析报告结果怎么解读
模型吐结果只是第一步,解读才是决定论文档次的关键,这里列出最容易踩的坑一:过度信任可视化,UMAP图里的聚类边界很清晰,但你得回头检查这些cluster是否通过了sc.tl.rank_genes_groups的统计检验。
结果验证三原则:
- 看可复现性:换一个随机种子跑一遍,结果是否大致稳定
- 看生物学合理性:大模型标注的细胞类型,是否与已知的lineage marker表达模式吻合
- 看消融实验:把大模型替换成传统方法,结论方向是否一致
如果模型给出的结论和生物学常识明显冲突,先怀疑数据预处理环节,错位比对、批次效应校正过度、参考基因组版本不一致,都会让大模型输出看似荒谬的结果。
AI大模型生物信息学常用数据库介绍
没有高质量数据库,大模型就是无源之水,这五个库基本覆盖日常需求:
- NCBI/ENA/DDBJ:三大核酸序列库,数据同步,国内建议走欧洲ENA镜像下载原始测序数据
- UniProt:蛋白序列与功能注释权威库,人类蛋白质条目超过2万个,注释信息结构化程度高
- PDB:蛋白质三维结构库,配合AlphaFold DB做预测结构比对
- Ensembl:基因组浏览与基因注释,支持多种物种的BioMart数据导出
- TCGA/GEO:高通量测序原始数据与临床信息,训练癌种专属模型的主要数据源
对新手提醒一句:下载数据前先读README,了解样本来源和实验设计,省得后期发现数据污染白忙一场。
核心建议只有一条:把大模型当协作伙伴,别当权威裁判,它负责扩展你的假设空间、压缩试错成本,但每一个关键结论必须回到湿实验验证和生物学解释上,你原创的科学问题加上大模型的算力支撑,才是未来生物信息学研究的正确打开方式。
AI大模型生物信息学相关问答
问:完全不懂编程的生物背景学生,能直接上手AI大模型生信工具吗?
答:可以,先从Galaxy平台或百度的BIO-BERT在线服务开始,这些工具提供可视化界面,不需要写代码,但建议同步补Python基础和Linux命令行,否则后续大数据量的差异化分析会卡在环境配置环节,国内镜像资源和中文教程近年来也越来越多。
问:大模型预测的蛋白质结构可以直接用于分子动力学模拟吗?
答:不建议直接使用,AlphaFold等模型预测的静态结构缺乏侧链的精细构象和溶剂化信息,严谨的做法是先用预测结构做同源建模的模板,再通过MD模拟进行能量最小化和平衡跑动,才适合用于下游药物对接,整个过程耗时约为直接使用预测结构的几倍,但结果的可靠性显著提升。
问:医疗行业从业者关心的大模型基因报告解读和价格成本情况如何?
答:当前市场上针对C端的基因解读服务,单份全外显子测序数据的大模型辅助解读成本已经降低到几百元人民币级别,主要费用集中在测序本身而非AI分析,解读报告会标注证据等级,临床级别的建议仍以遗传咨询师面诊为准,自动生成的报告适合科研参考,直接用于临
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/807669.html