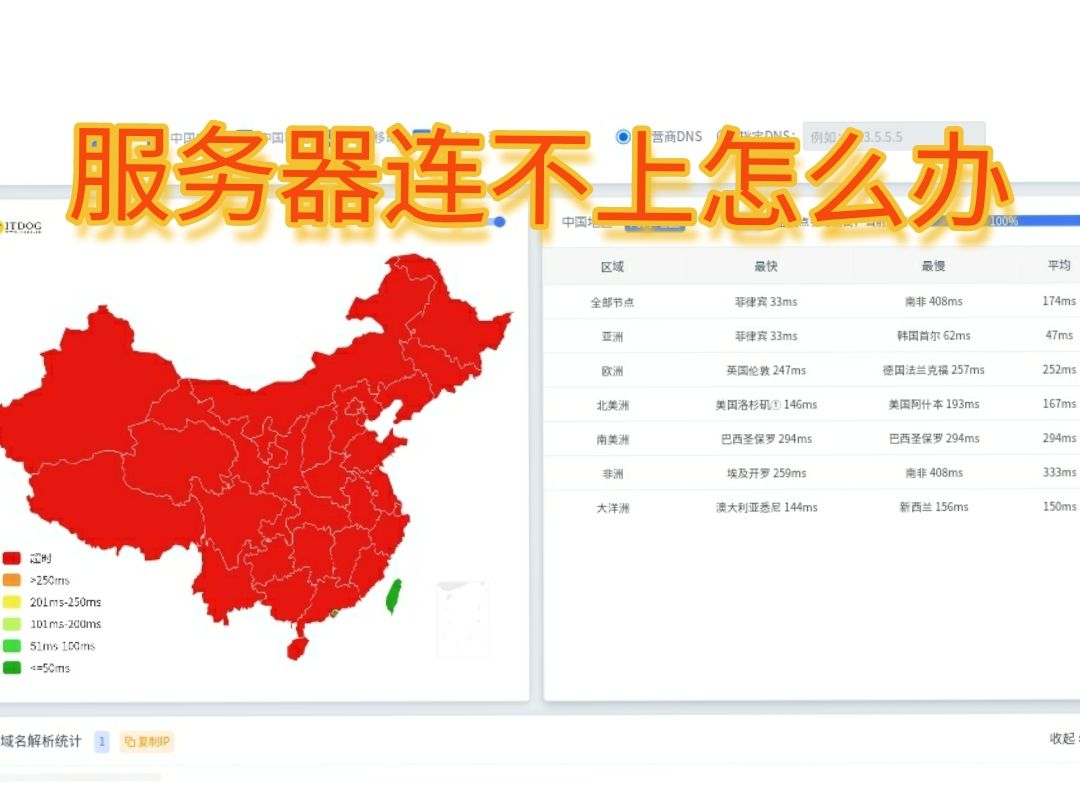
连接id服务器超时,九成以上不是服务器坏了,而是TCP三次握手在某个环节没走完DNS没解析对、防火墙没放行、路由不通、端口被挡,或者服务端连接池已满,先分清报的是“超时”还是“拒绝”,排查方向完全不同。
先看清“超时”到底卡在哪一层
很多人一看到弹窗就重启服务器,结果重启完照样超时,原因很简单:超时是一个“没回音”的状态,服务器根本没收到你的请求,它自然不会给你任何响应。
三种常见报错,含义差得远
| 报错文字 | 含义 | 问题大概在 |
|---|---|---|
| Connection timed out | 请求发出去了,对方一直不回 | 网络、防火墙、路由、端口 |
| Connection refused | 对方明确拒绝 | 服务没启动、端口没监听 |
| DNS resolution failed | 连名字都没解析出来 | DNS配置、域名拼写 |
判断方法很直接:超时是“石沉大海”,拒绝是“有人应答但不开门”。这两种情况的排查顺序完全相反,认错方向会白耗半天。
id服务器在架构里的位置
不管是企业内部的统一身份认证,还是基于OIDC、SAML的单点登录服务,id服务器通常挂在几个关键位置:前面有负载均衡或WAF,后面接用户库和缓存,对外只暴露443或5000这类端口,任一环节卡住,客户端看到的都是同一句“连接超时”,所以别急着怀疑应用代码,先按网络路径一段一段往下走。
连接id服务器超时怎么解决?按这个顺序查最快
第一步:确认网络通不通
在客户端机器上依次执行:
ping id.example.com
nslookup id.example.com
tracert id.example.com      # Linux/macOS 用 traceroute
- ping不通但nslookup有结果,说明路由或防火墙拦了ICMP,先别下结论,继续看端口。
- nslookup解析出来的IP和你预期的不一致,直接怀疑DNS被缓存污染或hosts文件写死了旧地址。
- tracert在某一跳之后全是星号,基本可以锁定是中间链路或云上NAT的问题。
第二步:确认端口开没开
ping只证明“路能走”,不能证明“门开着”,用telnet或nc测具体端口:
telnet id.example.com 443
nc -zv id.example.com 443
返回“Connected”说明链路和端口都没问题,问题在应用层;一直卡住直到超时,就是中间有东西在丢包云安全组、机房硬件防火墙、公司出口策略,挨个问。
第三步:检查客户端配置和版本
业内专家指出,客户端侧的配置错误在实际求助案例中占比不低,重点核对三处:
- 地址是否写成了内网IP,而客户端在外网。
- 证书链是否完整,中间证书缺失会导致TLS握手阶段卡死后超时。
- 客户端SDK版本与id服务器协议版本是否匹配,老版本可能不支持新的TLS套件。
第四步:看服务端还接不接新连接
把服务器的连接数和负载拉出来看,常见命令:
netstat -an | grep :443 | wc -l
ss -s
如果状态里大量出现SYN_RECV,说明握手请求到了但没完成,多半是被丢包或半开连接占满了队列;如果是ESTABLISHED接近上限,那是连接池耗尽,需要调大backlog或检查有没有连接泄漏。
内网连接id服务器超时怎么办:三个高频场景
只有部分同事连不上
同一间办公室,有人正常有人超时,先查这几台机器的hosts文件、代理设置和杀毒软件的流量拦截,行业共识认为,终端侧的安全软件对443端口的深度检测,是内网超时的常见诱因之一,把id服务器域名加进白名单,往往立刻恢复。
全员都超时,但服务器本身活着
这时候在服务器本机执行curl -k https://127.0.0.1,本机能通、外面不通,问题一定在中间设备,检查负载均衡的健康检查是否把节点摘了、WAF是否触发了规则拦截、交换机上有没有做端口隔离。
定时任务和脚本批量超时
白天正常、凌晨批量超时,八成是出口NAT的SNAT端口耗尽,大量短连接涌出,端口回收不及时,新连接就分配不到地址,让运维看一下NAT网关的连接数曲线,或者把脚本改用长连接、加连接复用。
id服务器连接超时和账号密码错误,区别在哪
这两件事经常被混为一谈,其实处在完全不同的阶段。
- 连接超时发生在TCP或TLS阶段,用户还没走到“验证身份”这一步。
- 账号密码错误发生在应用层,说明网络完全通畅,服务器已经能读到你的请求体。
分辨方法:抓包看有没有完成三次握手,Wireshark里过滤tcp.port==443,如果只有SYN没有SYN-ACK,就是超时;如果握手完成、返回了401或403,那就是认证失败,去查账号锁定、密码过期、时间戳偏移。
顺带提一句,服务器和客户端时钟相差过大,会导致SAML断言或JWT令牌校验失败,现象有时表现得像“连不上”,校对NTP时间,能省掉不少误判。
云上环境连接id服务器超时:安全组与NAT排查
云服务器上部署id服务,超时原因集中在三处:
- 安全组入方向没放行,只放行了80没放行443,或者源地址写成了单个IP而不是网段,是最常见的手滑。
- 子网路由表缺默认路由,id服务器在私有子网,没有指向NAT网关的0.0.0.0/0,它自己出不去,回包也回不来。
- 网络ACL和负载均衡监听器端口不一致,监听器配了443,后端端口写的却是8080,健康检查一直失败,客户端自然超时。
排查顺序建议:先看负载均衡的健康检查状态,再看安全组,最后抓包,云厂商控制台里的“连接诊断”工具能直接告诉你丢包发生在哪一跳,比手工telnet省事。
找人排查id服务器连接超时收费多少,值不值得
小团队没有专职运维时,通常会考虑外包或厂商支持,业内常见的计价方式是按人天计费,价格跨度不小:远程支持一般按工时算,现场上门还要加差旅;原厂维保客户走工单通常不额外收费,非维保客户则按服务等级报价。
要不要花钱,判断标准看两点:一是问题是否已影响到登录、审批这类核心业务中断;二是内部是否有人能独立完成抓包和防火墙策略查看,前者决定紧急程度,后者决定你有没有议价空间。如果只是单台客户端超时,先用上面的四步自查,大概率不需要付费。
关于id服务器连接超时的常见疑问
连接id服务器超时是服务器宕机了吗?
不一定,而且多数情况不是,宕机时通常表现为连接被拒绝或直接找不到主机,持续超时更像“请求没送到”,优先查网络路径和中间设备,真正判断服务器是否存活,看监控里的进程状态和端口监听,不要只看客户端弹窗。
为什么换了网络环境就不超时了?
说明问题出在原来那条链路上,常见于公司出口做了访问控制、运营商线路对特定端口有限制、或者本地DNS返回了过期IP,换网络能通,就把排查重点放在原环境的防火墙策略、DNS配置和路由表上,服务器侧基本可以排除。
id服务器连接超时会不会是证书过期导致的?
会,但表现通常是TLS握手阶段卡住后超时,而不是连接直接被拒,证书过期、证书链不完整、域名与证书SAN不匹配,都会让握手中断,用openssl s_client -connect id.example.com:443可以看到证书有效期和链完整情况,这是最快的确认手段。
超时的本质是“信息没走完一个来回”,把DNS、路由、端口、证书、连接数这五个点挨个排掉,绝大多数问题都能定位到具体某一跳,下次再遇到,别急着重启,先让命令替你说话。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/808798.html