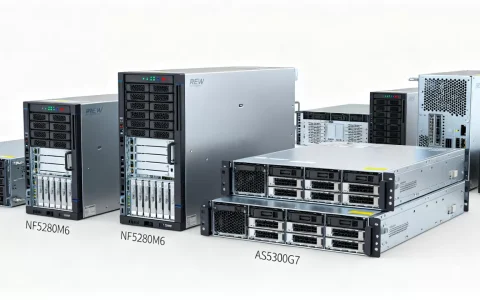
超计算服务器主要分为异构加速型、高密度计算型、大规模集群型和边缘超算型四大类,其中以GPU/NPU异构加速方案为当前主流。
超计算服务器的分类逻辑
超算服务器不像普通服务器那样按品牌就能简单划分,业内专家指出,选型时更核心的逻辑是看计算架构和应用场景。
异构加速型超算服务器
这类服务器是当前AI训练和科学计算的主力,它不靠单一CPU硬算,而是把计算压力拆分给GPU(图形处理器)、NPU(神经网络处理器)或FPGA(现场可编程门阵列)。
- 典型配置:双路CPU加四卡或八卡GPU,PCIe(外设组件互连标准)总线与NVLink(英伟达高速互连技术)互联。
- 适用场景:大模型训练、分子动力学模拟、气象预测。
- 代表产品:浪潮NF5688系列、新华三R5500系列。
- 优势:单机算力密度高,扩展能力强。
- 劣势:功耗高,价格贵,对散热和配套网络要求苛刻。
高密度计算型超算服务器
强调计算核心数最大化,通常采用ARM架构或高主频x86架构,擅长处理大规模并行计算中的整数运算。
- 典型配置:2U(标准机架高度单位)或4U机箱内塞入4至8个CPU节点。
- 适用场景:基因测序、金融风控模型回测、工业仿真中的网格计算。
- 优势:空间利用率高,单位功耗下的计算效率突出。
大规模集群型超算服务器
这已经不是单台机器的概念,而是一整套系统,它通过高速互联网络(如InfiniBand,超高速互联网络)把数千台节点机连接起来。
- 适用场景:国家级超算中心、大型石油勘探数据处理。
- 关键点:考核指标不再是单机性能,而是线性加速比和网络延迟。
- 用户须知:对中小企业和个人开发者来说,直接采购此类系统不现实,更务实的路径是基于云服务商的超算实例,按需租用。
边缘超算型服务器
专门为无人车、智慧工厂、远程医疗手术这类低时延场景设计,体型小,但耐高温、抗震动,支持宽温域工作。
- 特点:IP65防护等级(完全防尘和防喷水),集成了AI推理芯片。
- 常见品牌:研祥、凌华等工控起家的厂商。
国产超算服务器的主流品牌梯队
国内超算服务器市场已形成清晰的三梯队格局,调研机构数据表明,第一梯队依然由浪潮信息、联想、新华三领跑,这三大厂商占据相当一部分市场份额。
| 梯队 | 代表厂商 | 核心卖点 | 目标用户 |
|---|---|---|---|
| 第一梯队 | 浪潮信息、联想、新华三 | 全栈服务、液冷方案成熟、行业定制能力强 | 大型企业、科研院所 |
| 第二梯队 | 中科曙光、宁畅、宝德 | 性价比突出、国产化适配好 | 政企、高校实验室、中型AI公司 |
| 第三梯队 | 多家中小OEM厂商 | 价格灵活、交付快 | 有定制化需求的个人工作室、小型企业 |
超算服务器和普通服务器到底差在哪儿
这是很多初次接触超算服务器的用户常问的问题,行业共识认为,核心差异体现在三个维度:
- 互联带宽:普通服务器的PCIe通道不足以支撑多卡全速通信,超算专用机型内置高带宽交换芯片,解决GPU间通信瓶颈。
- 存储层次:超算服务器普遍配备傲腾持久内存或NVMe(非易失性内存标准)SSD阵列,解决数据吞吐的I/O瓶颈。
- 散热设计:8卡GPU满负荷运行时,单机功耗超过4000W,风冷已无法解决散热问题。目前主流方案是冷板式液冷或浸没式液冷,这比普通服务器的风冷架构复杂得多。
超算服务器的价格构成与采购逻辑
关于超算服务器价格,市场上并没有统一的标价,因为配置弹性极大,一台基础款四卡GPU超算服务器,成本通常在20万至60万元区间,如果升级为八卡顶配并搭载最新一代GPU,价格会上升到120万至200万元。
采购超算服务器时,不应只看硬件成本,以下隐性支出常被低估:
- 机房改造费:液冷机柜需要防漏液监控系统,改造一个标准机柜的成本约为3-5万元。
- 电力增容费:一个包含32台超算节点的小型集群,年度电费支出预计在50万至80万元。
- 运维人力:需要专人负责调度系统、监控GPU温度漂移和网络拥塞。
对于预算有限但短期有算力需求的团队,市场上超算服务器租赁价格也值得关注,租用一台8卡A100服务器的月成本大概在6万到10万元之间,这个价格包含带宽和基础运维,比一次性采购更灵活。
购买前必须确认的三个问题
– 应用是跑训练还是推理? 训练需要更大显存和更高带宽,推理则更看重延迟和吞吐,选错方向会浪费一半预算。
– 软件栈是否兼容? 确认CUDA(英伟达并行计算平台)、PyTorch等框架与服务器固件版本匹配,不少用户买完机器,最后发现驱动不兼容,白白浪费两周时间。
– 供电和制冷设施是否达标? 家用的220V供电无法带动四卡以上机器,实验室需提前铺设380V工业用电。
如何评估超算服务器的真实性能
厂商宣传时常提及浮点运算峰值(TFLOPS,每秒万亿次浮点运算),但真实应用场景里,这个数字的参考意义有限。
更可靠的方法是跑基准测试工具:
- HPL(高性能共轭梯度基准):测试Linpack线性代数性能,用于评估科学计算能力。
- MLPerf:当前AI训练基准测试的事实标准,直接反映模型训练时间。
- STAC-ML:金融超算用户常用的基准工具,模拟真实交易回测场景。
具体操作时,建议要求供应商提供同一测试版本下的实测数据,而不是理论峰值,企业采购负责人应在合同验收条款中写明跑分标准,避免货不对板。
超算服务器交付后的落地部署步骤
拿到机器后,走完以下几步才算真正可用:
- 第一周:完成BIOS(基本输入输出系统)调优,开启Above 4G Decoding(4G以上地址解码)和Resizable BAR(可调整基地址寄存器)功能,这些是GPU性能发挥的前提。
- 第二周:安装调度系统,推荐Slurm(负载调度器),这是超算领域使用率最高的任务调度工具。
- 第三周:测试RoCE(远程直接内存访问),当后续扩展多机集群时,这套网络配置决定成败。
- 第四周:跑通一个完整业务用例,确认数据读写路径无瓶颈。
常见问题解答
超算服务器和GPU服务器的区别是什么
超算服务器是一个更宽泛的概念,GPU服务器只是其中的一种形态,超算服务器更强调整体架构的网络拓扑和存储协同,而GPU服务器更多是指搭载GPU加速卡的服务器单机,在做预算时,超算服务器因为包含更多系统级设计,价格通常比同等配置的普通GPU服务器高出30%-50%。
小团队如何低成本用好超算服务器
除了整机采购,还可关注二手市场中的上一代机型,例如搭载A100或V100的整机,价格往往只有新机的四成,这类机器硬件设计寿命长,换掉老化的风扇和导热硅脂后,运行依然稳定,云服务商提供的按秒计费超算实例也是更经济的替代方案,适合阶段性实验任务,无需操心运维。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/809009.html