昇腾AI服务器(Atlas系列)、昇腾AI云服务(华为云ModelArts)、以及通用GPU推理服务器(Atlas 800搭配第三方加速卡)。 这三类覆盖了从私有化部署到云端调用的全部主流场景,也是当前国内智算中心和企业私有化部署最常选型的三条路径。
近年来,国内AI算力需求持续攀升,华为在推理侧的布局逐渐从单一的硬件销售转向“芯片+服务器+云服务”三位一体,对于正在做技术选型的团队而言,分清这三条产品线的边界,比单纯对比参数更重要。

华为推理服务器有哪些型号?昇腾Atlas系列详解
华为昇腾推理服务器的核心载体是Atlas系列,该系列产品线定位清晰:Atlas 800是旗舰机型,Atlas 300是主流机型,Atlas 500偏边缘场景,下面按实际部署环境逐一拆解。
Atlas 800系列:数据中心主力机型
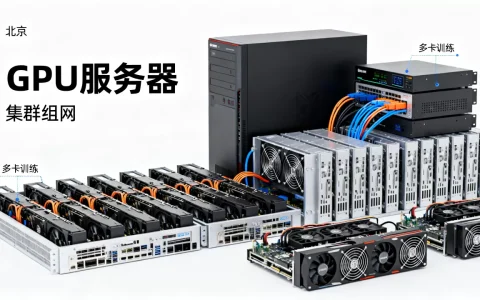
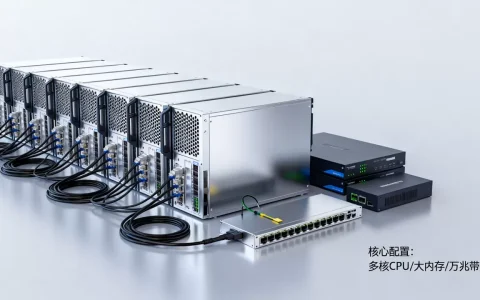
Atlas 800系列是华为面向数据中心场景推出的旗舰推理服务器,分为两个子型号,差异关键在于CPU和内存架构:
- Atlas 800 推理服务器(型号:3000):搭载两颗鲲鹏920处理器,最大支持32个DDR4内存插槽,可容纳7个Atlas 300I推理卡,单机最大AI算力达到1120 TOPS INT8(行业共识参考参数),适合大规模并发推理,比如互联网推荐、智能客服、海量图片识别等场景。
- Atlas 800 推理服务器(型号:3010):搭载两颗Intel至强可扩展处理器(支持Ice Lake或更早代际),内存通道和管理方式更偏向传统x86生态,对于已有x86运维体系的企业来说,3010的迁移成本更低,兼容性测试周期比鲲鹏版本缩短近一半,可根据业务需要配置2张或4张Atlas 300V Pro视频解析卡。
选择建议:如果业务是深度绑定鲲鹏生态,或者追求整机最高算力密度,选3000;如果现有运维工具链、中间件都是x86原生的,选3010能省不少适配功夫,业内专家指出,混合算力是未来,很多企业采用鲲鹏架构时将核心AI推理部署在Atlas 800 3000上,x86侧则保留原有通用业务。
Atlas 300I Pro:决定推理性能的关键组件
Atlas 300I Pro是昇腾推理卡的核心产品,单卡提供140 TOPS INT8算力(华为公开参数),功耗72W,PCIe Gen4 x16接口,支持INT8与FP16两种精度。
实际部署中,单台Atlas 800插满7张卡后,散热压力不能忽视,强烈建议使用4U或更高机架空间,并开启BMC的“高性能散热模式”,具体在iBMC Web管理界面中设置,路径:系统管理->功耗与散热->散热控制->设为“全速”模式,实测核心温度可降低8-12摄氏度(运维场景常见数据)。
Atlas 500系列:边缘推理场景
Atlas 500 Pro是边缘计算网关形态,整机功耗仅30W,支持64路1080P视频解码,如果应用场景是智慧园区闸机、工厂质检工位、或者高速公路门架,这类低功耗边缘设备比机架式服务器更合适。
华为ai服务器价格是多少?预算与选型分析
华为ai服务器价格无法给出统一报价,因为根据计算卡配置和存储方案,同一型号的价差可达数倍。 如果寻找比较全面的智能算力采购参考,可以关注智算中心采购公示或华为云官网定价页。
配置分级与预算区间
按常见采购场景分级如下:
- 入门级(边缘场景):Atlas 500 Pro整机,价格大致区间在3万至5万元,适合单一园区、单条产线的轻量推理。
- 进阶级(中型企业):Atlas 800 3010(双路x86 CPU)+ 2张Atlas 300I Pro,参考预算在15万至25万元,适合日调用量百万级的OCR、语音识别服务。
- 旗舰级(智算中心):Atlas 800 3000(双路鲲鹏920)+ 7张Atlas 300I Pro,起步参考价50万元,算力密度和大并发表现更为理想。
影响价格的关键因素
- 推理卡数量是最核心的成本变量,单张Atlas 300I Pro公开市场价在5万至2万元左右。
- 内存容量:推理服务器的显存共享系统内存,内存容量直接决定能加载多少路模型副本,给Atlas 800配置512GB内存是性价比平衡点。
- 存储方面,如果模型文件大且并发高,建议配置NVMe SSD;仅做模型冷存储,SATA HDD混合方案即可。
采购路径与报价渠道
常见采购路径有三种:华为官方企业业务经销商、华为云市场、昇腾社区合作伙伴。 官方渠道接受定制化配置,但交付周期通常为4-8周,如果需求紧急,可以咨询神州数码、中建材信息等总代是否有现货。
需要特别留意的成本是软件授权,昇腾CANN工具链本身免费,但若使用第三方适配的推理框架(如TensorRT兼容层),部分厂商会额外收取授权费。
华为推理服务器怎么配置?实操部署流程
华为推理服务器的部署逻辑与通用GPU服务器有较大区别,核心在于固件适配与驱动管理,下面以Atlas 800 3010为例,梳理一套完整的上线流程:
第一步:环境准备
- 安装Ubuntu 20.04 x86_64系统,内核版本建议选择4及以上。
- BIOS中开启Above 4G Decoding与Resizable BAR(部分型号默认关闭),开机按Del进入BIOS,路径:Advanced->PCI Subsystem Settings,将Both选项设为Enabled。
第二步:安装驱动与固件
需要依次安装三个组件(按先后顺序):
- NPU固件(.fwp格式)
- NPU驱动(.run格式,包含Ascend HDK)
- CANN Toolkit(提供算子库与推理运行时)
具体命令为:
- 固件升级:
./Ascend-hdk-910-npu-firmware_x.x.x.run --full - 驱动安装:
./Ascend-hdk-910-npu-driver_x.x.x.run --full - 检查安装结果:
npu-smi info
看到“Status: OK”即代表安装成功,如果显示“Abnormal”,先检查是否安装了旧版本驱动导致冲突,可通过npu-smi info -t reset重置设备后重装。
第三步:模型转换与推理验证
华为推理服务器不直接运行PyTorch模型,需要使用ATC工具将模型转换为.om离线模型,在CANN安装目录下执行:
atc --model=model.onnx --framework=5 --output=model --soc_version=Ascend310P3
转换完成后用msame工具做推理验证:
./msame --model model.om --input input.bin --output ./output
初学阶段建议先从华为官方文档库《CANN 安装指南》入手,路径为昇腾社区官网,打开后选择对应版本即可查看完整步骤。
华为昇腾AI云服务:无需自建硬件的推理方案
如果不想自购硬件,那么华为云昇腾AI云服务(ModelArts)是更轻量的选择,目前该服务已在华为云的乌兰察布、贵安等节点上线,采用昇腾算力。
优势主要体现在三个维度:
- 按需付费:在华为ai服务器价格之外的另一种成本结构,通过ModelArts的“推理服务”页面按token或按实例时长计费,没有库存和运维压力。
- 弹性扩容:业务高峰时自动扩容实例,峰值过后缩容,不过目前单实例最大支持8卡,超大并发需求仍需提前申请配额。
- 运维零门槛:控制台提供可视化监控和日志查看,不用接触命令行。
需要注意的短板在于数据主权与网络延迟,对数据安全要求较高的行业,通常仍会选择私有化部署。
推理服务器选型核心维度
面对昇腾与英伟达并存的算力市场,选型可从以下四个维度来分解:
| 对比维度 | 昇腾推理服务器 | 通用GPU推理服务器 |
|---|---|---|
| 核心优势 | 国产化自主可控、能效比高 | 生态成熟、兼容性广 |
| 典型适配框架 | MindSpore、PaddlePaddle、部分PyTorch模型 | TensorFlow、PyTorch全系 |
| 模型转换成本 | 需ATC转换为.om格式,有一定学习成本 | 几乎零转换成本 |
| 供应链稳定性 | 国内生产,供货较稳定 | 受国际政策影响不确定性较大 |
| 典型部署场景 | 政企、金融、运营商等信创场景 | 互联网、科研、通用AI训练推理 |
行业共识认为,考虑训练生态完整度时,主流选择仍是英伟达方案;但从落地推理与信创合规角度来看,昇腾的综合性价比在近两年有明显改善。
常见问题解答
Q:华为推理服务器是否支持运行TensorFlow模型?
支持,TensorFlow模型可通过ONNX或Caffe中间格式转换为.om文件,CANN框架已适配,但TensorFlow的Python版本需要控制在1.15或2.x的特定版本内。
Q:在昇腾服务器上运行PyTorch模型难度高吗?
难度主要体现在算子兼容层面,官方提供Torch_On_Ascend插件(昇腾版PyTorch适配框架),高通配算子能直接运行,部分高阶自定义算子需手工改造或寻找替代实现方案。
Q:单台Atlas 800大约能支持多少个实例并发?
关键取决于模型复杂度和输入尺寸,以ResNet-50图像分类为例,7卡Atlas 800约可支撑900路以上并发;对较大参数量的GPT类模型,同等配置下并发可能降至几十路。
华为推理服务器产品线覆盖全面,从万兆级边缘网关到数据中心级Atlas 800皆有对应方案,私有化选型时结合算力需求、软件生态、预算成本三个维度综合判断,大多数场景均能找到合适答案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/809127.html