服务器硬盘故障并非随机发生,本质上是物理损耗、逻辑错误与外部环境三股力量叠加作用的结果。 把硬盘比作一台24小时不休息的精密唱片机,任何一环出了问题,整台机器都会跟着遭殃,这篇文章直接拆解服务器硬盘”生病”的深层原因,帮你从源头判断问题、降低业务中断风险。
服务器硬盘故障原因排查:先分清物理层还是逻辑层
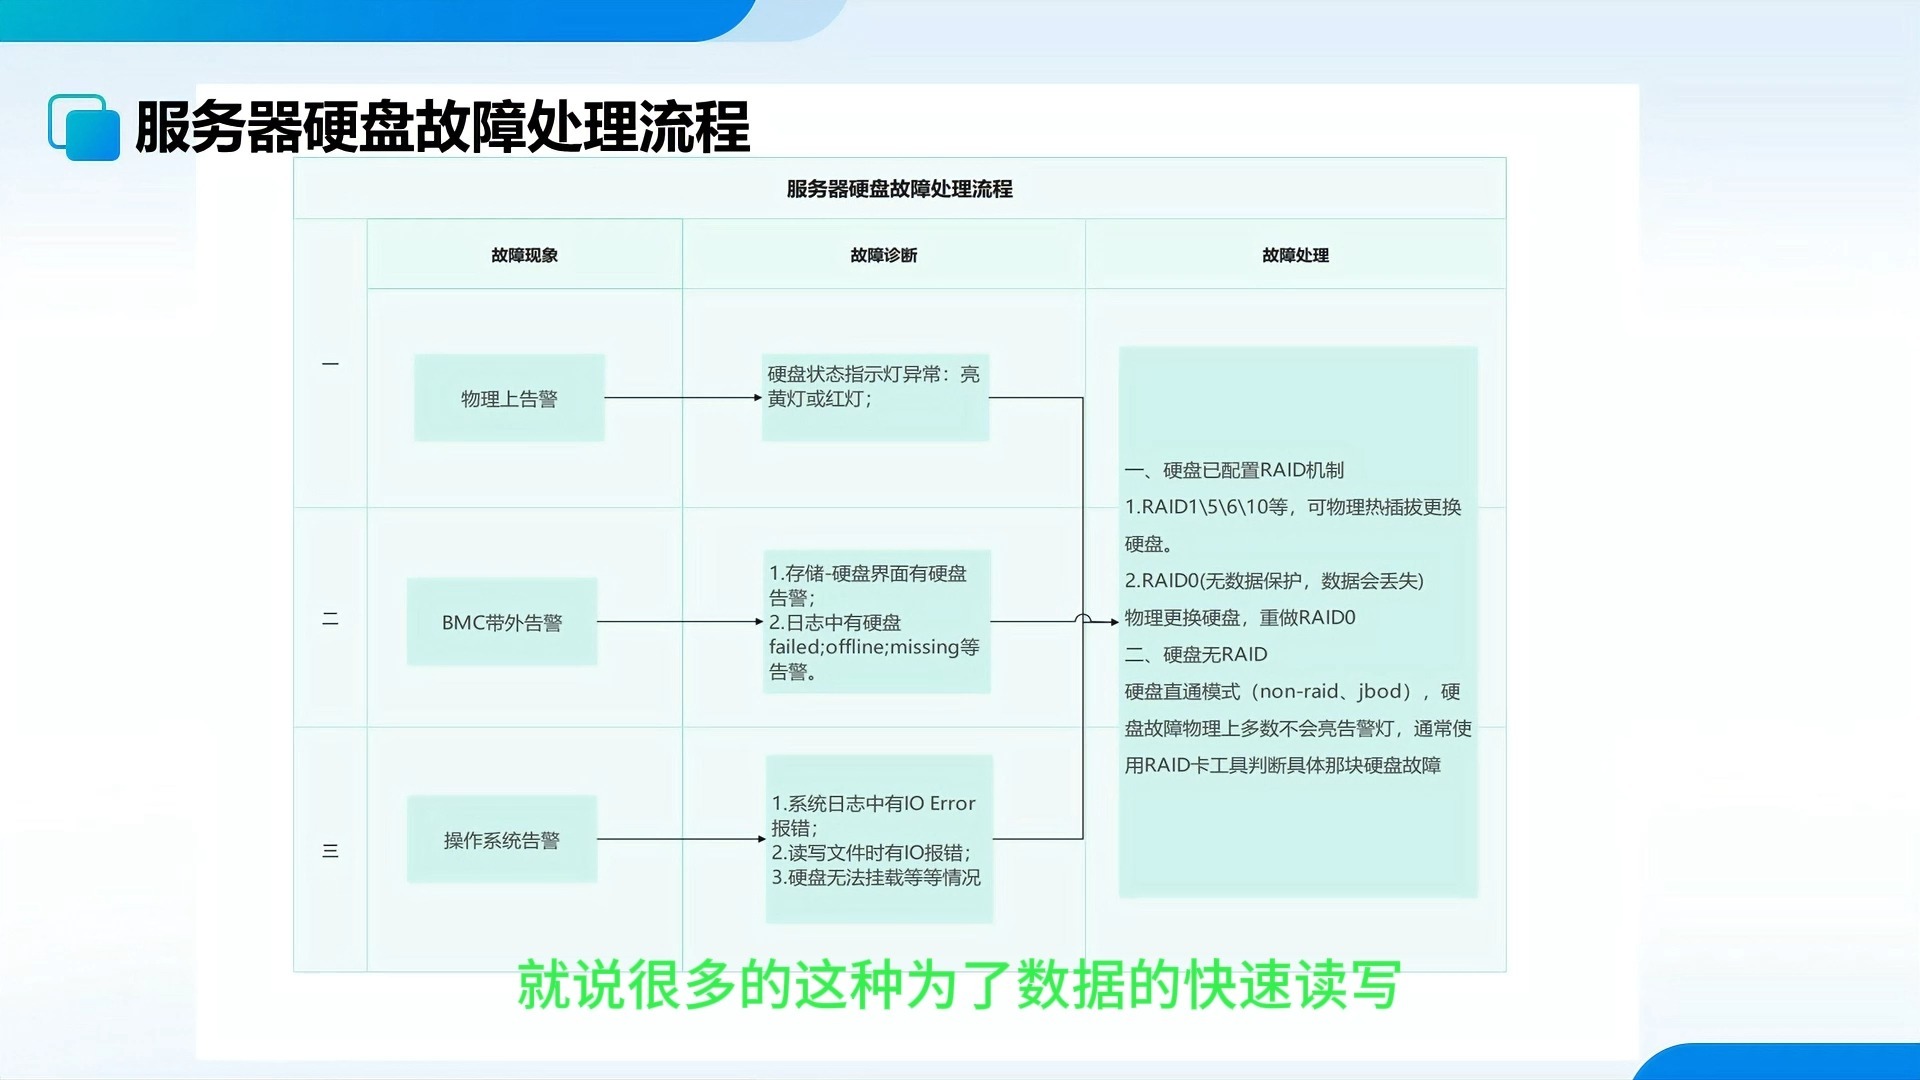
服务器硬盘报错,首先要区分是硬伤还是软伤,物理层故障是硬件实打实的损坏,逻辑层故障则是数据链路出问题但硬件还能用,这个判断决定了备件采购还是系统修复,性价比完全不同。
磁头与盘片:硬盘最脆弱的”关节”
服务器硬盘在读写时,磁头悬浮在高速旋转的盘片上,距离只有几纳米,这个”悬浮”动作对震动极其敏感,行业共识认为,运行中的硬盘一旦受到超过一定阈值的冲击,磁头就可能直接击打在盘片上,造成不可逆的物理坏道。
常见触发场景包括:
- 机柜共振:多台服务器密集安装,风扇转速叠加产生高频震动,日积月累磨损轴承。
- 暴力搬运:在不关机状态下移动服务器,或硬盘托架未固定好。
- 意外跌落:更换硬盘时手滑,哪怕只有十几厘米高度。
这类故障的典型表现是开机异响(咔哒声、刺啦声)、SMART 属性中 Reallocated_Sector_Ct(重映射扇区计数) 持续上涨,一旦出现这个信号,基本宣判了硬盘的死刑,没有修复空间,只有立即更换。
固件与主控:硬盘的”大脑”也会短路
很多人忽略硬盘主控板上的固件程序,固件相当于硬盘的操作系统,负责管理寻道、缓存、坏块映射,如果固件出现Bug或升级失败,硬盘会表现为容量无故变为0、系统无法识别、读写速度骤降。
业内专家指出,近年来越来越多的大容量硬盘故障并非盘片损伤,而是主控芯片过热或固件逻辑紊乱,这类故障的特点是数据本身完好,但硬盘不认盘,送修时优先尝试固件修复比开盘抢救成本低得多。
服务器硬盘坏道是怎么形成的:异常断电的累积伤害
这是逻辑层故障最主要的原因,也是最容易被业务方忽视的杀手。服务器硬盘坏道是怎么形成的,很大程度与供电质量挂钩。
异常断电的”最后一击”
硬盘写入数据时,磁头正在定位,突然断电会导致写入中断,映射表错乱,一次断电可能只是产生小面积逻辑坏道,但频繁的异常掉电会反复撕裂文件系统结构,最终让坏道蔓延成不可读区域。
典型的业务场景是:
- 机房UPS(不间断电源)切换失败,直接黑电。
- 办公楼电路跳闸,没有配置关机策略。
- 人为误触电源键,强制重启。
缓存策略与掉电保护差距
企业级硬盘普遍配备 PLP(Power Loss Protection,掉电保护) 电容,能在断电瞬间将缓存数据写入闪存,但消费级硬盘没有这个设计,在突发断电下丢数据的概率很高,如果服务器用了非企业级盘,坏道形成的速度会明显加快,这点在对比”企业级硬盘和普通硬盘的区别”时尤为突出。
系统崩溃与文件系统损坏的恶性循环
操作系统异常蓝屏或内核崩溃时,文件系统日志未及时落盘,重启后系统自检,UNC(不可纠正错误)路径会被标记,时间长了这些区域演变为逻辑坏道,这种坏道用软件修复(如 badblocks 命令)还有机会救回,但若叠加盘片物理损伤,则修复效果甚微。
机房环境对服务器硬盘的隐形摧残
环境因素看起来不起眼,但长期影响相当可观。服务器硬盘寿命多久往往取决于机房的温湿度控制和空气质量,而非硬盘自身设计寿命。
高温:电子迁移的加速器
硬盘工作温度每升高10摄氏度,电子元件老化速度大约提升一倍,机柜通风不良、空调故障、积灰堵塞风道,都会让硬盘长期在50度以上的高温中运行,高温下盘片热膨胀形变,磁头定位误差增大,写入错误率上升。
湿度与粉尘:腐蚀与摩擦的温床
- 湿度过高(超过80%),主控板焊点氧化,接触不良。
- 湿度过低(低于10%),静电积累,击穿芯片。
- 粉尘堆积在盘体呼吸过滤器上,破坏内部气压平衡。
供电纹波:电压不稳的慢性毒药
机房UPS输出波形不纯净,或者电源模块老化,纹波过大,硬盘电机对供电质量敏感,电压波动会让转速不稳定,写入数据时位置偏移,长期供电质量差的机房,硬盘故障率会显著高于平均值,这个在IDC机房中很常见,但大部分用户把问题归咎于硬盘品牌本身。
常见故障前兆与SMART指标预警
服务器硬盘故障排查不是等盘坏了才动手,而是通过系统日志和SMART数据提前发觉异常,以下指标建议建立周度巡检机制:
| SMART属性ID | 属性名 | 危险阈值信号 |
|---|---|---|
| 01 | Read Error Rate(读取错误率) | 持续攀升不复位 |
| 05 | Reallocated Sectors Count(重映射扇区数) | 超过几十个且继续增加 |
| 09 | Power-On Hours(通电时长) | 超过5万小时需高度警惕 |
| C5 | Current Pending Sector(待映射扇区) | 数值非零即关注 |
| C6 | Offline Uncorrectable(离线无法修正) | 出现即为物理损伤信号 |
在Linux服务器上,直接安装 smartmontools 工具查看这些关键数据:
yum install smartmontools    # CentOS/RHEL系统
apt install smartmontools    # Debian/Ubuntu系统
smartctl -a /dev/sda        # 查看完整SMART信息
重点输出行的含义:
Reallocated_Sector_Ct:已重映射的坏扇区总数,越小越好。Pending_Sector:等待重映射的扇区,如果长期不为零,说明盘片正在劣化。UDMA_CRC_Error_Count:数据线或接口问题,检查连接是否松动。
更换与止损决策:结合成本和业务连续性
故障一旦确认,核心决策是直接更换还是继续观察,这时候服务器硬盘价格会左右部分预算敏感型公司的选择,但更关键的是业务容忍度。
- 如果物理坏道或重映射扇区持续增长:立即更换,没有商量余地。
- 如果通电时间超过5万小时但SMART正常:建议在维护窗口期主动替换,而不是赌它继续运行。
- 如果只是C5数值波动且不再增加:可以热备盘顶替,原盘降级为冷备,但不宜重新做主力存储。
这里穿插一个现实场景:企业在采购二手服务器硬盘时,常因便宜选择大量所谓”拆机盘”,这些盘通电时间普遍在3万小时以上,价格在同容量新盘的三分之一左右,如果业务对数据安全要求高,选择二手盘等于把定时炸弹埋进机柜,若是测试环境或非关键业务,则可以按性价比评估,选购时注意看 通电时间(Power_On_Hours) 和 启动次数(Power_Cycle_Count),这两个数据最直观反映盘的真实使用强度。
Q&A:关于服务器硬盘的高频疑问
服务器硬盘故障前有哪些征兆?
性能下降方面,文件读写速度明显变慢,数据库查询延迟飙升,磁盘IO等待时长超常,声音层面,出现规律性的”咔哒”声或尖锐啸叫,软件层面,系统日志出现 I/O Error 或 Buffer I/O error,并且带有设备节点名,SMART告警则是最直接信号,可以在 /var/log/messages 中通过 smartd 服务自动抓取。
服务器硬盘坏了数据还能恢复吗?
物理坏道导致的数据丢失,恢复难度很大,涉及开盘换磁头、盘片打磨等专业操作,费用在数千到数万元不等且成功率不保证,逻辑坏道或固件丢失导致的数据不可见,借助专业恢复工具或厂商维修渠道,恢复概率相对较高,但行业共识是:最好的恢复方法是备份,而不是找恢复服务,任何情况下,发现异常后应立即停止写入操作,关机断电,避免损坏范围扩大。
企业级硬盘和普通硬盘的区别是什么?
企业级硬盘通常带有震动补偿传感器、掉电保护电容、更高的MTBF(平均无故障时间)评级,固件针对7×24小时连续读写优化,普通桌面硬盘在连续高负载下的故障周期明显更短,在服务器场景中,混用消费级硬盘可能在成本上占便宜,但一旦数据价值超过几十块硬盘的差价,这种选择就没有任何优势。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/809630.html