别再问为啥AI大模型训练极需显卡了,算力就是模型的心脏
AI大模型训练极需显卡,核心原因在于大模型训练本质上是天量矩阵乘法运算,而显卡(GPU)的并行计算架构能将上万次计算塞进同一个时钟周期,效率比CPU高出几个数量级。没有足够的显卡算力,训练一个像样的模型,时间成本会从几周膨胀到几年,这在商业上根本不可行,这种对算力的饥渴,直接催生了“ai大模型训练显卡要求”越来越高这个现实问题。
大模型训练的本质是“算”,不是“存”
很多人以为训练AI是像图书馆一样不断“喂”数据,其实完全不是,训练过程更像是在做一道超级复杂的数学题,模型每看一批数据,就要做一次庞大的矩阵乘法和求导运算,然后更新内部的参数。
- 模型参数规模惊人:从GPT-3的1750亿参数,到如今各类开源模型的数千亿参数,每一次更新都需要计算全部数值。
- 训练数据量巨大:处理几十TB甚至PB级别的文本、图片数据,每个token都要经过数十层网络的矩阵运算。
- 迭代次数繁多:一个模型往往需要看几遍甚至几十遍全部数据,这意味着同样的运算要重复跑几十轮。
行业共识认为,算力是决定大模型训练效率的硬门槛,CPU虽然也能做这些运算,但它的设计思路是“单点极速”,擅长处理逻辑复杂的串行任务,GPU则完全不同,它天生就是“人多力量大”,用数千个计算核心同时算,每一秒能完成的浮点运算次数是CPU的几十倍到上百倍。
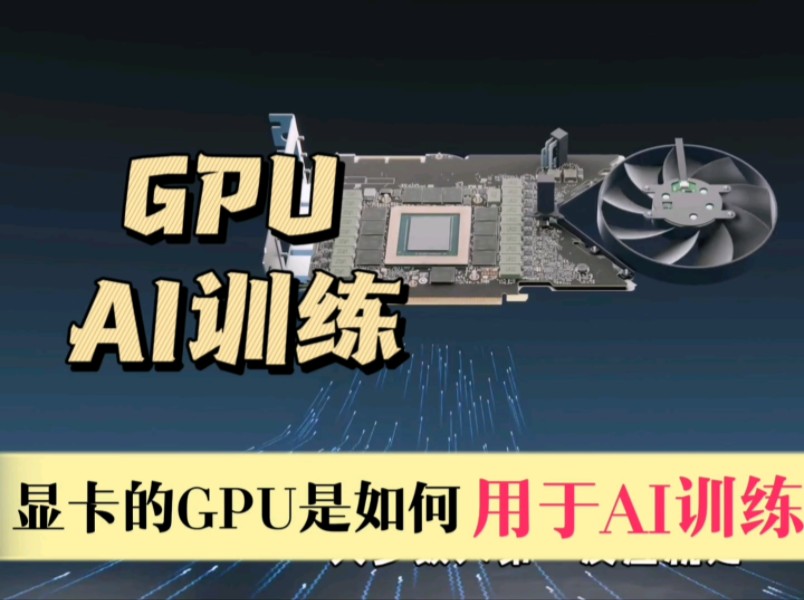
这就是为什么大模型训练现场,你总会看到成排的显卡在工作,每一块显卡都是一座微型超级计算站,Close Up看那些风扇飞速旋转,你就知道它在经历什么样的“脑力运动”。
ai大模型训练显卡要求:不只是算得快,更重要的是显存
你说显卡“算得快”就够了吗?远不止,大模型训练时,模型参数、梯度、优化器状态、中间激活值都要驻留在显存里,显存不够,显卡再多也白搭。
显存容量决定模型能否跑起来
拿一张RTX 4090来说,它拥有24GB显存,听起来不小,但放进大模型训练场景里就捉襟见肘了。
- 一个70亿参数的模型,光是用FP16精度存储参数就需要约14GB显存。
- 训练时还需要额外空间存放梯度和优化器状态,即便是用Adam优化器,这部分开销通常是参数量的2-3倍。
- 加上前向传播产生的激活值,一个70B参数模型全参数微调,单卡跑完全不可能。
这就解释了为什么“大模型训练显卡不够怎么办”成了社区里高频出现的问题,现实解决方案只有两条路:要么堆多卡,用张量并行、流水线并行把模型拆开放到多张显卡上;要么用低秩适应这类参数高效微调技术,把显存占用压缩到一个可接受的范围。
显存带宽决定了运算能不能“喂饱”
光有容量还不够,如果显卡的计算核心运算速度飞快,但数据搬运速度跟不上,核心就得“饿肚子”等数据,显存带宽就是显卡的“食物输送带”速度。
大部分大模型训练场景都是带宽受限的,推动数千亿参数的矩阵乘法,数据搬运时间往往占据整个运算时间的一半以上,这就解释了为什么旗舰级训练显卡,比如NVIDIA的A100、H100,都配备了HBM高带宽显存,带宽可达每秒数千GB,而普通游戏显卡的显存带宽往往只有每秒几百GB,差距悬殊。
算力精度同样关键
训练大模型对精度要求很敏感,FP32精度训练,计算量极大且显存占用高;FP16混合精度是目前主流选择,能在不损失模型效果的前提下大幅提升速度;更激进的BF16在训练超大模型时也更常用。
对于消费级显卡来说,半精度性能往往被弱化,真正能发挥FP16高效算力的,是那些数据中心级加速卡,这就是为什么“ai大模型训练显卡推荐”榜单上,排头的永远是专业计算卡,而非游戏旗舰卡。
ai训练显卡和游戏显卡区别:真不是换了个名字
不少朋友问:“游戏显卡也是显卡,就不能用来训练模型吗?”能用,但效率和稳定性差距很大。
普通显卡用于中小规模模型微调尚可,但大模型从头预训练,两者的表现完全是两回事。
从硬件设计角度,游戏显卡和训练显卡的核心架构有着明显差异。
两者核心参数水平对比
- FP32算力:中高端游戏卡和入门计算卡差距不大,但高端的差距就明显了。
- FP16/FP8算力:专业计算卡往往比同价位游戏卡高出数倍,甚至在FP8上做了专门优化。
- 显存容量:游戏卡通常封顶在24GB,而计算卡从40GB到80GB甚至更高。
- 显存带宽:游戏卡普遍在500-1000GB/s,而带有HBM显存的计算卡轻松突破2TB/s。
- 可靠性:数据中心计算卡支持ECC内存纠错、NVLink高速互联,游戏卡一概没有。
软件生态的隐形壁垒
NVIDIA在专业计算卡上提供了完整的CUDA生态和库支持,比如大规模并行计算库、深度学习加速库等,这些都为相关场景做了深度优化,游戏显卡虽然也能调用CUDA跑模型,但失去了很多服务器级别的功能,例如多卡高速互联,单机多卡训练是常态,而游戏显卡的PCIe通道数量和互联方式,在多卡并行时会出现巨大的通信瓶颈,效率大打折扣。
具体场景下的不同表现
本地部署大模型跑推理时,一张24GB显存的游戏旗舰卡足够用,但当你想微调全量参数或训练更大的模型,硬件局限就显现了,游戏卡驱动也有自己的特殊性,这决定了它在长时间满载训练时的稳定性不如专门的训练卡。
怎么选训练显卡,才能避开硬件选择的三个大坑
面对让人眼花缭乱的显卡型号,怎么选才是最合理的?这里有一个多数情况下的采购思路,可以直接照着参考。
第零步:明确训练规模,别用导弹打蚊子
- 如果要训练百亿参数以下的模型,两张高端游戏卡或一张入门级计算卡,配上多卡并行方案,就能跑起来。
- 如果目标冲击千亿参数模型,那就不需要纠结型号了,大概率要上多路高端计算卡集群,这也不是个人或小团队能承担的了。
- 对于大多数人来说,基于开源模型做领域微调是更实际的操作,这时重点考虑消费级显卡或租用云计算资源。
第一步:看显存,决定模型能不能装上
用一张表来说清楚不同显存规模对应的能力边界:
| 显存容量 | 适合的模型规模 | 典型操作 |
|---|---|---|
| 8GB-12GB | 7B以下模型 | 低秩适应微调、量化推理 |
| 16GB-24GB | 7B-13B模型 | 全参数微调(需优化)、多轮对话部署 |
| 24GB-48GB | 13B-34B模型 | 需要多卡、或采用模型并行 |
| 80GB及以上 | 70B以上模型 | 预训练、全量微调、集群训练 |
第二步:看算力和互联,决定训练快不快
算力决定单卡处理速度,互联决定多卡协同效率,大规模并行训练时,多卡互联带宽至关重要,这也是为什么一些消费级显卡即使堆数量也无法替代专业级计算卡的原因。
第三步:算好经济账,再决定买还是租
买卡只是一次性投入,电费、散热、服务器主板、机箱,都是隐性成本,近年来,许多个人开发者和初创团队更倾向于在云平台上租用计算资源,按小时付费,既规避了硬件折旧,又免去了维护的麻烦,如果你查“ai大模型训练显卡价格”,会发现一张训练卡的价格能顶一台中级轿车,这个预算门槛是现实存在的。
大模型训练到底要多少显卡才能跑起来
这是最实际的疑问,怎么判断卡够不够用?这里有一个行业内常用的经验判断方法。
模型训练显存需求可以粗略地估算为:模型参数量乘以2(参数)+ 模型参数量乘以4到8(梯度和优化器状态),再乘以训练时采用的各种并行策略带来的冗余系数,说白了,模型越大,显存需求呈数倍膨胀。
- 跑70B模型的全参数微调,使用低秩适应技术可以在单张48GB显存的计算卡上操作,但效果和全参数微调存在差距。
- 70B模型全参数微调,需要至少4张A100/H100级别的显卡,张量并行和朋友并行一起上。
- 更大规模预训练,那就是几百上千张显卡的集群了,涉及数据并行、流水线并行、张量并行等多种技术的综合调度。
显卡之外,训练大模型还缺什么
最后说点反直觉的,很多人以为只要显卡够多就万事大吉,真实情况远非如此。
- 数据质量比显卡数量更关键:没有清洗干净的高质量语料,再强的算力也是在垃圾堆里挖矿,效果不会理想。
- 训练框架和工程能力是想象力的上限:别让几百张显卡在等待同步中浪费大半时间。
- 散热和供电常常是瓶颈:满负荷运行的电费可能是普通人一个月工资,散热跟不上也容易降频掉速。
业界对“算力焦虑”这么多关注,本质是因为大家发现,显卡决定了训练的效率上限和成本下限,不是所有问题都能靠堆显卡解决,但几乎所有大模型问题都绕不开显卡这道坎,大模型训练的未来,算力仍是硬通货。
常见问题解答:你的疑问也是大多数人的疑问
Q:ai大模型训练显卡要求很高吗?个人电脑能不能小规模训练?
A:要求确实高,但分场景,个人电脑完全可以跑小规模模型微调,一张24GB显存的游戏显卡,配合低秩适应技术,在开源基座模型上做领域微调基本够用,从头训练一个十几亿参数的模型就不现实了,时间成本和经济成本都太高,真正的门槛在于预训练和全量微调,这些操作即便有高性能显卡,也经常因为显存溢出跑不起来。
Q:游戏显卡和专业计算卡跑大模型,差距到底有多大?
A:差距集中体现在三处:显存容量、带宽和多卡互联,游戏卡封顶24GB,专业卡能到80GB甚至更高,这直接决定了能不能装下更大规模模型,带宽上的差异则让计算密集型任务的处理速度拉开数倍,多卡互联差异更明显,专业卡有NVLink高速互联通道,游戏卡只能靠PCIe总线,“主从通信”耗时会非常可观,多卡扩展效率不高。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/810373.html